
作者|Techno 之王
编辑|靖宇
近期,一款名为 Jev 的 AI 模型在开发者圈引发热议。据悉,Jev 正洽谈 10 亿美元融资,最新估值达 100 亿美元,而距离其推出尚不足 1 个月。
与常规大模型不同,Jev 不生成文本、不进行对话或编写代码,而是接收数据与结构化问题,返回类型化答案与校准概率值。其开发商 TypeSafe 将其定义为「System One 模型」。9 月 15 日,Jev 早期访问版发布,公司同时宣布获 DCVC 领投的 4000 万美元种子轮融资,估值 2 亿美元。数据显示,在分类任务上,Jev 速度比 GPT 系列快约 193 倍,成本低约 445 倍。
然而,Jev 背后真正的价值在于其创造者 Diogo Almeida 的行业判断。Almeida 曾在 OpenAI 工作近四年,是 GPT-4、ChatGPT 及 RLHF/InstructGPT 等核心论文的合著者,可谓「后训练」概念的奠基人之一。在 Jev 发布前六周的 AI Engineer 大会上,他发表了题为「What's Next After RLHF?」的演讲,直言 ChatGPT 与 Claude Code 属于同一时代,并断言行业终将把 RLHF 时代视为一段「奇怪的弯路」。
以下是其演讲核心观点的精编摘录:
- 「下一个时代不是 Claude Code 时代。ChatGPT 和 Claude Code 属于同一个时代。」
- 「为什么所有 LLM 都需要人类在回路中?因为我们把人类放进了回路里。」
- 「无论模型有多错,它都会看起来是对的。」
- 「我们只是在自动化『写软件』,但软件本身的表达力并没有变。」
- 「原始的 Scaling Law 是错的。」
01 「黑 ChatGPT 的人」:OpenAI 前核心成员的反思
我是 Diogo Almeida,今天探讨的主题是「RLHF 之后是什么」,更准确地说是「ChatGPT 时代之后是什么」。提示一下:下一个时代不是 Claude Code 时代,ChatGPT 和 Claude Code 属于同一个时代。

看看到底是谁在黑 ChatGPT|图片来源:Youtube
作为 OpenAI 多项重磅论文(包括 GPT-4、ChatGPT、RLHF/InstructGPT)的合著者,我对「后训练」概念非常熟悉。但我也是 OpenAI 内部少数公开批评 ChatGPT 的人。ChatGPT 是一款改变世界的产品,但其局限性同样明显。当前 AI 领域的诸多现象,均可追溯至我们当初设计 ChatGPT 算法时的一些决策。
02 AI 领域现状:极度乐观与极度悲观的撕裂
当前 AI 领域存在两个极端阵营。阵营一认为 AI 进展神速,各项基准测试碾压人类,自主运行时间呈指数级增长;阵营二则认为 AI 进展不顺,本质是泡沫和循环融资,最终只产出了聊天应用,所谓的「颠覆性革命」已降级为「具有 B2B SaaS 价值」。
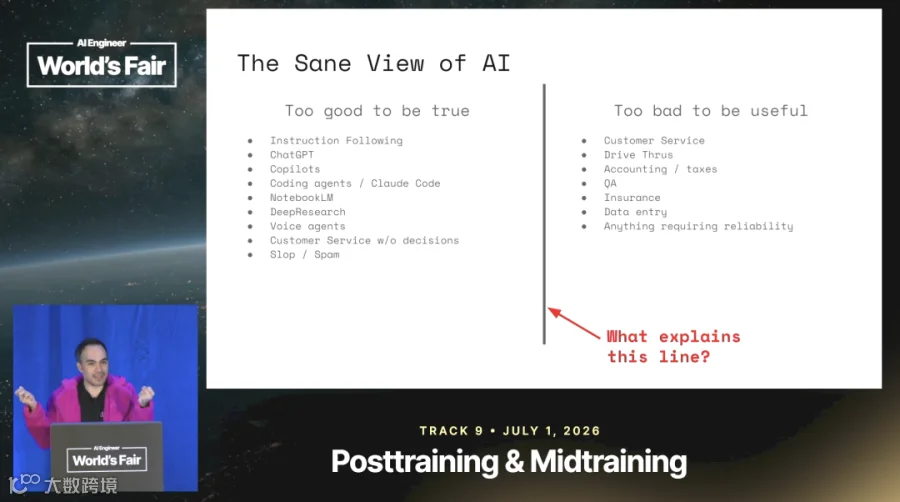
对当下 AI 持有对立观点的两个阵营|图片来源:YouTube
两个阵营都有确凿证据,唯一的共识是:AI 现在很疯狂,但原因截然不同。一个反常的现象是,AI 能解决未解的数学难题,却无法胜任客服决策等看似简单的任务。这种现状亟需一个合理的解释。
03 核心分野:Assistance(辅助)与 Automation(自动化)
答案在于任务目标的不同。左侧(AI 擅长的任务)本质是「人类在环(human-in-the-loop)」任务,目标是取悦回路中的人类。例如 Claude Code 的核心目标不是让代码跑起来,而是让人类满意。右侧(AI 不擅长的任务)目标是去除人类,理想状态是后台静默运行,成为无需人工干预的遗留软件。
这就是 Assistance 与 Automation 的分界线。
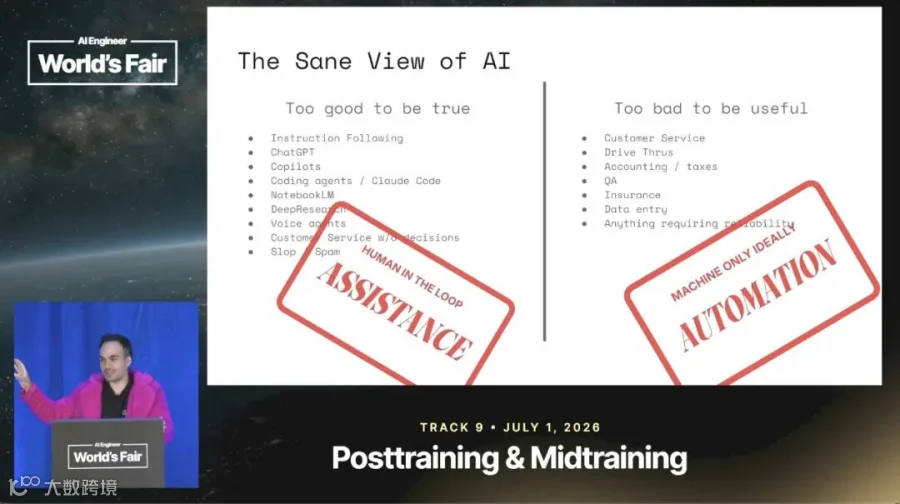
对于 AI 看法的本质是对于 AI 功能定位的不同|图片来源:YouTube
第一课:今天基于 RLHF 的 AI,在处理「人类在环」的辅助任务时表现优异,但无法胜任真正的自动化。因此,企业通常不让 AI 做有业务风险的决策,这导致了当前 AI 应用的诸多妥协。
04 深度剖析:RLHF 的先天缺陷
RLHF 是 ChatGPT 背后的算法,也是当前绝大多数 LLM 的训练范式。其本质分为两步:收集人类偏好,优化人类偏好。这直接回答了「为什么所有 LLM 都需要人类在回路中」——因为算法的目标就是优化人类偏好,而非让软件自主运行。
正因如此,「过度承诺」是 RLHF 的设计特性(feature),而非缺陷(bug)。研究表明,RLHF 模型在人类偏好和实际结果间始终存在差距,因为其首要目标是讨好人类。例如,当输入一段放屁音效并询问评价时,ChatGPT 会一本正经地称赞其为「诡异的氛围感作品」。

当模型不确定时,RLHF 会驱动其选择讨好人类。这对辅助(Assistance)场景有效,但在自动化(Automation)场景中,我们需要的是模型完全不在乎人类,以校准的方式准确执行任务。
第二课:当前 AI 被设计用于辅助,通过优化人类偏好实现。其后果是:无论模型实际有多错,它表面上都会看起来是对的。这是行业陷入自动化困局的根源。
05 为什么 Claude Code 不是下一个时代?
RLHF 之后是什么?即 Assistance 时代之后是什么。
为什么不是 Claude Code?因为 Claude Code 仍属于 Assistance 时代,仍基于 RLHF。如果它是纯 RLVR(基于可验证奖励的强化学习),其表现形态将截然不同。当前模型在 Agentic(智能体化)方面表现强大,但依然会偏离自动化核心需求,因为 RLHF 和 RLVR 都在拉扯,却都不触及真正的 Automation。

因此,Assistance 之后的逻辑答案只有一个:真正的 Automation。
06 软件行业的停滞:我们需要「更聪明的软件」
软件极具商业价值,但最荒谬的是,自 2019 年以来,SaaS 软件的基本形态几乎没变。LLM 时代 SaaS 的唯一改变,仅仅是在界面上加了一个聊天机器人。
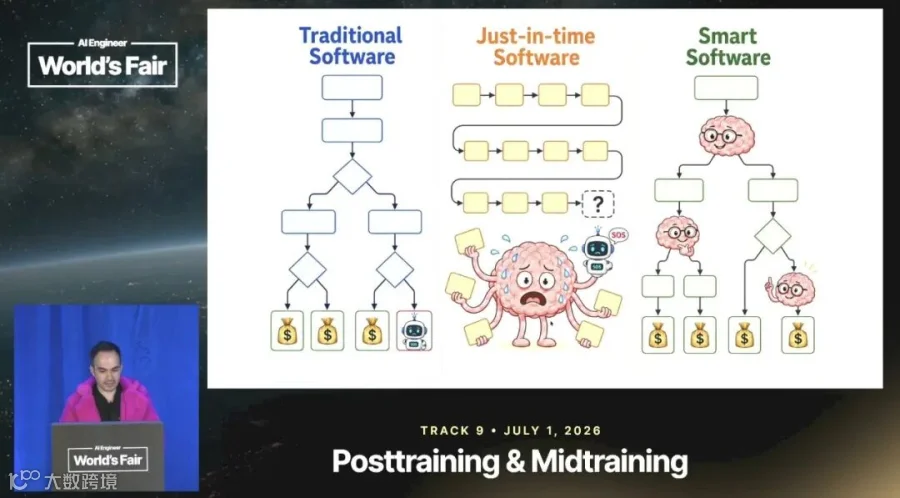
这完全符合 AI 作为 Assistance 的定位。早期 AI 先驱曾期待软件会变得更聪明,而不仅仅是编写成本更低。我不满足于「即时生成的软件(just-in-time software)」,我渴望的是「更聪明的软件」。B2B 软件的基本构建块为何停滞不前?
真正的 Automation 并非完全替代人类的所有工作,而是将那些极其机械、可被清晰定义规则的简单任务交由计算机近乎免费地反复执行。遗憾的是,我们现在只是在自动化「写软件」的过程,软件本身的表达力并未提升。这是当今科技界的一大悲剧。
07 展望下一个时代:TypeSafe 的使命
第三课:我坚信,整个行业终将把 RLHF 时代视为一段未曾预料到的「奇怪弯路」。未来的 AI 将服务于 Automation,我们将拥有更聪明的软件,真正繁杂的工作会被自动化。而目前,LLM 真正自动化的工作量几乎为零。
这正是 TypeSafe 致力于解决的问题:如果 AI 技术栈从一开始就为可靠性和 Automation 而设计,一切将会怎样?我们即将发布全新产品,给行业一个预告:原始的 Scaling Law 是错的。
08 现场 Q&A 精选
Q:如果在预训练阶段加入分类器头(如 Yoshua Bengio 建议)会怎样?
A:预训练本身是伟大的成就,问题在于我们如何挖掘这些智能。幻觉是优化人类偏好的固有产物。奖励模型中存在不对称性,鼓励模型丢弃某些模式并表现出盲目的自信,因为奖励模型很容易惩罚模型的不自信。
Q:你们做的是 RLVR 吗?
A:绝对不是。这是一种全新的范式。RLHF 优化人类偏好,RLVR 优化纯正确性的对数错误率,而我们在做第三件事:优化校准的决策能力,将预训练模型的智能直接转化为真正有用的软件。就像指令遵循最初出现时一样,真正新的后训练范式初见时完全陌生,事后看却理所当然。
Q:你对 Rich Sutton 的「Bitter Lesson(苦涩的教训)」怎么看?
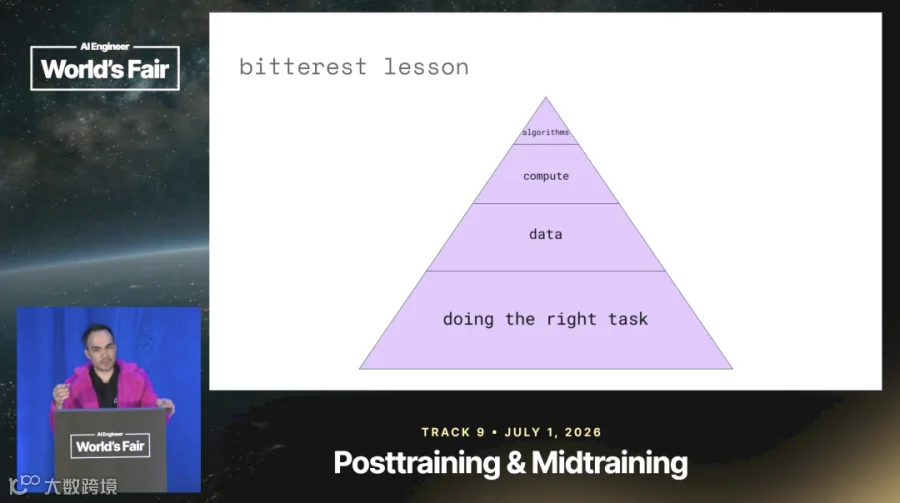
A:Bitter Lesson 认为算法比计算更重要,这在游戏里成立,但在现实中不成立。我认为完整的层次是:数据比算力重要,而做对的任务比数据重要得多。
*头图来源:TypeSafe
还是「自动化」重要?