


AI眼镜负责感知现场,而浏览器、登录状态及任务进度则交由云端处理。9月24日,Meta宣布未来几个月将把个人智能体Muse接入AI眼镜,实现商品识别与自动化任务执行。此前于9月8日发布的Muse展示了其后台机制:它运行于一台持续存在的专用虚拟机中,即使用户关闭App仍能后台工作。这一模式改变了资源调度节奏,算力按需步骤调用,内存与存储持续保留用户的任务状态。
01 | 关闭App后任务持续运行的底层逻辑
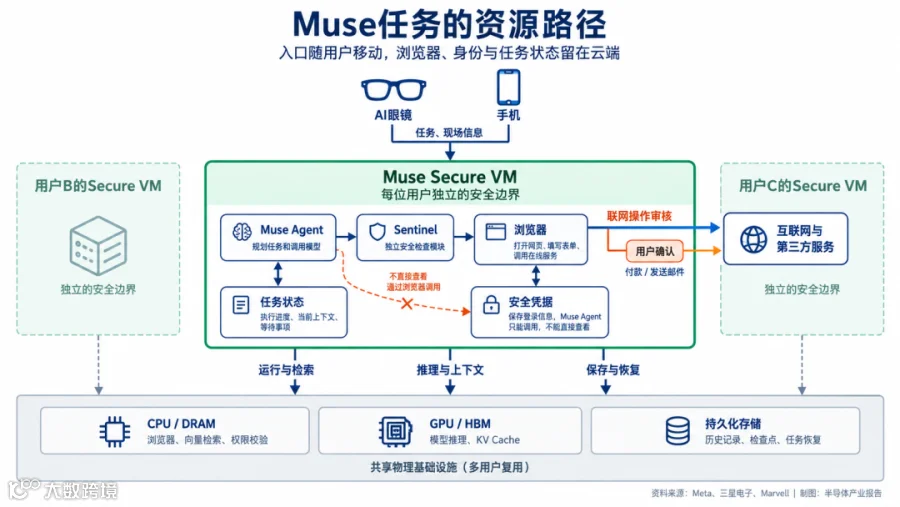
常规单次聊天请求完成后,推理算力即可释放给下一批任务。但Muse在执行旅行预订、账单协商或购物等长任务时,需打开网页、填写表单、等待结果并安排下一步。得益于Muse Secure VM为每位用户提供的隔离云端环境,内置浏览器并保存数据、凭据与执行进度,用户离开App后任务仍能在流程中暂停与恢复。此外,系统层隔离出的Sentinel代理负责审核联网操作,涉及邮件发送或付款等敏感动作需用户二次授权,确保Muse调用凭据时无法获取密码与支付信息。该虚拟机承担了浏览器运行、身份隔离与任务续跑的核心功能,使服务器处理的对象从单次输入输出升级为可暂停、等待和恢复的连续流程。
图注:Meta官方Muse演示视频画面,Muse使用浏览器执行在线购物任务
来源:Meta官网
02 | 智能体任务的“四类记忆”与资源调度
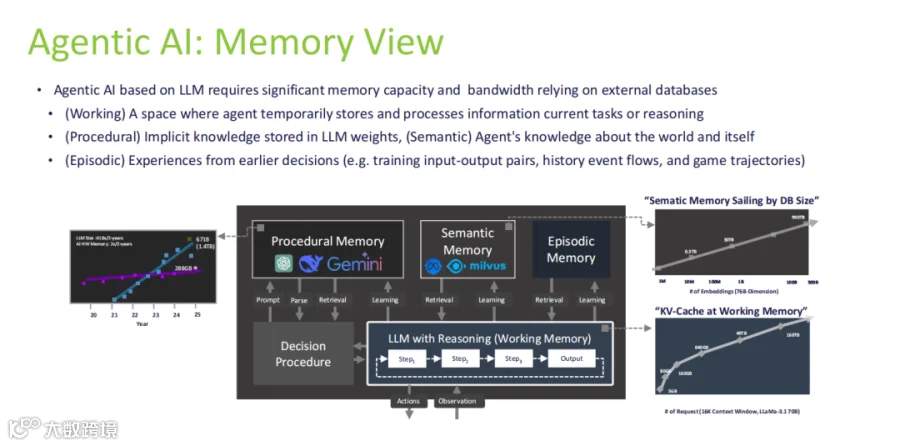
长任务不仅调用模型权重,还需保存用户资料、当前上下文及历史记录。参考三星与Marvell的研究,智能体记忆分为四类:程序记忆(提供模型能力)、语义记忆(保存外部知识)、工作记忆(维持当前推理)和情景记忆(记录历史交互)。
图注:Muse任务的资源路径。AI眼镜或手机连接Muse Secure VM,虚拟机内部包括浏览器、Sentinel和任务状态,底层调用CPU/DRAM、GPU/HBM与持久化存储
依据Meta、三星电子与Marvell资料整理
在通用智能体架构中,模型权重主要依赖GPU HBM;向量索引与用户知识库占用CPU DRAM或CXL扩展内存;KV Cache根据容量和时延在显存与主机内存间调度;历史记录则存入数据库和持久化存储。任务运行越久,需保留的状态越多,服务器在生成Token的同时,必须将数据合理分配至各内存层以便下一步推理时及时取回。
图注:Agentic AI: Memory View,智能体的程序、语义、情景和工作记忆
来源:三星电子、Marvell《Heterogeneous Memory Opportunity with Agentic AI and Memory Centric Computing》
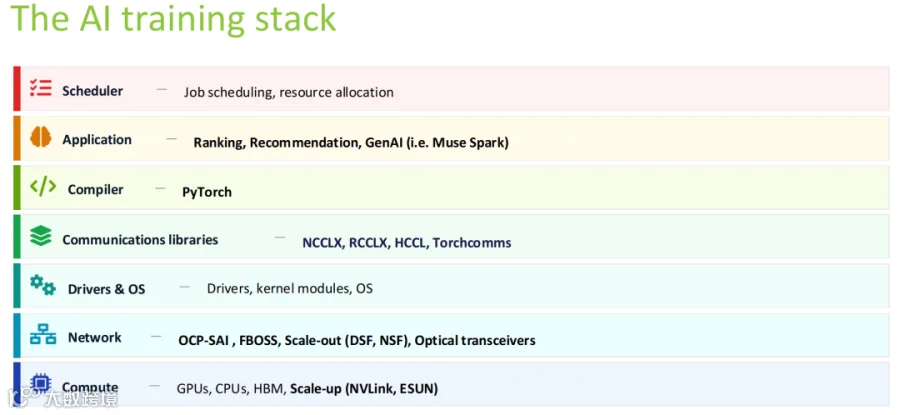
在训练环境中,Meta将Muse Spark置于应用层,向下连接调度器、编译器、通信库、驱动、网络及底层GPU/CPU/HBM,完善了模型调用与物理硬件之间的层次衔接。
图注:Muse Spark位于应用层,下方连接调度器、编译器、通信库、驱动、网络以及GPU/CPU/HBM
来源:Meta《High Performance at Scale and Reliability by Design: Operating META’s Largest AI Clusters》
03 | CPU深度参与推理链:浏览器与向量检索
在智能体任务中,GPU主导模型计算,而CPU负责运行浏览器、解析网页、校验权限、连接工具及查询向量数据库。每步执行后,结果写回上下文交由模型决策,形成CPU、GPU与内存的协同接棒。
图注:CPU执行向量检索并容纳大规模索引

来源:三星电子、Marvell《Heterogeneous Memory Opportunity with Agentic AI and Memory Centric Computing》
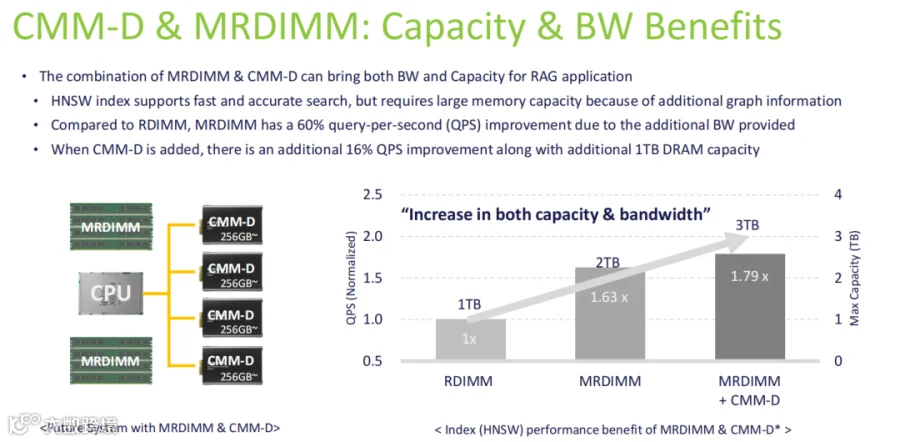
向量检索的性能首先受容量和内存带宽限制。测试显示,服务器内存从RDIMM升级至MRDIMM后,查询吞吐量提升约60%;引入CMM-D将系统内存从2TB扩至3TB,吞吐量再提升16%。随着个人资料与长期记忆的增加,CPU侧内存容量直接决定了智能体信息检索的速度与效率。
图注:MRDIMM与CMM-D提高容量和查询吞吐量
来源:三星电子、Marvell《Heterogeneous Memory Opportunity with Agentic AI and Memory Centric Computing》
04 | 长上下文推理与KV Cache的内存优化
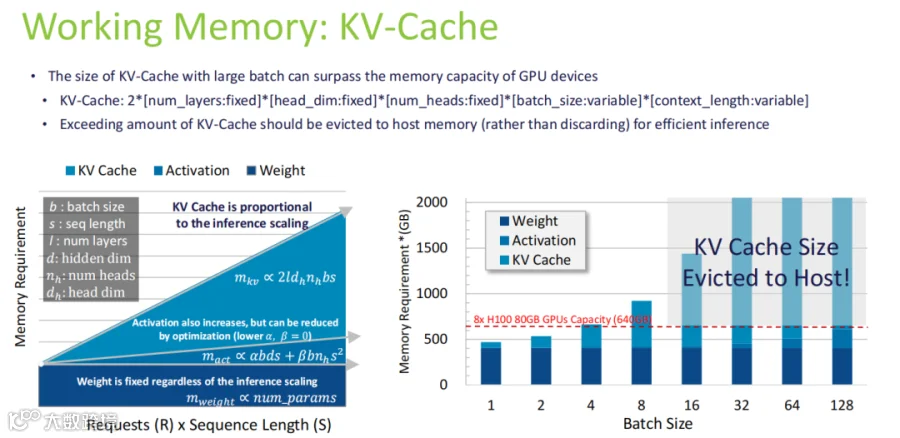
Muse在运行中不断将网页内容、工具返回值和中间判断加入上下文,导致KV Cache随上下文长度、并发批量和模型规模急剧增长。高带宽的HBM容量受限,而DRAM和CXL虽能容纳更多数据,但存在传输延迟。
图注:KV Cache随上下文和批量增长
来源:三星电子、Marvell《Heterogeneous Memory Opportunity with Agentic AI and Memory Centric Computing》
在Llama 3.1 405B、128K上下文的演示中,完整转移KV Cache需通过CXL搬运约1TB数据;而采用CXL-PNM技术在内存侧预先筛选所需数据,可将传输量降至0.25TB,性能大幅提升7.3倍。这表明,保留高频状态、迁移低频状态以及在靠近内存侧进行数据预筛选,是优化长任务KV Cache的关键工程方向。
图注:在内存侧筛选KV数据以减少传输

来源:三星电子、Marvell《Heterogeneous Memory Opportunity with Agentic AI and Memory Centric Computing》
05 | 决定云端算力需求的三大核心指标
同一项任务在模型决策(调用GPU)、浏览检索(占用CPU)及等待网页或用户确认(保留状态)三种状态间切换。平台需在等待期释放计算资源,同时保留充足的内存与存储以供任务迅速恢复。
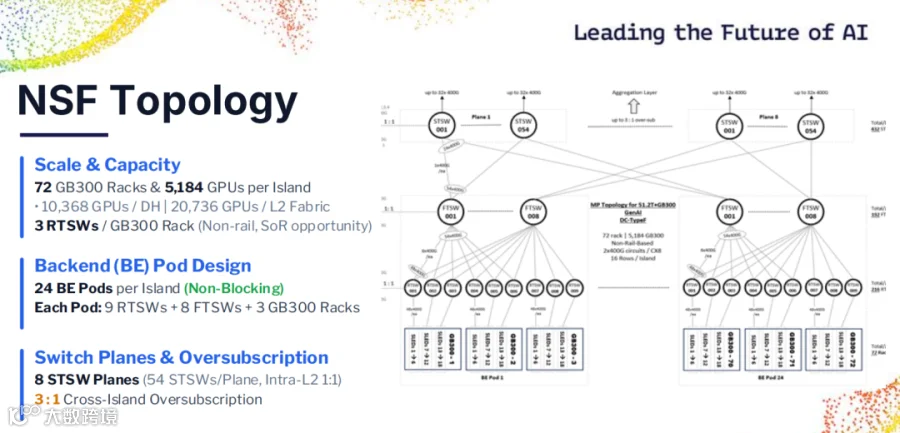
Meta公开的Prometheus训练集群将72个GB300机架组成包含5,184个GPU的island,4个island接入L2网络共计20,736个GPU。尽管训练集群规模庞大,但Muse的实际部署密度尚未公开。对于基础设施团队而言,硬件增量需求主要取决于三个核心数字:后台任务并发量、单任务保留的状态规模,以及单台物理服务器对虚拟机的复用率。
图注:Prometheus计算资源池,72个GB300机架组成5,184 GPU的island,4个island接入L2 fabric后合计20,736个GPU
来源:Meta《Scaling AI Infrastructure Across DC and Beyond: Meta’s Journey with NSF and BAG》
Meta所述的“专用”主要描述安全边界。按通用虚拟化方案,多台隔离虚拟机可部署于同一台物理服务器,复用率越高,单批硬件承载的用户越多,但频繁冻结和恢复会增加状态搬运与启动延迟。个人智能体正将推理过程从单次请求延伸为持续执行,云端平台未来的优化重心将是加快Token生成速度并压低状态保留成本,从而实现任务的高效暂停与无缝恢复。