

北京大学计算机学院张铭教授Dlib组2篇论文入选 NeurIPS 2026
近日,人工智能与机器学习领域顶级会议 NeurIPS 2026 放榜,有2篇来自北京大学计算机学院数据所张铭教授 Dlib 实验室的高水平论文成功入选。NeurIPS 2026 会议将于2026年12月在澳大利亚悉尼举行,并同期在美国亚特兰大和法国巴黎设立卫星会场。
论文1: AlphaPROBE: Alpha Mining via Principled retrieval and on-graph Biased Evolution
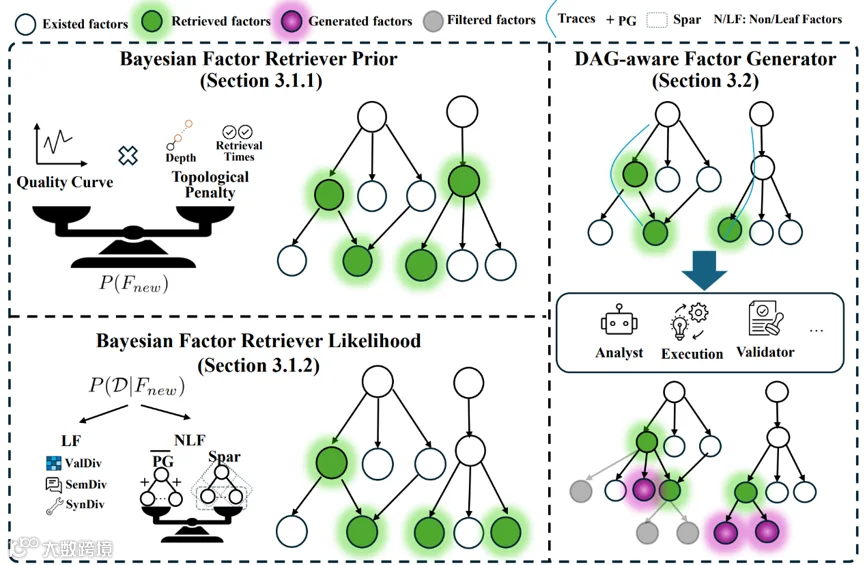
通过 Alpha 因子挖掘提取有效信号,是量化金融中的一项基础性挑战。现有自动化方法主要遵循两种范式:一类是解耦式因子生成,将每次因子发现视为彼此独立的事件;另一类是迭代式因子演化,侧重于局部的父子因子迭代优化。然而,这两类范式都缺乏对因子演化过程的全局结构性认知,往往将因子池视为无结构的集合,或仅关注相互孤立的单一演化路径,从而造成重复搜索以及优化资源分配效率低下。
为解决上述问题,我们提出 AlphaPROBE,一种将 Alpha 挖掘重新表述为有向无环图上的策略性导航过程的框架。AlphaPROBE 将因子建模为图中的节点,将因子间的演化关系建模为边,从而将因子池视为一个动态且相互关联的演化生态系统。
论文2: MindLoom: Composing Thought Modes for Frontier-Level Reasoning Data Synthesis
尽管大语言模型在推理能力方面已经取得了显著进展,但如何系统性地构造前沿难度水平的推理数据,仍然是一项具有挑战性的问题。现有的数据合成方法通常难以显式刻画决定问题难度的结构性因素,因此容易出现数据多样性不足以及难度控制不稳定等问题。
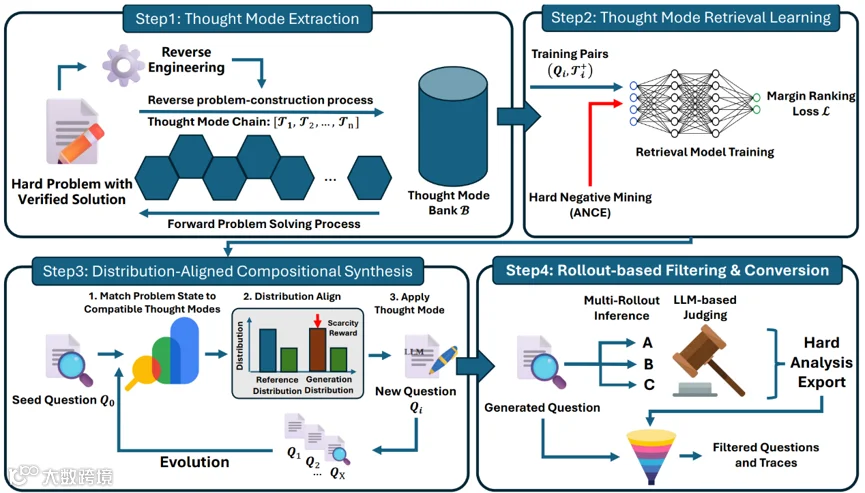
在本文中,我们认为,推理问题的难度来源于一系列原子化知识—推理变换的累积,并将这种基本变换单元称为思维模式。基于这一视角,我们提出 MindLoom,一种通过组合式思维模式工程合成前沿难度推理数据的框架。
给定一组具有已验证正确解答的高难度问题,MindLoom 首先将其解答分解为一系列思维模式链,从而揭示每个问题背后的构造逻辑。随后,框架训练一个检索模型,用于将当前问题状态与相匹配的思维模式进行对应,从而为数据合成过程中“应当引入何种推理挑战”提供指导。
在新问题生成阶段,MindLoom 从种子问题出发,迭代地应用检索得到的思维模式,对问题进行组合式构造;同时采用分布对齐采样,以促进对更加多样化推理模式的覆盖。最后,框架通过一个基于 rollout 的判别阶段对生成问题的难度进行标注,并为其中判定为正确的回答提供监督信号,用于后续的监督微调(SFT)。
我们在 9 个基准上对 MindLoom进行了评测,这些基准涵盖 5 个 STEM 学科以及 4 类数学推理任务,并覆盖多个不同模型家族和参数规模。实验结果表明,在所报告的各项基准上,使用 MindLoom 生成数据进行微调后的模型,相比原始基础模型、知识蒸馏方法以及基于外部数据的基线方法,均能够取得稳定的性能提升。
消融实验进一步验证了框架中各个组件的独立贡献;进一步分析还表明,MindLoom 在保持有效难度控制的同时,能够覆盖较为广泛的推理模式。
本文的作者包括申海洋(北京大学), 郭泰安(北京大学,导师为张铭教授),陈炫中(清华大学), 刘牧耕(北京大学), 谢思雄(北京大学), 石卓凡(北京大学), 潘重阳(北京大学), 钟思琪(北京大学), 王国庆(北京大学), 张铭(北京大学, 通讯作者), 马郓(北京大学, 通讯作者).