

用 CPU 跑大模型的人,几乎都会经历一种奇妙的“冰火两重天”:
当你用一台 8 核 CPU 跑混合专家模型(MoE,例如总参数 30B、单字激活约 3B 的 Qwen3-30B-A3B,Q4 量化约 18GB)时,一旦模型开始生成回答,屏幕上的字像打字机一样以每秒 15 到 25 个 Token 的速度飞快吐出,体验出奇地流畅。
但只要你稍微给它喂一段稍微长点的背景材料——比如一段 4,000 字的技术文档或长对话上下文——整台机器就会陷入长达半分钟甚至近一分钟的死寂。前 20 到 40 秒,终端没有输出任何内容;8 个 CPU 核心全部被占满轰鸣,直到把这段 Prompt 艰难读完,才吐出第一个字。一次请求总耗时往往要 30 到 60 秒以上。
为什么 CPU 跑 MoE 会出现“读提示词像蜗牛、吐字却飞快”的极端割裂?除了 MoE,大模型世界还有哪些截然不同的架构类型?CPU、NVIDIA 显卡、苹果的统一内存 GPU 以及手机电脑里常提的 NPU,各自到底适合干什么?如果手头有一台 32GB 内存的 Apple Silicon Mac mini,该如何将它压榨到极限?
今天我们顺着这几个具体的工程问题,拆透本地大模型的算力物理法则。
1. 物理真相:为什么 CPU 跑 MoE 会“生成如飞、读 Prompt 如龟”?
要理解这个现象,首先必须把大模型的推理过程拆成两个物理特性完全不同的阶段:输入预填充(Prefill) 与 逐字解码(Decode)。
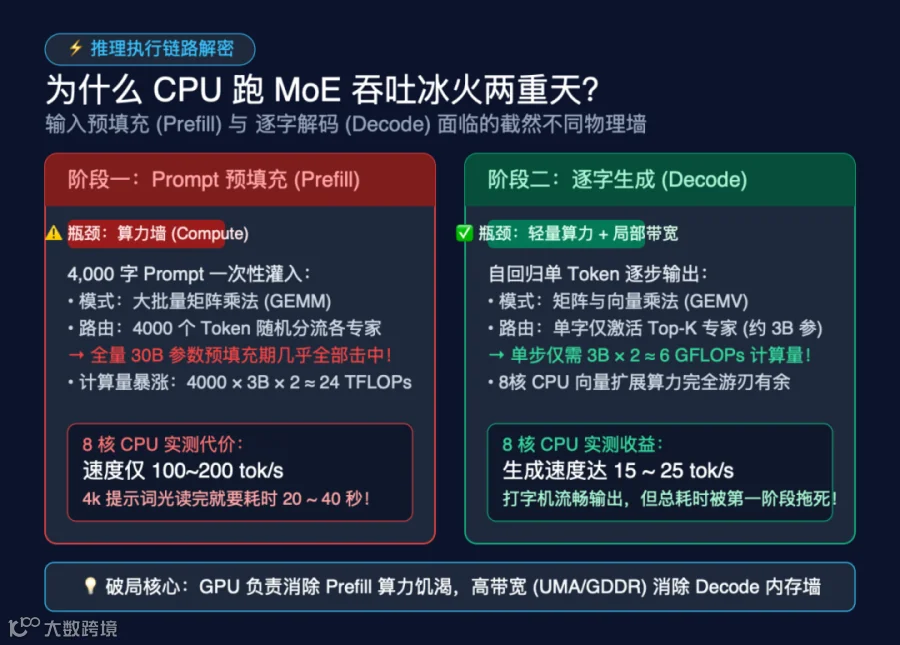
Prefill 与 Decode 物理瓶颈对比
阶段一:Prompt 预填充(Prefill)—— 算力受限(Compute Bound)
当你把一段 4,000 字的 Prompt 扔给模型时,系统需要一次性计算所有输入 Token 之间的注意力权重,并把它们缓存为 KV Cache。
在这个阶段,计算模式是批量的大矩阵乘法(GEMM - General Matrix Multiply):
专家全量激活:虽然 MoE 模型对单个 Token 只激活 Top-K 个专家(例如 30B 里只激活 3B),但 4,000 个 Token 包含各种各样的语义,它们在网络深层会被路由到不同的专家头上。对于整个序列而言,几乎所有 30B 的参数在这一轮预填充计算中都要被调用。
计算量暴涨:4,000 个 Token 经过激活网络的理论浮点运算量约为:

大模型架构技术图谱与硬件适配
8 核现代消费级 CPU 即使拉满 AVX-512 或 AMX 向量扩展,其实际持续密集矩阵乘法的算力通常也只有几百 GFLOPs 到 1 TFLOP 左右。要啃完这 24 TFLOPs 的计算量,物理上就需要 20 到 40 秒。
因此,Prefill 阶段的瓶颈纯粹是算力受限(Compute Bound)。CPU 缺乏 GPU 那种成千上万个并发计算核心,只能在这个阶段以 100~200 tok/s 的极慢速度苦苦吞咽。
阶段二:逐字解码(Decode)—— 带宽与轻量算力受限
一旦 Prompt 被消化完毕,模型进入逐字吐出回答的阶段。此时每次只处理 1 个 Token,计算模式变成了矩阵与向量乘法(GEMV - General Matrix-Vector Multiply):
单字计算量极小:只计算当前这 1 个 Token,路由门控只会激活固定的 2~3 个专家,其余专家直接休眠。单步计算量仅为:

Mac mini 32GB vs NVIDIA 显卡决策矩阵
对于 8 核 CPU 来说,每秒提供 120~150 GFLOPs 的轻量算力易如反掌,足以轻松支撑 15~25 tok/s 的打字速度。
内存读取特性:每次只计算 3B 活跃参数对应的矩阵切片,CPU 缓存与 DDR5 内存的局部搬运效率极高。
两相对比,就造成了“首字延迟(TTFT)痛苦万分,后续吐字如释重负”的鲜明落差。这也是很多用户在 CPU 上初试 MoE 模型时最容易困惑的体验。
2. 架构图谱:除了 MoE,大模型还有哪些类型?
既然 MoE 展现出了这种“用稀疏激活降低 Decode 算力”的特性,那么在当今的开源大模型技术栈中,还有哪些核心模型架构?它们各自在内存与硬件上有何物理权衡?

1. 经典稠密模型(Dense Transformer)
代表模型:Llama 3.1(8B / 70B)、Qwen 2.5 稠密系列(7B / 14B / 32B / 72B)、Gemma 2 等。
运行机制:不管处理输入还是生成单字,网络中 100% 的参数都会参与计算。
硬件表现:
在生成阶段,稠密模型是彻底的内存带宽受限(Memory Bandwidth Bound)。生成 1 个 Token,必须把模型的全部权重从显存/内存完整读取一遍。
理论生成速度上限遵循极简公式:

如果拿 CPU 配普通双通道 DDR5 内存(带宽仅 60~80 GB/s)去跑一个 32B Q4 稠密模型(约 19GB):理论极限速度也只有 60 / 19 ≈ 3.1 tok/s!从头到尾都像慢动作回放。
2. 状态空间模型与混合架构(SSM / Hybrid)
代表模型:Mamba / Mamba-2、Jamba(AI21)、RecurrentGemma、RWKV。
运行机制:彻底放弃或部分替代 Transformer 中 O(N^2) 的注意力矩阵,改用类似 RNN 的固定尺寸隐藏状态(Hidden State)在时间步上递推。
硬件杀手锏:
O(1) 恒定显存开销:上下文从 4k 暴涨到 100k,KV 缓存的体积不再线性激增!
处理超长文档、大段代码库注入或海量 RAG 知识库时,它绝不会因为上下文过长而把显存撑爆。
3. 隐空间注意力架构(MLA - Multi-Head Latent Attention)
代表技术:DeepSeek-V2 / V3 / R1 系列的核心底座。
运行机制:传统的多头注意力机制(MHA)在长上下文中会积攒巨型 KV Cache。MLA 巧妙地在投影时将 Key 和 Value 压缩到一个极低维度的隐向量空间(Latent Vector),计算注意力时再解压。
硬件价值:把长文本带来的 KV Cache 显存占用直接砍掉了 80%~90%!原本 32k 上下文需要 8GB KV 显存,用 MLA 后可能只需不到 1.5GB。这对本地显存极其紧张的消费级设备来说是质的飞跃。
4. 三值化与原生极低比特架构(BitNet 1.58-bit)
代表模型:BitNet b1.58。
运行机制:权重只有三个可能的值:-1, 0, 1。
硬件颠覆:在传统神经网络中,GEMM 是大量昂贵的浮点乘法(FP16/BF16/INT8 乘累加)。而在三值模型中,乘法退化为单纯的“加法、减法或跳过”。
对 CPU 的意义:CPU 内部没有数千个浮点张量核心,但 CPU 拥有执行效率极高、流水线极短的整数加减法单元。BitNet 这类架构如果未来走向成熟,将彻底颠覆 CPU 本地跑大模型的算力能效比。
3. 硬件解密:CPU、NVIDIA 显卡、Apple UMA、NPU 各自的角色
搞清楚了模型的物理瓶颈,我们再来看承载模型的四种核心硬件:
|
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|
| 常规 CPU 内存 |
|
|
|
|
|
| NVIDIA 独立显卡 |
|
|
|
|
|
| Apple Silicon (UMA) |
|
|
|
|
|
| NPU (神经处理单元) |
|
|
|
|
|
迷思破除:NPU 到底用于什么场景?为什么跑不动 30B 大模型?
很多用户看到笔记本或手机宣称“配备 45 TOPS 算力的全新 NPU”,就误以为能直接在本地流畅跑几十 B 的大语言模型,这是一个严重的认知错位。
NPU 的本质是固定功能的超低功耗专用集成电路(ASIC)。它设计的初衷,是为了以 5W 到 10W 的极低能耗,全天候处理流式传感器和端侧轻量 AI 任务:
视频通话中的实时人脸追踪、背景虚化、视线校正;
麦克风音频的实时 AI 降噪与 Whisper 语音听写;
手机相册的本地离线 OCR 文字提取与人脸聚类;
极小尺寸的端侧模型(1B 到 3B 的小模型,如 Apple Intelligence 的文本润色、通知摘要、局部 Embedding 向量提取)。
为什么 NPU 无法用来跑 14B、32B 这类大模型?
片上缓存极小:NPU 自身的 SRAM 通常只有几兆到十几兆字节,它必须频繁通过系统总线向内存读取数据;
缺乏专用高带宽通道:它没有独立显卡动辄 1000 GB/s 的 GDDR 总线,一旦读取几十 GB 的权重矩阵,立刻被总线速度锁死;
计算图过于僵硬:NPU 擅长执行结构固定、尺寸固定的前向网络(如 CNN、固定的 Transformer 编码器),但大模型推理需要处理高度动态变化的 KV Cache 内存分配、稀疏的 MoE 动态门控路由以及多样的采样策略,这在当前的 NPU 架构上极难高效映射。
因此,在当前及未来的本地大模型推理中,主力战场依然是 GPU 与统一内存系统,NPU 负责做端侧打下手的小帮手。
4. 实战手册:如何把 32GB 内存的 Mac mini 榨干到极致?
如果你已经拥有或预定了一台配置为 32GB 统一内存的 Apple Silicon Mac mini,恭喜你,你已经拿到了目前桌面上性价比最高、体验最优雅的“个人离线大模型工作站”门票。
显存与模型账本拆解
Apple Silicon 的核心精髓是统一内存架构(UMA - Unified Memory Architecture)。CPU、GPU 和神经引擎共享同一块物理内存池,GPU 可以直接把系统内存当成显存使用,中途不存在任何跨 PCIe 总线的内存拷贝(Zero-Copy)。
在 32GB 物理内存的设备上:
macOS 操作系统常驻与日常应用占用:约 4~6GB;
留给本地大模型 GPU 运行的安全“显存空间”:稳定在 24GB ~ 26GB 之间。
这 24GB 净显存,刚好精准卡在各大开源模型能力跃升的“黄金甜点位”:
|
|
|
|
|
|
|
|
|---|---|---|---|---|
| 代码与思考旗舰 |
|
|
|
|
| 全天候响应主力 |
|
|
|
|
| 混合专家试炼 |
|
|
|
|
| 轻快极速版 |
|
|
|
|
关键体验逆转:你在 CPU 上跑 30B MoE 时那令人痛苦的 40 秒 Prefill,在 Mac mini 的 GPU 驱动下,由于有专用矩阵计算与 Metal 深度优化,处理 4,000 字 Prompt 的耗时会被直接压缩到 1~3 秒以内!整体请求延迟从 1 分钟骤降到 5 秒级。
部署工具链选型:避开性能暗坑
为了在 Mac mini 上跑出最满的性能,千万不要走弯路去装基于 x86 模拟或未对 Metal 优化的容器,推荐以下三套原生姿势:
方案 A:作为系统级服务调用 —— Ollama / llama.cpp
定位:与编辑器(Cursor、Continue、Claude Code)或 Web 界面(Open WebUI)联动。
配置要点:直接官网下载 macOS 原生版本,它默认已编译 Metal GPU 加速后端。
启动测试:
bash
  # 拉取并运行 32B 编程能力极其出色的模型
  ollama run qwen2.5:32b-instruct-q4_K_M
方案 B:榨干芯片极致性能 —— Apple 原生 MLX(强烈推荐)
定位:苹果官方机器学习团队专为 Apple Silicon 量身定制的框架,性能往往比经过通用抽象的 llama.cpp 更加极致,Prefill 和 Decode 延迟通常更低。
快速上手:
bash
  pip install mlx-lm
  mlx_lm.generate --model mlx-community/Qwen2.5-32B-Instruct-4bit --prompt "写一个并发限流的 Python 脚本"
方案 C:小白视觉友好 —— LM Studio / Jan
定位:带有精美桌面界面的本地大模型客户端。支持一键搜索 HuggingFace 上的 GGUF 模型,下载后自动适配 Metal 显存加载,开箱即用。
进阶优化:解锁系统显存分配上限
默认情况下,macOS 为了防止某个程序申请过多显存导致系统 UI 卡死,会限制单进程最大只能使用约 75% 的物理内存。如果你想把 32GB 机器中的 26GB 乃至 28GB 彻底留给大模型,可以在终端执行以下调优指令(需管理员权限):
# 调整系统内核允许 GPU 锁定的最大内存限制(例如调整为 28GB)
sudo sysctl iogpu.wired_mem_limit=28672
5. 终极对决:32GB Mac mini vs NVIDIA 消费级显卡
很多准备入局本地大模型的开发者,都会在“搞一台配置不错的 Mac mini”还是“组装一台带 RTX 显卡的 PC”之间反复纠结。我们从工程实测维度做一次客观拆解:

1. 显存天花板与模型尺寸(Mac mini 完胜主流显卡)
RTX 4070(12GB)/ RTX 4080(16GB):这两张显卡售价昂贵,但在大模型面前极其尴尬。跑 7B/14B 绰绰有余,但一旦你想加载 32B 的 Q4 模型(至少需要 19GB 显存),直接爆显存(CUDA OOM)程序崩溃。
32GB Mac mini:凭借 24GB+ 的实际可用显存,可以毫不费力地把 32B 稠密模型和 30B 级别的 MoE 完整吃下。在“能跑多大模型”这个硬指标上,它直接越级碾压了 16GB 显存以下的所有 NVIDIA 消费级显卡。
2. 峰值生成速度与预填充吞吐(NVIDIA 4090 独领风骚)
RTX 4090(24GB 显存):如果同样跑一个能塞进 24GB 显存的模型,4090 的显存带宽高达 1008 GB/s,拥有恐怖的 512 个 Tensor Cores。在生成速度上,4090 可以飙到 40~60 tok/s,Prefill 速度更是达到数千 tok/s,是 Mac mini 的 3 到 4 倍。
结论:如果你追求的是商业级并发吐字、毫秒级响应,或者做大批量的数据集标注处理,4090 依然是无可撼动的算力王者。
3. 日常拥有成本、噪音与能耗(Mac mini 降维打击)
整机能耗与声学表现:
跑满大模型推理时,Mac mini 整机功耗一般只有 30W 到 50W。它的机身常年温热,风扇近乎无声,可以 365 天 24 小时常开放在桌面上,充当你的私有云服务器。
一台搭载 RTX 4090 的 PC,跑推理时显卡功耗 350W~450W,整机需配备 1000W 级别金牌电源,伴随的是多把机箱高转速风扇的轰鸣与滚滚热浪。
采购预算:
一台 32GB 内存的 Mac mini 整体售价远低于单张 RTX 4090 显卡本身;更不用说组装整台水冷、大机箱、高功率电源的 PC 主机总预算。
4. 生态兼容性分水岭
选 Mac mini 的场景:个人桌面伴侣、代码编写辅助、文章阅读润色、搭建基于 LangChain/LlamaIndex 的本地私有 Agent。不需要折腾显卡驱动,开箱即用。
必须选 NVIDIA 的场景:高频做模型全量微调(Fine-tuning)、跑前沿学术研究代码(很多新论文的 Triton/CUDA 算子没有 Metal 移植)、高并发 WebAPI 服务,或者兼顾 Stable Diffusion / Flux 高清生图。
结语:让硬件服务于你的思考流
回顾我们开头提到的困惑:CPU 跑 MoE 之所以表现割裂,是因为它的架构把“算力缺失”与“内存带宽狭窄”两个弱点分别暴露在了 Prefill 和 Decode 两个阶段。
而你的 32GB Mac mini,恰好处在一个绝妙的技术平衡点上——它既没有消费级显卡被锁死在 12GB/16GB 的憋屈显存墙,也没有 x86 传统台式机上千瓦功耗与巨大的散热负担。
装上 MLX 或 Ollama,直接下载一个 Qwen 2.5 32B 或优质的 MoE 模型,把提示词预填充的漫长等待抛在脑后,让它在你的桌角安静、高效地运转起来。这才是现代本地大模型该有的使用体验。