

摘要:AI视觉正在变得更轻量、更实用。本文给你一套零基础可复现的项目流程,帮你从模型选择、数据准备、微调训练到结果评估,快速做出可展示的AI视觉项目。
如果你想做AI视觉,却还在从CNN、反向传播、公式推导开始学起,我建议你先停下来。
不是传统理论不重要,而是2026年的AI视觉学习路径已经发生了变化:先用大模型做出项目,再反过来理解原理,效率会高很多。
今天这篇文章不讲空话,直接给你一套可复制的AI视觉实操路线。读完之后,你至少能知道自己下一步该选什么模型、准备什么数据、做什么项目,以及如何把结果包装成作品集。
一、先纠正一个误区:AI视觉不等于从头训练神经网络
很多新手一上来就被“深度学习”“卷积神经网络”“反向传播”这些词吓住了。
但在真实工作中,尤其是2025到2026年的AI视觉落地场景里,大多数人并不是从零训练一个大型神经网络。更常见的做法是:
1. 选择一个已经训练好的开源视觉模型;
2. 用自己的少量数据做适配;
3. 把模型部署到电脑、摄像头或边缘设备;
4. 针对具体场景持续优化效果。
换句话说,今天学AI视觉,重点不是“重新造轮子”,而是“会选轮子、会改轮子、会把轮子装到场景里”。
所以,如果你是零基础,正确顺序应该是:
先跑通一个Demo → 再做自定义项目 → 最后补原理。
而不是反过来。
二、2026做AI视觉项目,核心只需要抓住3类模型
AI视觉模型很多,但新手不用全部学。先掌握下面这三类,基本能覆盖大多数常见项目。

1. 目标检测模型:告诉AI“画面里有什么、在哪里”
目标检测是最实用的一类AI视觉能力。它的任务不只是识别类别,还要标出物体在画面中的位置。
常见应用包括:
- 产品表面瑕疵检测;
- 车辆和行人检测;
- 安全帽、反光衣识别;
- 货架商品检测;
- 零件计数和尺寸测量。
如果你是第一次做AI视觉项目,我建议先从目标检测开始。因为它上手快、结果直观,也最容易形成作品集。
2. 图像分类模型:让AI判断“这张图属于哪一类”
分类模型比检测更简单,它输出的是整张图的类别判断。
比如:
- 判断产品是否合格;
- 判断图像是正常还是异常;
- 判断缺陷属于划痕、破损、变形中的哪一类;
- 判断路面是否有积水、裂缝或障碍物。
分类模型适合做“结果判断型”项目,但如果你的场景需要知道缺陷具体在哪里,还是要优先选择目标检测。
3. 多模态视觉模型:用文字指令控制AI做分析
这是2026年最值得关注的方向之一。
传统AI视觉模型通常只能完成固定任务,比如只做检测、只做分割。而多模态视觉模型可以接收文字指令,让AI按照你的要求分析画面。
例如:
- “检测画面中的所有破损零件,并统计数量”;
- “标出监控区域内长时间逗留的人员”;
- “找出医疗影像中的可疑病灶区域”;
- “分析视频中哪些行为属于异常聚集”。
这类模型的优势是灵活,适合做开放式、可交互的视觉分析系统。
三、零基础做AI视觉项目,照着这个流程走
下面这套流程适合大多数AI视觉项目,不管你做的是工业质检、安防检测,还是智能零售分析,都可以套用。

第一步:先定义清楚项目,不要先选模型
很多人一上来就问:“我该用YOLO还是SAM?”
这个问题其实应该放在后面。更重要的是先回答下面几个问题:
- 我要识别的是单类别,还是多类别?
- 只需要判断类别,还是需要标出位置?
- 画面是图片还是视频?
- 摄像头安装角度是什么?
- 目标大小变化大不大?
- 光线、背景、遮挡会不会影响效果?
- 实际场景允许的响应时间是多少?
把这些问题想清楚,模型选择会自然清晰。
例如:
- 如果你只需要判断产品是否异常,分类模型可能就够了;
- 如果你需要找到缺陷位置,目标检测更合适;
- 如果你希望用户能用文字指令灵活分析,就可以考虑多模态模型。
第二步:准备一个最小可用数据集
新手最容易犯的错误,是一开始就追求海量数据。
实际上,很多AI视觉项目并不需要几万张图片。对小场景、小类别项目来说,先准备 50到200张图片 就足够验证方向。
一个最小数据集最好包含:
- 正常样本;
- 异常样本;
- 不同光照条件;
- 不同角度;
- 不同背景;
- 部分遮挡或模糊样本。
注意:数据质量比数据数量更重要。
几张高质量、标注准确的图片,可能比几百张混乱、重复的图片更有用。
第三步:选择开源模型,先跑通基线结果
新手不要纠结哪个模型“最先进”,先选生态成熟、文档多、容易复现的模型。
适合入门的方向包括:
- 目标检测:YOLO系列、YOLO-World;
- 图像分割:SAM系列;
- 多模态视觉:Qwen-VL、LLaVA等视觉语言模型;
- 轻量级部署:可通过ONNX、OpenVINO、TensorRT等方式部署。
你的目标不是一开始就刷到最高精度,而是先搞清楚:
- 模型能不能跑出结果;
- 推理速度是否可用;
- 错误主要出在哪类样本;
- 是否需要补充数据。
这一步叫“建立基线”。有了基线,后面的优化才有意义。
第四步:做小样本微调,而不是盲目增加训练数据
当通用模型效果不够好时,最常见的方法是微调。
微调的意思是:在预训练模型基础上,用自己的少量数据继续训练,让它更关注你的场景。
一个基础微调流程可以是:
1. 收集场景图片;
2. 标注目标类别和位置;
3. 划分训练集、验证集;
4. 选择合适的预训练权重;
5. 设置训练参数并开始微调;
6. 在验证集上查看精度、漏检率、误检率;
7. 根据错误样本补充数据或调整类别。
对很多小项目来说,50到200张标注数据 已经值得做一次微调。
第五步:评估结果,只看业务指标,不迷信准确率
模型训练完后,不要只看一个准确率数字。
更应该关注:
- 哪些类别最容易被漏检?
- 哪些背景干扰最容易导致误检?
- 小目标能不能识别?
- 模型速度是否满足实时要求?
- 部署后是否稳定?
比如在工业质检场景中,漏检可能比误检更严重;在安防场景中,误报太多会导致系统不可用;在自动驾驶场景中,速度和稳定性都非常关键。
所以,AI视觉项目的好坏,最终要看业务是否愿意用它,而不是实验报告上的单一指标。
四、给你3个可直接复现的AI视觉项目方向
项目1:产品表面瑕疵检测
这是最适合新手练手的项目,因为数据容易收集,结果也直观。
你可以做的事情包括:
- 检测划痕;
- 检测破损;
- 检测变形;
- 检测污渍;
- 检测漏装零件。
建议流程:
1. 收集产品图片;
2. 标注正常和异常类别;
3. 选择目标检测模型;
4. 微调模型;
5. 测试不同光照和角度;
6. 输出检测结果和统计报表。
这个项目适合放进作品集,因为它完整覆盖了“数据—训练—部署—结果展示”的闭环。
项目2:智能视频行为分析
这个项目比图片检测更有科技感,也更适合展示综合能力。
你可以选择一个较小的切入点,比如:
- 人员徘徊检测;
- 区域入侵检测;
- 聚集行为检测;
- 安全帽佩戴检测;
- 车辆违停检测。
建议流程:
1. 获取视频或监控片段;
2. 提取关键帧;
3. 标注目标和行为区域;
4. 训练检测模型;
5. 加入简单规则判断;
6. 输出告警结果或事件统计。
注意,第一次做不要把目标定得太大。先做好一个具体行为检测,比同时做十类行为更有价值。
项目3:多模态视觉问答系统
如果你想做更贴近2026年AI趋势的项目,可以尝试多模态视觉问答。
它的核心是:用户输入图片和文字问题,AI直接给出分析结果。
例如:
- “这张图里有几个零件?”
- “哪些产品有破损?”
- “画面中有没有人员聚集?”
- “这个区域是否存在安全隐患?”
建议流程:
1. 准备业务图片;
2. 设计一组常见问题;
3. 选择视觉语言模型;
4. 设计提示词;
5. 测试不同问题的回答效果;
6. 做成简单网页或本地演示工具。
这个项目更适合展示你对多模态AI的理解,也更容易写进简历。
五、零基础学习AI视觉,我建议按这个顺序来
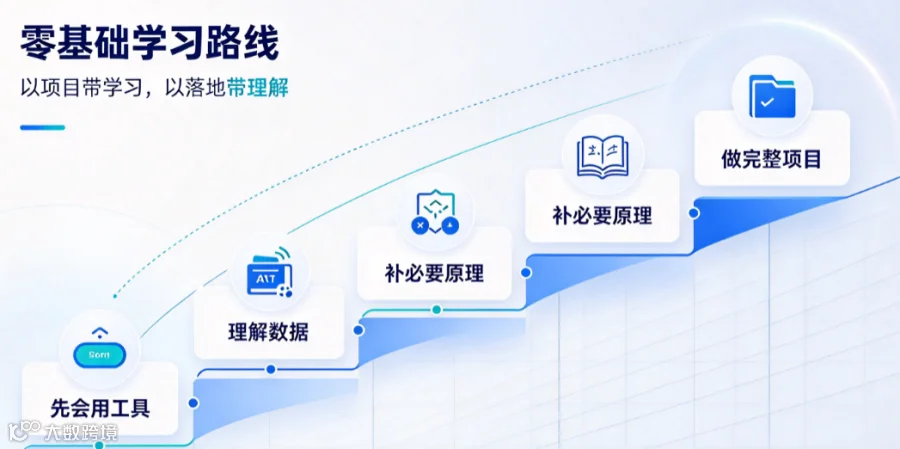
如果你真的想把AI视觉学明白,不要一开始就从底层原理硬啃。
我建议的学习顺序是:
第一阶段:先会用工具
目标:能跑通模型,能看到结果。
你应该学会:
- 如何读取图片和视频;
- 如何调用开源模型;
- 如何可视化检测结果;
- 如何评估模型输出;
- 如何做一个简单演示。
这个阶段不需要深入理解所有数学公式。
第二阶段:理解数据为什么重要
目标:知道模型为什么会失败。
你应该理解:
- 数据标注是什么;
- 训练集和验证集怎么分;
- 过拟合是什么;
- 漏检和误检从哪里来;
- 为什么换一个场景效果会变差。
当你开始关注数据时,才算真正进入AI视觉。
第三阶段:补必要原理
目标:能解释模型为什么这样工作。
你可以再学习:
- 卷积神经网络的基本思想;
- 目标检测的基本流程;
- Transformer和注意力机制;
- 模型压缩和部署的基本方法。
这个时候再看理论,会比一开始清晰很多。
第四阶段:做完整项目
目标:能独立完成一个可展示项目。
一个完整项目最好包含:
- 项目背景;
- 数据集说明;
- 模型选择理由;
- 训练和评估过程;
- 结果可视化;
- 失败案例分析;
- 部署演示。
这才是企业真正想看的内容。
六、写在最后
2026年的AI视觉,已经不再是只有算法工程师才能碰的领域。
随着开源模型、多模态模型和轻量级部署工具的成熟,普通人也可以快速做出有价值的AI视觉项目。
但这并不代表学习门槛消失了,而是门槛发生了变化。
以前的门槛是:你能不能从头训练一个模型。
现在的门槛是:你能不能把模型用到真实场景里,并稳定解决问题。
所以,别再把时间都花在收藏课程和背诵公式上。
真正有效的学习方式,是从一个小项目开始,先跑通,再迭代,再理解。