

你手头有好几个AI工具:一个用来预测蛋白质结构,一个用来生成小分子配体,一个用来设计MOF材料,还有一个用来做逆合成分析。
每个工具都很专业,但它们是“各说各话”的——数据格式不互通,模型架构不一样,训练数据不共享。
你问AI:“这个蛋白的口袋能长出什么样的分子?”——它只能给出一个“分子”,却不知道这个分子怎么做出来、能不能做成材料、结构合不合理。
问题在于:科学数据有自己的“方言”,而我们需要一门“通用语言”。
一个被长期忽视的“语言隔阂”
在AI for Science领域,我们习惯了“专才”模型:
ESM系列:专门处理蛋白质序列;
AlphaFold:专门预测蛋白质结构;
DiffBP / Pocket2Mol:专门生成配体分子;
MOFDiff / MOFFlow:专门生成MOF材料;
EditRetro / LocalRetro:专门做逆合成预测。
每个模型在自己的领域里表现很好,但它们不能共享知识——蛋白模型学到的东西,无法帮助小分子模型;分子生成模型学到的东西,无法帮助材料生成。
为什么?因为它们的“语言”不同:
蛋白质用氨基酸单字母序列;
小分子用SMILES字符串;
材料用金属簇+有机配体的嵌套结构;
口袋-配体相互作用用3D坐标+几何图神经网络。
每个领域都用自己的“方言”在说话,没有一门“通用科学语言”可以让它们互相理解。
这篇来自阿里云团队的论文(LOGOS,预印本2026年8月),做的就是这件事:
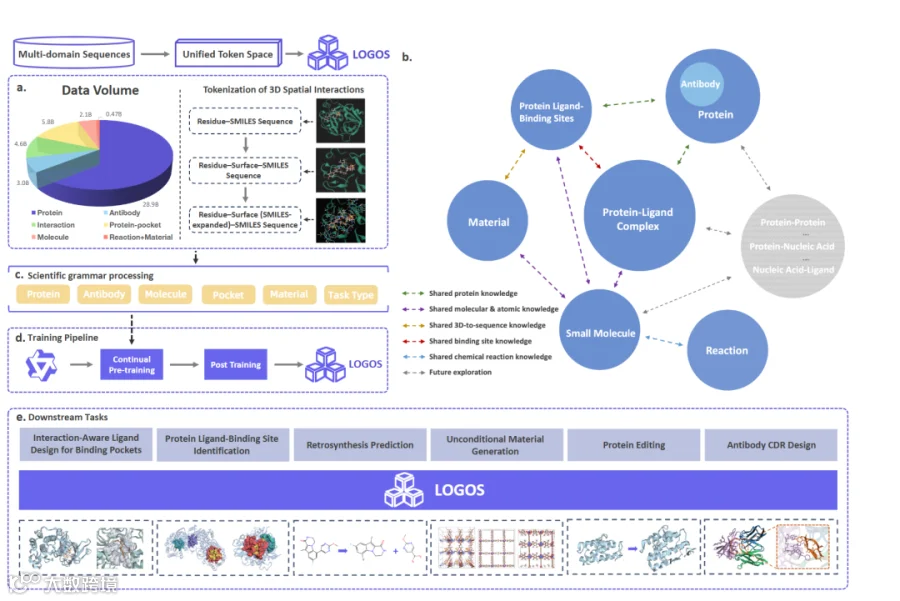
设计一门统一的“科学语法”,把蛋白质、抗体、小分子、化学反应、MOF材料、蛋白口袋、蛋白-配体复合物全部编码成共享token空间里的序列,然后用一个纯自回归语言模型,覆盖所有任务。
LOGOS的“科学语法”:把3D空间关系“翻译”成序列
LOGOS最核心的设计不是“模型有多大”,而是“数据怎么表示”。
统一的边界标记体系
每个科学对象都有一组统一的边界标记:
…:蛋白质
…:抗体
…:小分子(SMILES)
…:MOF材料
…:金属簇
关键设计:嵌套语法
MOF材料不是扁平序列,而是嵌套结构:
text<MaterialS> <MetalS>[Cu+][Cu+]<MetalE><MoleculeS>CO[N-][N-]OC<MoleculeE><MoleculeS>O=C([O-])/C(F)=C(\F)C(=O)[O-]<MoleculeE><MaterialE>
——金属簇和小分子SMILES是“内容”,Material是“容器”。
最精彩的设计:把“空间相互作用”变成“序列翻译”
这是整篇论文最让我拍案叫绝的地方。
传统方法处理蛋白口袋-配体相互作用,需要3D坐标 + 几何图神经网络(GNN)。但LOGOS完全不用坐标,它把3D空间关系“翻译”成序列。
具体做法是:
第一步:在蛋白质序列里,用和标记出哪些残基构成了口袋。
第二步:把每个口袋残基展开成它侧链的SMILES字符串——比如“A”(丙氨酸)展开成C[C@H](C=O)O)N。
第三步:引入一个翻译任务——给定氨基酸字母序列,预测对应的SMILES侧链序列。通过这个任务,模型学会了“氨基酸符号”和“分子结构”之间的精确映射。
第四步:在蛋白-配体复合物数据里,把口袋残基的SMILES展开 + 配体SMILES拼接在一起,形成完整的“口袋-配体相互作用序列”。
这意味着什么?
原本需要用3D坐标+GNN才能表达的空间关系,被“翻译”成了纯序列的翻译任务。
模型不需要知道原子在空间里的XYZ坐标,只需要学会“看到口袋残基的SMILES,就应该生成什么样的配体SMILES”。
这是一个非常大胆的“几何→序列”的降维思路——它牺牲了3D精度,但换来了跨领域统一建模的可能性。

三个关键消融实验,直击核心假设
✅ 实验1:权重初始化——用LLM的“语言直觉”有用吗?
作者对比了四种初始化方式:
全随机初始化
只继承Embedding层
继承Embedding+Backbone
全部继承(最终方案)
结果:只有继承Backbone才有显著提升——这意味着LLM在自然语言上学到的序列推理模式、长程依赖建模能力,对科学序列确实有迁移价值。
但紧接着,作者做了第二个实验:
✅ 实验2:混入自然语言数据,效果反而变差
当作者在科学语料里逐步增加自然语言文本的比例时,配体生成任务的Vina打分持续下降。1B、3B、8B模型都是一样的趋势。
结论:LLM的权重做初始化是有用的,但混入自然语言语料做继续训练是有害的——模型容量有限,科学模态和自然语言在竞争参数资源。
这就验证了LOGOS的设计哲学:不要用自然语言作为跨模态接口,直接在领域原生表示空间里统一建模,参数效率更高。
✅ 实验3:“口袋翻译”任务,是配体生成性能的关键
作者对比了三种预训练数据配置:
完全不包含口袋和复合物数据:配体生成性能接近随机;
包含口袋和复合物数据,但不包含“氨基酸→SMILES翻译”数据:有提升,但有限;
全部包含(含翻译数据):性能大幅跃升。
最关键的提升来自“口袋翻译”数据——这个数据跟配体生成本身没有任何直接关系,只是教模型“把口袋残基的字母翻译成它们的分子结构”。
这个结果非常反直觉但极其深刻:模型不是因为“看到了更多的口袋-配体对”才学会了生成配体,而是因为学会了“每个口袋残基长什么样”才学会了生成配体。
前者是“统计配对”,后者是“理解化学语义”。
六个任务上的表现:一个8B模型,打一群专用模型
🔬 任务1:口袋-配体生成(药物设计核心任务)
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
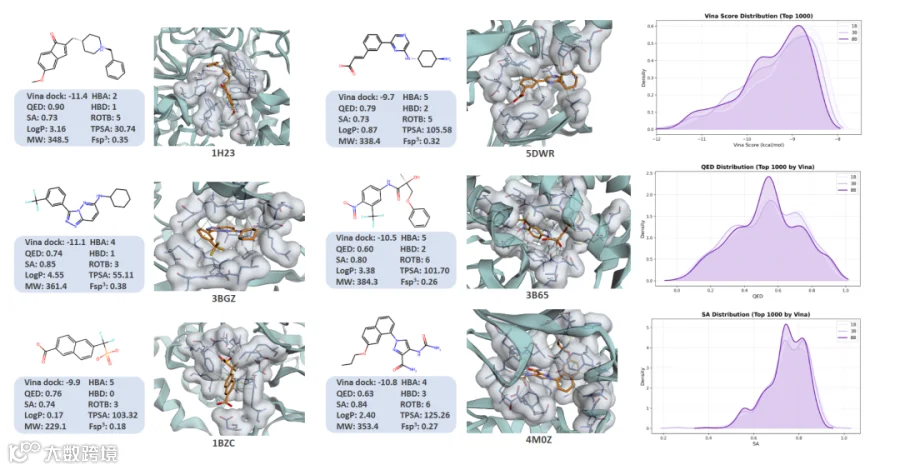
LOGOS-1B(1个模型、10亿参数)在Vina打分上超过了所有专用模型和NatureLM(8×70亿参数)。
而且,作者还展示了生成配体的3D对接姿态——配体与口袋形成了多种非共价相互作用(氢键、疏水接触、盐桥、π-π堆积),说明模型虽然在纯序列范式下工作,但确实学到了物理上合理的结合模式。
🔬 任务2:蛋白口袋识别——只用序列,超越大多数3D方法
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
LOGOS-8B是唯一一个只用氨基酸序列就能做到66.5%识别率的模型,超过了所有其他需要3D结构的方法(仅次于P2Rank)。
这意味着:对于没有解析出3D结构的蛋白质(已知序列数 >> 已知结构数),LOGOS可以直接预测其口袋位置——这在药物发现早期阶段有巨大的实际价值。

🔬 任务3:逆合成预测——Top-1准确率74.8%
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
在所有方法中,LOGOS-8B Top-1最高。
🔬 任务4:MOF无条件生成——所有指标全面领先
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
NBB(新颖构筑块)指标尤其值得关注——17.78%的生成MOF含有训练集里没见过的有机配体。
这意味着:LOGOS不仅仅在“组合已知模块”,它学会了“创造新的化学片段”。模型从小分子和反应数据里学到了SMILES的底层化学规律,然后把它迁移到了材料生成任务中。

🔬 任务5:蛋白优化——比专用方法高60%以上的适应度
在GFP和AAV两个蛋白上,LOGOS-8B的Fitness达到0.93/0.70,而最好的专用方法GGS分别只有0.35/0.33。
LOGOS-8B比GGS高了60%以上。
🔬 任务6:抗体CDR设计——在CDR1/2上全面领先,CDR3留有余地
CDR-H1、H2、L1、L2:AAR和scRMSD全面最优;
CDR-H3:落后于基于逆折叠的专用方法(如RADAb),但plausibility(天然抗体分布一致性)仍然非常有竞争力。
这个结果很合理——CDR-H3的多样性主要来自V(D)J重组的随机插入/删除,很难从框架区序列直接预测,需要3D结构约束。
但LOGOS在Plausibility上的竞争力意味着:即使它不能精确恢复参考序列,它生成的替代方案仍然是“像天然抗体的”。
多任务联合训练:1+1 > 2
作者还做了一个非常干净的对比:同一个模型用4个任务联合微调 vs. 每个任务单独微调。
结果:在所有4个任务上,联合训练的效果都超过了单独训练。
这说明,在统一的科学语法下,不同领域的任务确实能互相“借力”——逆合成学到化学键重组规律,可以帮助配体设计;口袋识别学到的蛋白序列-结构关系,可以帮助口袋-配体相互作用建模。
对从事AI4S/药物设计/材料计算的科研人员的启示
1️⃣ 统一的“科学语法”是可行的,而且可能是必要的
LOGOS证明了:用一套共享的token体系和嵌套语法,可以把蛋白质、小分子、MOF、反应、口袋-配体相互作用全部统一成序列数据。这不仅仅是“省事”,而是让不同领域的知识可以互相迁移。
2️⃣ 把3D关系“翻译”成序列,比硬塞3D坐标更灵活
LOGOS没有用任何3D GNN,但配体生成性能反而超过了专用方法。这提醒我们:空间关系不一定要用坐标来建模,有时候“语法化”和“序列化”可能更有效、更可扩展。
3️⃣ LLM的权重是好的起点,但自然语言语料不是好“续命丹”
初始化用LLM权重有用(序列推理模式可以迁移),但继续混入自然语言会让科学任务变差(容量竞争)。对于科学模型,继续预训练应该在“科学语法空间”里进行,而不是“自然语言空间”。
4️⃣ 多任务联合微调不是“凑合”,而是真正的知识转移
当不同领域的数据被映射到同一token空间时,模型确实能学到跨领域的共同规律。如果你有多个相关任务的数据,联合微调可能比单独微调效果更好——这不仅仅是节省显存。
5️⃣ 1B模型可以打8×70B模型——关键在于“表示”而不是“规模”
NatureLM用自然语言做跨模态接口,8×70B参数,Vina打分-6.91;LOGOS用科学语法做跨模态接口,1B参数,Vina打分-7.64。表示方式的选择,对模型效率的影响可能比参数规模本身更大。
一句话总结
LOGOS告诉我们:AI4S的未来,不一定是“每个领域一个专用模型”,而可能是“一个模型,一套语法,覆盖所有领域”。
关键在于把3D空间关系“语法化”为序列,把不同领域的对象“标准化”为统一token空间,然后把所有科学任务都当作“下一个token预测”来做。
1B参数的LOGOS,在配体生成、逆合成、MOF设计、蛋白优化等任务上,超过了专用方法和数十倍参数量的自然语言接口模型——这不仅是效率的胜利,更是一种关于“科学数据应该怎么表示”的深刻见解。
📌 如果你在做AI辅助药物设计、材料生成、蛋白工程,或者思考“如何用一个模型覆盖多个科学任务”——LOGOS的“科学语法”设计和开源资源,值得你仔细研究。
知识图谱+大语言模型:质谱数据分析的新范式
Anal. Chem. | 大语言模型能否将MS/MS质谱直接翻译为分子描述?
化学领域大模型评估基准汇总(四)
ACL 2026 | 化学视觉大模型让AI「看懂」化学结构
MatterChat:材料科学迎来多模态大模型新时代
Nat. Mach. Intell.蛋白质组学首个大规模多模态预训练模型,突破质谱数据解析极限
✨ 本文是对arXiv 2606.16905的系统解读(2026年6月)。