在一个已经上线运行的 AI Agent 应用里,记忆系统往往面临这样的问题:
· 记忆能回答"这个用户以前说过什么",但回答不了"接下来这件事可能怎么走",往前一步的判断仍然靠人凭经验补齐;
· 记忆的处理过程是一个黑箱,工程师说不清某条记忆为什么被强化、为什么这次没有被召回,向业务方解释时只能含糊其辞;
· 业务真实产生的内容是会议录音、培训录像、报错截图,而知识库只认文本,这些材料进不去,进去之前得先有人整理一遍。
近期,红熊AI记忆科学MemoryBear v0.4.7版本发布。这次更新的主线只有一件事:让记忆从“存得好、查得到”,走向“能往前推演、能被看懂、能接纳更多内容形态”。
围绕这条主线,本次版本做了三件事:
01 记忆预测推演引擎:把记忆的用途从历史回溯延伸到未来情景分析。
02 类脑记忆流转引擎:让记忆处理的分工、路径与强度变化看得见。
03 多模态知识库:图片查询接入,音视频模型配置就位。

记忆预测推演引擎:从回看历史到推演接下来
这是MemoryBear v0.4.7最主要的一项更新,也是上一个版本预告过的能力,现在正式交付。
在此之前,记忆系统做的是回溯:把发生过的事情存好、理好、查好。但真实业务里,人需要的判断常常指向前方——这件事继续下去可能变成什么样,相关的几方各自会怎么回应,哪些路径需要提前准备。这部分一直由人凭经验补齐,记忆帮不上忙。
记忆预测推演引擎新增了情景推演能力。它基于已经沉淀的记忆和真实交互记录,通过多轮模拟,分析相关角色的可能回应与情景发展路径,为后续的判断和行动规划提供参考。
举个常见的场景:一位客户成功经理要在续约沟通前准备方案。过去半年的沟通记录、提出过的诉求、几次异议的处理方式都已经在记忆里。推演会从这些证据出发,逐轮给出情景可能的发展路径和各方可能的回应,让他把准备工作做在前面,而不是把判断交出去。
引擎在四件事上做了明确设计:
· 以历史记忆为依据:从记忆证据中筛选与当前情景相关的参与角色,让推演建立在已有交互记录之上,减少对背景信息的无依据假定。
· 逐轮呈现推演过程:每一轮的推演步骤、模拟回应以及结束原因都会展示,情景如何演进、结果如何形成是可见的,不是只给一个结论。
· 明确事实与推演边界:历史事实、模拟内容、推演假设分别标注,不会把"可能发生的情景"和"已经发生的事实"混在一起。
· 支持结果追溯与复核:推演引用了哪些证据、执行了哪些步骤、在什么条件下结束,都会保留,便于核查依据、判断这个结果值多少参考权重。
后两条决定了这个能力能不能真正被用起来,值得多说几句。
标注事实与推演的边界,解决的是一个很实际的问题。推演内容和历史事实如果混在一起呈现,模拟出来的内容在传递几手之后很容易被当成发生过的事。分开标注是在一开始就把这条线画住。
保留推演的依据是另一半。一个推演结论被拿到会上讨论时,真正要回答的问题往往不是结论本身,而是它凭什么这么说:引用了哪些记忆、执行了哪些步骤、在什么条件下停了下来。这些都会保留,可以摊开来核查,据此判断这个结果值多少参考权重。
还有一点需要讲清:推演产出的是假设性的情景参考,不是对真人行为的判定;依据也限定在企业自有业务数据中已沉淀的交互记录范围内。所以"标注边界"和"可追溯"在这一版里不是附加功能,而是和推演能力本身同等优先的部分。
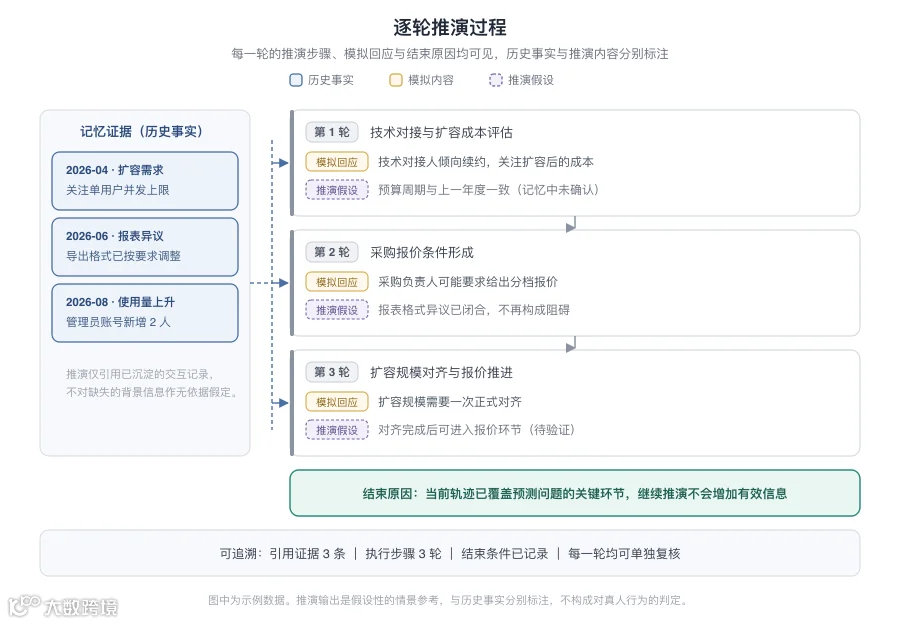
△ 逐轮推演过程示意。图中为示例数据,历史事实、模拟回应与推演假设分别标注。
类脑记忆流转引擎:让记忆处理过程看得见
第二项引擎解决的是另一类问题:记忆处理逻辑本身不好理解,也不好解释。
记忆从写入到被召回,中间要经过多个环节的分工协作,环节之间还存在强度变化和反馈关系。这套逻辑在文档里能写清楚,但在实际排查和沟通时,面对的是一个没有形状的过程——出了问题不知道该看哪一段,解释给别人听也只能靠比喻。
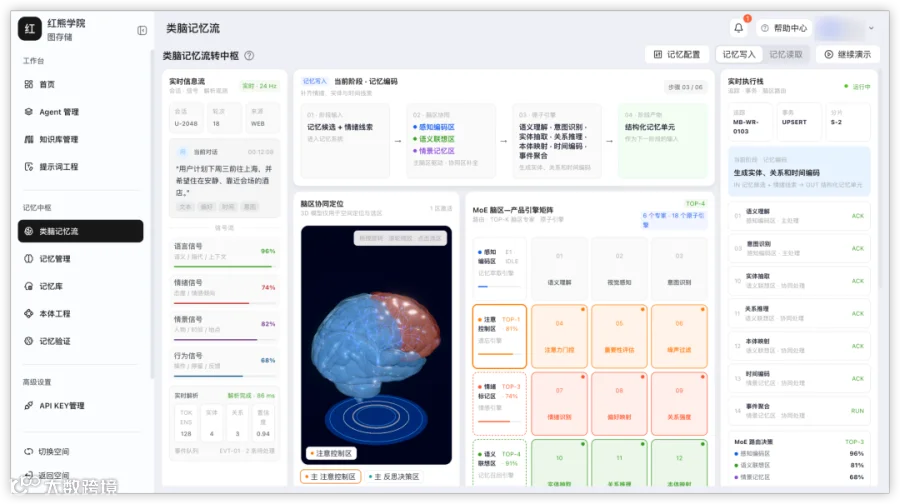
类脑记忆流转引擎引入了一种新的呈现方式,以脑区分工、任务路径与强度反馈,把记忆处理的关键环节串联起来:
· 多脑区能力映射:用不同的类脑区域对应记忆处理中的能力分工,各环节的职责、联系与协作关系一眼可见。
· 任务流转脉络:围绕一个任务梳理相关能力与处理路径,记忆如何流转、各环节如何衔接变得清晰。
· 记忆强度演化:以强度变化与反馈关系呈现记忆的演化逻辑,强化、弱化以及它们与使用反馈的联系更容易理解。
举个常见的场景:工程师排查"这条记忆为什么没有被召回",过去要在多个环节之间来回对照,现在可以沿着任务路径看记忆实际走过了哪些环节;向业务方解释某条记忆为何逐渐弱化时,强度演化视图本身就是解释,不用再翻译成比喻。
记忆强度这件事尤其需要被看见。记忆会因为被反复使用而加强、因为长期不被触及而减弱,这是记忆系统设计里的常识,但对使用者来说,它此前是一个只能从结果反推的过程——某条记忆突然不再出现,很难判断是它被弱化了,还是检索没命中。把强度变化和使用反馈的关系摆出来,这类判断就有了依据。
这里需要把话说准:它改变的是记忆处理过程"看得见"这件事,用类脑分区作为组织语言来帮助理解各环节的分工,并不是说系统在模拟人脑的生理机制。

多模态知识库:图片查询可用,音视频配置先行就位
知识库这次从"文本加附件"往前走了一步,但两件事的进度不一样,先说清楚。
· 知识库图片查询接入:应用侧接入了知识库已有的图片检索能力,支持通过图片查询知识库。工作流的知识库节点新增图片查询参数,可以传入图片变量并获取检索结果。
· 音视频模型配置支持:本期交付音视频的配置层——知识库可以分别指定音频转写模型与视频理解模型,管理端和对外 API 同步支持。
· 媒体模型选配与继承:视觉、音频、视频模型均支持选配。创建知识库时未指定的媒体模型,可以继承工作空间中可用且兼容的默认配置;没有可用配置时允许留空,而不是仅因为没配媒体模型就直接报错。
举个常见的场景:客服拿到用户发来的报错截图,用图片查询知识库,直接定位到对应的处理方案——过去这一步要先把截图里的报错信息读出来、转成文字再去搜。
图片查询落到工作流节点上这一点值得单独提。参数接收的是图片变量,意味着图片可以来自流程上游的任意环节,检索结果继续往下游走。图片因此成了流程里可以流转的数据,而不是只能在对话界面里被人看一眼。
配置层先落地,对正在规划音视频知识库的团队是有用的一步:模型选型、管理端配置、对外 API 配置都可以现在就定下来,不必等全部就位再动手,这一段准备后面不用重来。
第三条是容易被忽略但实际影响不小的一处。媒体模型从必配变成可选配加继承,意味着团队可以先把知识库建起来,再逐步补齐媒体能力,不必为了通过校验去配置一个当下并不需要的模型。对已经在跑的知识库来说,这也避免了因为一个用不上的模型配置缺失导致解析中断。
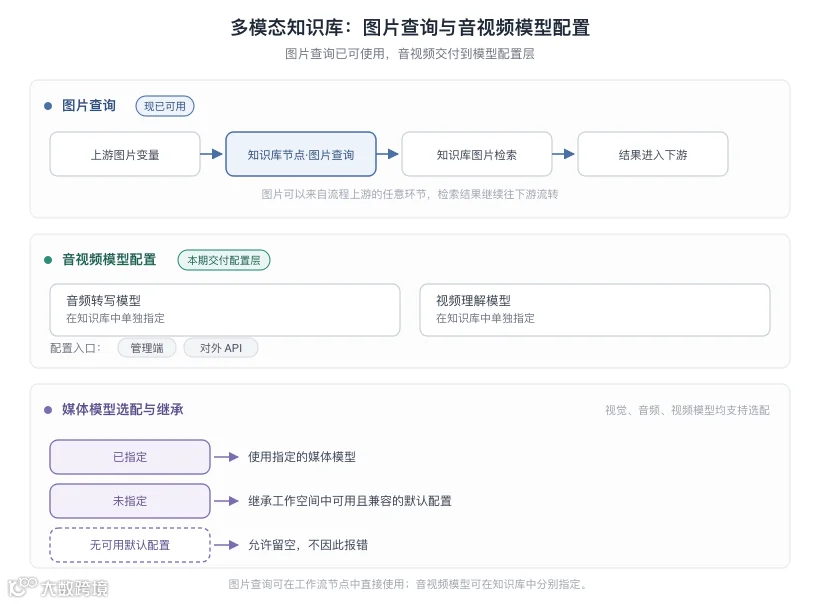
△ 知识库的图片查询链路与音视频模型配置
当 Agent 应用从演示环境走进长期服务,记忆要回答的问题也在变化。早期的问题是“存得下、查得到”,现在的问题是“能不能据此往前判断一步”,以及“这个判断的依据能不能拿出来看”。
MemoryBear v0.4.7 让记忆可以向前推演、让记忆的处理过程可以被看见、让知识库向更多内容形态打开——这些事情加在一起,指向同一个方向:让记忆不只是一个存储层,而是能够参与判断、并且判断依据可以被复核的基础设施。
推演之所以值得参考,不是因为它给出了结论,而是因为结论能回到它的依据。