编者摘要:本文是 Perplexity 公开的工程技术博客,介绍自研本地推理引擎Lily,针对 Apple Silicon 与 Qwen3.6‑35B‑A3B 稀疏 MoE 模型深度优化,对比 MLX‑LM 取得显著性能提升。
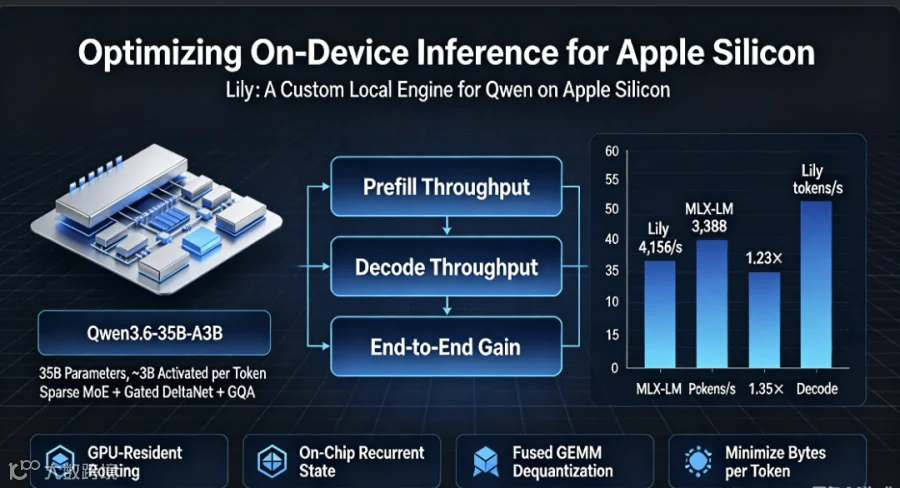
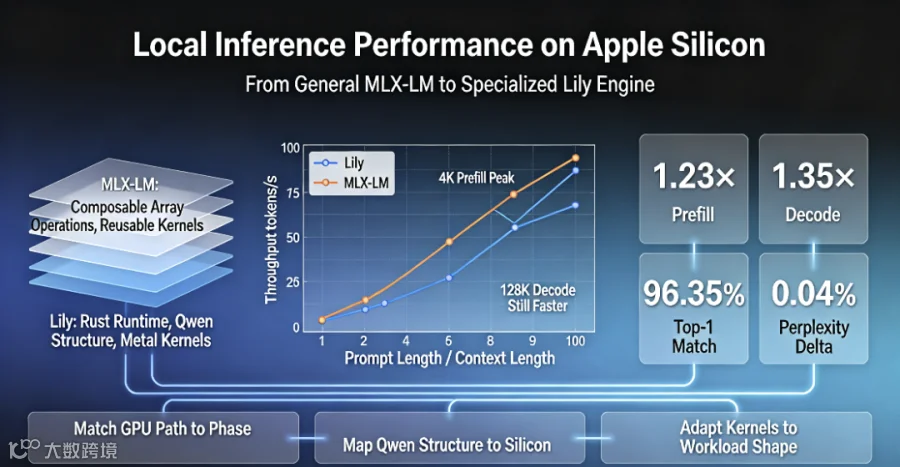
现有 MLX‑LM 是通用推理栈,算子设计要兼容海量模型;Lily 放弃通用性,走模型‑硬件联合定制路线:Rust 运行时 + 自定义 Metal 内核,完全绕开 MLX/PyTorch。测试平台 M5 Max(40 核 GPU,128GB 统一内存),Batch‑1 本地推理。测试范围 256‑128K 上下文,Prefill 平均加速 1.23 倍,Decode 平均加速 1.35 倍;超长上下文 Decode 收益尤其突出。
Qwen3.6‑35B‑A3B 带来三类特殊负载:MoE 专家 token 分配不均衡;GQA 注意力缓存随上下文膨胀;Gated DeltaNet 循环状态具备序列依赖。Apple Silicon 硬件两套计算通路:Neural Accelerator 擅长高复用矩阵 GEMM(Prefill);向量 ALU 适合带宽受限、权重复用很低的 GEMV(Decode)。统一内存减少拷贝,但数据搬运依旧是核心瓶颈。
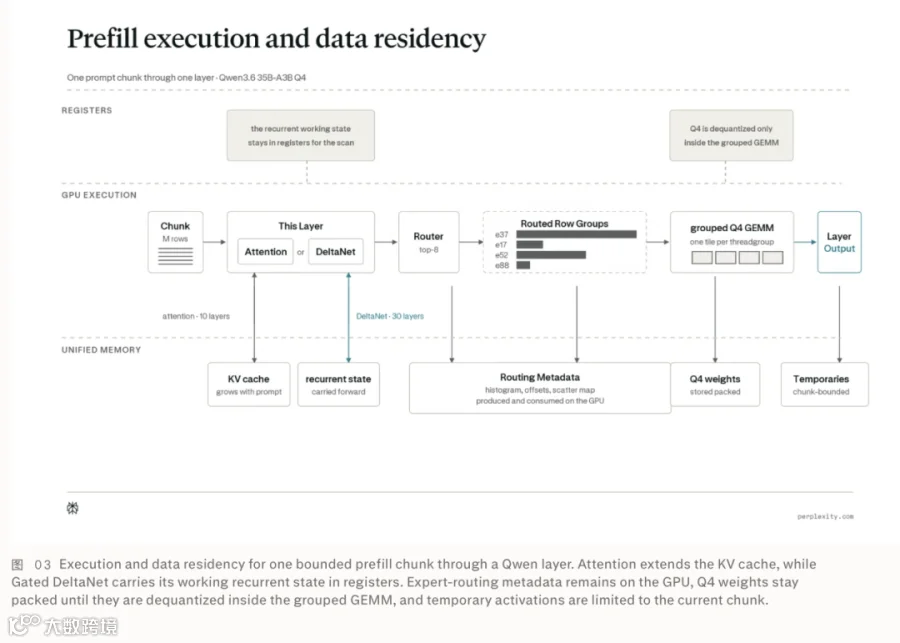
Prefill 核心优化思路:权重反量化嵌入 GEMM 内核,不生成完整解压权重副本;MoE 路由全链路 GPU 完成,消除 CPU‑GPU 同步;根据专家实际 token 负载动态调整计算 tile 尺寸;Gated DeltaNet 循环状态尽量保存在寄存器,减少内存读写;长 Prompt 分块,控制峰值临时内存占用。消融实验显示 GPU 路由、在线反量化是 Prefill 最大收益来源。
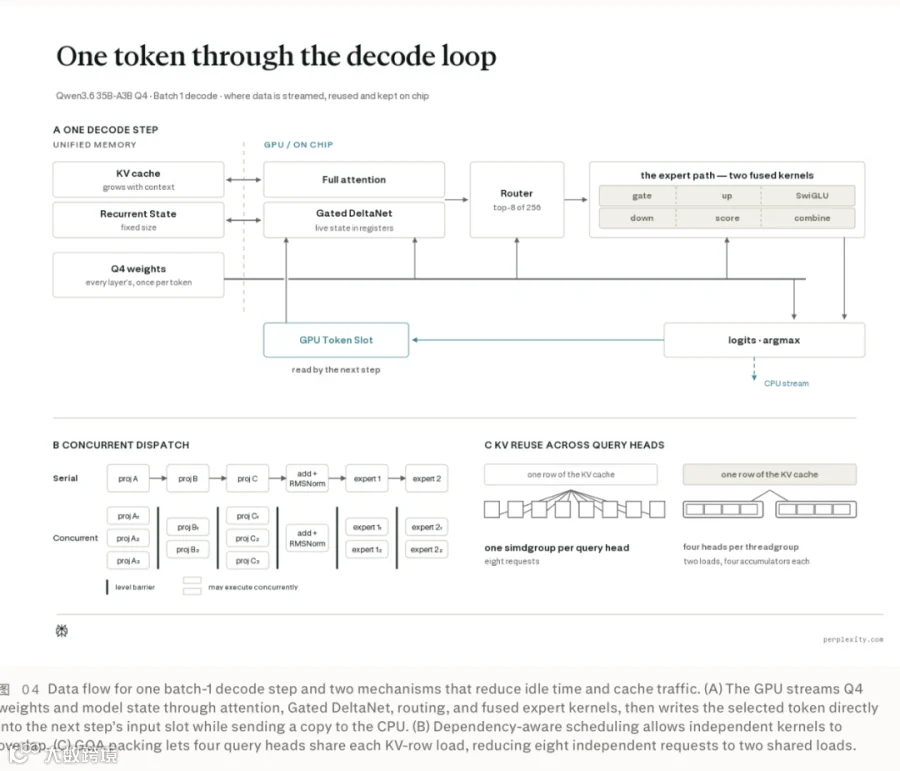
Decode 瓶颈是内存带宽,目标降低每 token 搬运字节:实现 GPU 内部 token 采样‑输入闭环,消除每步 CPU‑GPU 同步;利用 Metal 并发 Pass 调度可并行内核;大量算子融合消灭中间张量落地内存;GQA 打包让多头复用 KV 缓存,大幅降低缓存 IO;长上下文自动切换注意力布局,128K 上下文 Decode 可提升 40%。
同时做了优化边界探索:推测解码在 Batch‑1 本地场景反而变慢;主要计算模块已经逼近硬件带宽上限,剩余优化空间有限。数值校验证明专用内核带来微小浮点偏差,生成结果高度对齐 MLX‑LM。
文章传递核心工程观点:端侧高性能推理不能只依赖通用框架抽象。当模型架构越来越复杂(MoE、循环注意力变种),需要引擎感知模型内部结构,结合硬件特性做分阶段、自适应调度,才能释放 Apple Silicon 全部能力。Lily 当前针对 Qwen 做深度定制,后续目标把这些优化机制抽象为更通用运行时能力。
关键5个问题Q&A
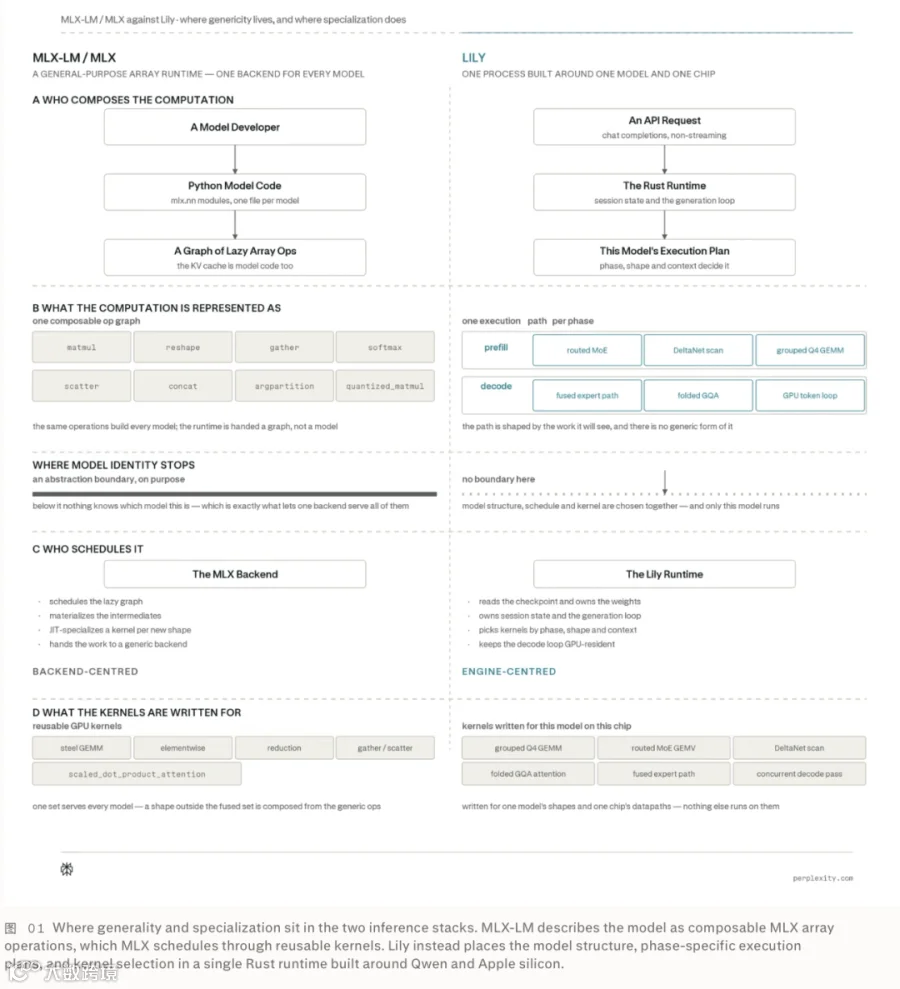
Q1:Lily 和 MLX‑LM 本质区别? A:MLX‑LM 通用,算子抽象模型;Lily 专用引擎,Rust runtime 掌控模型执行计划、内核选择、数据布局,面向 Qwen 硬件特征硬编码,牺牲通用性换取性能。
Q2:Prefill 最大收益来自哪里? A:4bit 权重 GEMM 内就地反量化;MoE 路由整套流程留在 GPU,消除 CPU‑GPU 同步;动态 tile 适配专家不均匀 token 负载。
Q3:Decode 最大收益来自哪里? A:GQA 打包减少 KV 缓存重复读取;超长上下文切换注意力分块布局;算子融合减少中间内存流量;GPU 闭环消除每步 CPU‑GPU 同步。
Q4:为什么推测解码本地 Batch‑1 场景无效? A:Draft 输出 token 分散到不同专家,触发大量专家权重读取开销;校验阶段 token 行数不匹配硬件最优计算形状,整体得不偿失;批量推理场景下推测解码才有收益。
Q5:Apple Silicon 本地推理最核心瓶颈? A:Decode 阶段权重复用极低,整体受内存带宽约束,不是算力;Prefill 稠密矩阵可以充分利用 Neural Accelerator。

附录 Perplexity Engineering Optimizing On‑Device Inference for Apple Silicon
原文:Perplexity Engineering,2026‑09‑01 标题:针对 Apple Silicon 优化端侧推理:一套自研本地推理引擎,提升 Prefill 与 Decode 吞吐 项目 Lily:专为 Apple Silicon + Qwen3.6‑35B‑A3B 打造,开源 Demo:pplx‑garden 仓库
简介
Perplexity 的混合计算架构,把任务拆分到云端前沿大模型与 Mac 本地模型协同执行。云端模型负责深度调研与复杂推理;Mac 本地模型处理私有文件、本地应用数据。 想要这套分工做到无感流畅,本地推理性能必须跟上整体任务节奏:需要引擎能够快速处理 Prompt,同时维持很高的 token 生成速度。
Lily是 Perplexity 自研轻量本地推理引擎,深度面向 Apple Silicon 与 Qwen3.6‑35B‑A3B,针对 Prefill(提示词预处理)、Decode(token 生成)分别做专项优化。独立演示代码已开源。
1 引言
Mac 上运行大模型主流方案是 MLX,苹果开源的 Apple Silicon 机器学习框架;配套 mlx‑lm 库提供模型加载、文本生成组件。MLX + MLX‑LM 开箱即用,是通用本地大模型推理栈。
Qwen3.6‑35B‑A3B 是稀疏混合专家 (MoE) 模型:采用 MoE 路由机制,同时融合定长循环状态与完整注意力。该架构降低计算量,但带来不规则负载:不同 token 路由到不同专家权重,循环状态本身具备强序列依赖。
MLX‑LM 会为推理阶段、常见负载形状选择优化内核,但它的算子需要兼容海量模型架构。而面向单一 Qwen 模型的专用引擎,可以在模型层、运行时层做深度定制,围绕模型固定结构统筹内核调度、数据搬运、任务调度。
Lily 端到端在单一进程实现这套定制逻辑:
-
Rust 运行时:加载模型权重、管理会话状态、驱动生成循环; -
兼容 OpenAI 接口的 chat‑completions API,支持请求接收与流式输出 token; -
自定义 Metal 内核实现 Qwen 专属算子; 执行链路完全不依赖 PyTorch、MLX。
对比: MLX‑LM:模型被拆解为可组合 MLX 数组算子,MLX 调度通用内核执行; Lily:把模型结构、分阶段执行计划、内核选择全部放到围绕 Qwen+Apple Silicon 构建的 Rust 运行时。
评测指标分开统计:
-
Prefill 吞吐:处理提示词的速度; -
Decode 吞吐:输出生成 token 的速度。
测试硬件:M5 Max,40 核 GPU,128GB 统一内存,运行 Qwen3.6‑35B‑A3B。 覆盖 Prompt 长度、上下文长度:256~128K token。
-
平均 Prefill 吞吐达到 MLX‑LM 的1.23 倍; -
平均 Decode 吞吐达到 MLX‑LM 的1.35 倍。
4K Prompt、4K 上下文场景:
-
Lily:Prefill 5749.9 token/s,Decode 186.6 token/s -
MLX‑LM:Prefill 4737.5 token/s,Decode 140.9 token/s
多轮对话场景下,每一轮模型调用都会累积节省时延。
下文阐述 Qwen 架构在 Apple Silicon 下带来的专属优化空间,详解 Prefill、Decode 优化手段,分析收益天花板,最后给出和 MLX‑LM 端到端对比结果。
2 Qwen 在 Apple Silicon 下的专属优化机会
Qwen 带来三类计算负载形态
Qwen3.6‑35B‑A3B 总参 35B,但每个 token 实际激活仅约 3B 参数。路由模块从 256 个专家子网选出 8 个专家,另有 1 个共享专家处理全部 token。稀疏 MoE 降低计算,但负载不均衡:各个专家分配到的 token 数量差异大,每个 token 需要访问一组不同专家权重。
模型由10 层标准全注意力层 + 30 层 Gated DeltaNet 层构成,两类层保存历史信息的机制完全不同。
-
注意力层采用 GQA 分组查询注意力:16 个查询头,2 个 KV 头,每 8 个查询头复用一组 KV;压缩 KV 缓存,但 Decode 阶段上下文越长,读取缓存的数据量越大。 -
Gated DeltaNet:将历史信息压缩为定长循环状态;通过门控控制历史状态保留程度,增量更新融入当前 token 信息。计算具备序列依赖,下一个状态依赖上一步输出。 Prefill 阶段有两种实现路径:串行扫描迭代更新状态;或者重组成块运算,挖掘矩阵运算与 token 并行。哪种更快取决于模型维度、负载、硬件。
综上 Qwen 产生三类典型计算模式:负载不均的 MoE 专家、随上下文膨胀的注意力缓存、既可串行也可分块计算的定长循环状态。
Apple Silicon 硬件特性适配不同负载
Prefill:一次性大批量 token 行;本地推理大多是 Batch‑1 Decode,每步仅处理 1 行新 token。权重复用模式差异巨大:Prefill 权重可以被成百上千 token 复用;Decode 几乎没有权重复用。
Apple Silicon 采用统一内存:CPU、GPU 共享同一块物理内存池。模型可以常驻内存,不需要额外 GPU 拷贝,但数据搬运依然消耗带宽;片上寄存器、高速存储速度极高但容量很小。
M5 GPU 两套计算通路:
-
Prefill 稠密矩阵:GEMM 矩阵乘,可调用 GPU 每个核心内置的 Neural Accelerator(Metal4 内联 ML 算子); -
Batch‑1 Decode:GEMV 矩阵向量乘,权重复用极低,瓶颈是内存带宽,更适合 GPU 向量 ALU 单元,而不是面向高复用矩阵运算的神经网络加速器。
MLX 同样跑在统一内存之上,会根据负载选择矩阵 / 向量内核。MLX‑LM 对 Qwen 已经做了基础优化:专家任务分组、Metal 融合内核实现 Gated DeltaNet、GQA 优化注意力。这些是 Lily 优化的共同起点。
3 优化策略
Lily 目标场景更聚焦,可以围绕 Qwen 确切架构、参数规格调度硬件资源。整体三点策略:
- 推理阶段匹配 GPU 计算通路
Prefill 大量 token 可复用权重,走矩阵计算;Batch‑1 Decill 单 token 处理,走向量计算通路。 - 映射模型结构,最小化数据搬运
权重保持压缩直到计算时刻;专家路由全程 GPU 完成;Gated DeltaNet 循环状态尽量驻留片上;充分复用 GQA 共享 KV 数据。 - 根据实际负载自适应内核
依据有效 token 行数、专家间 token 分布、算子维度、当前上下文长度,动态选择分块尺寸、执行布局、注意力计算路径。
消融实验说明:在 M5 Max 上做对照实验,只改动待评估优化项,其余配置完全一致;用来分析单项优化收益,不是直接对标 MLX‑LM。
4 Prefill:权重复用,路由计算留在 GPU 侧
Prefill 同时处理大量 token 行,但 token 不均匀分配给各个专家,序列还要迭代更新循环状态。优化分为三块:稀疏专家计算优化、Gated DeltaNet 循环状态驻留片上内存、长 Prompt 分块处理。
稀疏专家计算优化
矩阵乘内部实时反量化
Qwen3.6‑35B‑A3B 采用 4bit 分组仿射量化:权重存为 4bit 整数;每 64 个权重共享一组 bfloat16 缩放系数与偏移。模型体积从 bfloat16 的 70GB 压缩到 19.4GB,可以完整驻留 Mac 内存。
Metal4 张量算子输入要求 bfloat16,需要把 4bit 权重还原。Lily 分组 GEMM 内核:小块权重 tile 在计算过程中就地反量化,放到线程组片上内存,做完乘法立刻丢弃;不会在统一内存生成完整解压权重副本。
消融对照:反量化作为独立算子,先在统一内存生成完整 bfloat16 权重,再读入矩阵算子。512 token Prompt 下,把反量化嵌入 GEMM 内核,Prefill 吞吐提升77.4%,消除中间内存读写开销。
MoE 路由全部在 GPU 完成
分组 GEMM 要求分配到同一个专家的激活行连续排布。流程:路由选出每个 token 对应的 8 个专家 → histogram 统计各专家 token 数量 → 前缀扫描计算偏移 → scatter 重排激活行 → 生成块映射表交给分组 GEMM。
整套逻辑放在同一个 GPU 命令缓冲区。消融对照组会中断 GPU,CPU 读取路由中间结果再下发后续任务。 GPU 侧完成全部路由,内核数量增加,但 MoE 层内部消除 CPU‑GPU 同步。512 token Prompt 场景,Prefill 吞吐提升89%。说明内核数量多少不能直接判断性能,消除同步开销收益更大。
根据专家负载动态调整 Tile 尺寸
2K token Prompt,token‑专家分配共 16384 条,平均每个专家 64 行,但实际分布极不均衡。 分组 GEMM 将输出切分为 Tile 块交给 GPU 线程组。Tile 越大分摊调度开销、并行度越高;专家 token 少的时候大 Tile 会造成计算单元空闲。Tile 尺寸和 simdgroup 数量联动调优。
对照固定 16 行 Tile;切换 32 行 Tile 搭配 4 个 simdgroup,2K token 场景 Prefill 提升13.2%。
Gated DeltaNet 循环状态驻留寄存器
Prefill 中 Gated DeltaNet 按顺序扫描 Prompt 迭代更新状态。对照组采用分块扫描,循环状态反复读写统一内存,每层搬运 256MiB 数据,大量线程屏障同步。
优化内核:循环状态矩阵每一列分配给一个 simdgroup;数据加载进寄存器,全程在寄存器迭代更新状态,simdgroup 内部交互中间结果;扫描全部结束才写回内存。 状态、门控使用 32 位浮点数避免序列迭代误差累积;Query、Key 保持 bfloat16。2K token Prompt,该优化带来 Prefill 提升5.6%。MoE 专家 GEMM 占 Prefill 总耗时约 90%,Gated DeltaNet 串行逻辑很难利用 Neural Accelerator。
Prompt 分块控制峰值临时内存
长 Prompt 切分成多个块处理,权重常驻统一内存;循环状态、KV 缓存跨块保留,不丢弃历史上下文。只保留当前块的激活临时张量,处理完释放,压低峰值内存占用,支持超长输入。 注意力计算时间依旧随 Prompt 长度二次增长,多块 KV 加载带来少量额外开销;是受限内存设备处理超长多轮对话的关键手段。
5 Decode:最小化每个 token 的数据搬运量
Batch‑1 Decode 每次只处理 1 行激活,权重复用极少,性能瓶颈来自每个 token 产生的内存字节搬运总量。优化方向:单行 GEMV 算子优化、全流程 GPU 内闭环、减少中间张量流量、高效读取 KV 注意力缓存。
- 单行权重通路 GEMV
Lily 自研 GEMV,面向单激活行做并行设计,simdgroup 协作计算输出,并行读取权重矩阵分片。 - Decode 步骤闭环留在 GPU
-
Token 交接 GPU 内完成:token 采样选出来直接写入下一轮输入缓冲区,不用传回 CPU 再下发 GPU;双命令缓冲区、双 token 输入槽交替工作,CPU 后台准备任务。消除每一步 CPU‑GPU 同步。 -
依赖感知调度:一个 Decode step 会生成数百 GPU 内核,存在大量可并行任务。使用 Metal 并发 Pass,只在数据依赖点插入屏障,独立内核尽可能并行执行,避免串行排队。 - 融合算子减少中间数据流量
做多组算子融合:专家输入投影 + 门控激活;专家输出投影 + 路由打分 + 共享专家输出;注意力前 Query/Key 预处理;循环更新 + 归一化。中间结果保存在寄存器,不落地内存;同时减少屏障同步点。 - 注意力缓存高效读取
-
合并内存访问 Coalesced loads:让相邻线程访问相邻内存地址,合并内存事务。3840 上下文下,Key 带宽 33.8→47.9GB/s,Value 带宽 42.0→61.8GB/s,Decode 吞吐 +2.1%。 -
GQA 打包:GQA 中 8 个查询头共享一套 KV 头。把 4 个查询头打包进同一个线程组,KV 缓存只加载一次供多头复用;8 次独立加载降为 2 次。32K 上下文,Decode 吞吐提升23.8%。 -
长上下文切换注意力布局:小于 32K 上下文使用通用注意力;≥32K 切换固定分块布局,均衡并行任务负载。32K 场景 + 7.7%;64K+27.4%;128K+40.2%。
6 进一步优化的收益天花板
部分技术在单算子测试收益明显,但端到端没有正向收益:
-
推测解码:Draft 模型预生成 token 交给主模型校验。Batch‑1 场景反而慢 18%;校验阶段 token 分散到不同专家,加重权重读取压力。减小 Draft 词表大小只能提升 Draft 自身速度,整体链路没有加速。(Perplexity 云端批量推理场景推测解码有效,负载完全不一样) -
其他尝试:减少 GPU 提交次数、阶段之间重叠执行、更大 Prefill tile、更广算子融合、路由加速、输出投影和采样融合,均无法提升完整推理循环性能。
硬件带宽实测:MoE GEMM 达到可持续权重读取带宽上限 97.9%;GEMV 达到 90.3%。删减算术计算对吞吐几乎无影响(仅变动 0.2%),证明瓶颈是内存带宽而非计算。Prefill 矩阵乘隔离测试达到理论峰值 93%;嵌入完整模型后 80‑86%。硬件层面剩余优化空间已经很小。
7 端到端性能
对比基准 MLX‑LM 最快原生生成链路,不包含服务层开销;两者加载完全相同 4bit 权重,M5 Max,Batch‑1;交替运行消除后台负载、芯片温度干扰。测试区间 256‑128K。
-
Prefill 吞吐:短提示词随 token 上升摊薄调度开销,4K 附近到达峰值;长提示词受 10 层全注意力层影响性能回落。 -
Decode:短上下文性能平坦;上下文持续增长后 KV 缓存读取开销上升,性能下滑。 Lily 在全部测试长度下均更快:Prefill 为 MLX‑LM 的1.12‑1.42 倍,Decode 1.31‑1.37 倍。
浮点运算顺序改变带来数值偏差:做 teacher‑forced 对齐测试;Lily 困惑度仅高出 0.04%;96.35% 测试位置输出 top‑1 token 与 MLX‑LM 一致。
8 面向本地平台设计
Apple Silicon 不等同于小型数据中心 GPU:统一内存可以把超大模型、状态全部驻留本地;M5 Neural Accelerator 承接 Prefill 稠密矩阵;向量 ALU 扛住 Decode 带宽受限场景。
针对 Qwen 架构的定制手段:专家路由、循环状态驻留 GPU;消除中间张量;并行调度独立任务;复用 GQA KV 缓存;依据负载自适应内核参数。依靠模型 + 硬件联合定制,单台 Mac 就可以高效运行大型稀疏 MoE 模型。
未来工作:扩展更多模型、芯片、服务负载;把本次验证的机制泛化为通用运行时策略。
核心思想:推理引擎必须同时适配模型架构与硬件的计算、内存通路。随着开源大模型与硬件迭代,高性能本地推理越来越需要专用引擎,而不是抹平软硬件差异的通用抽象层。