

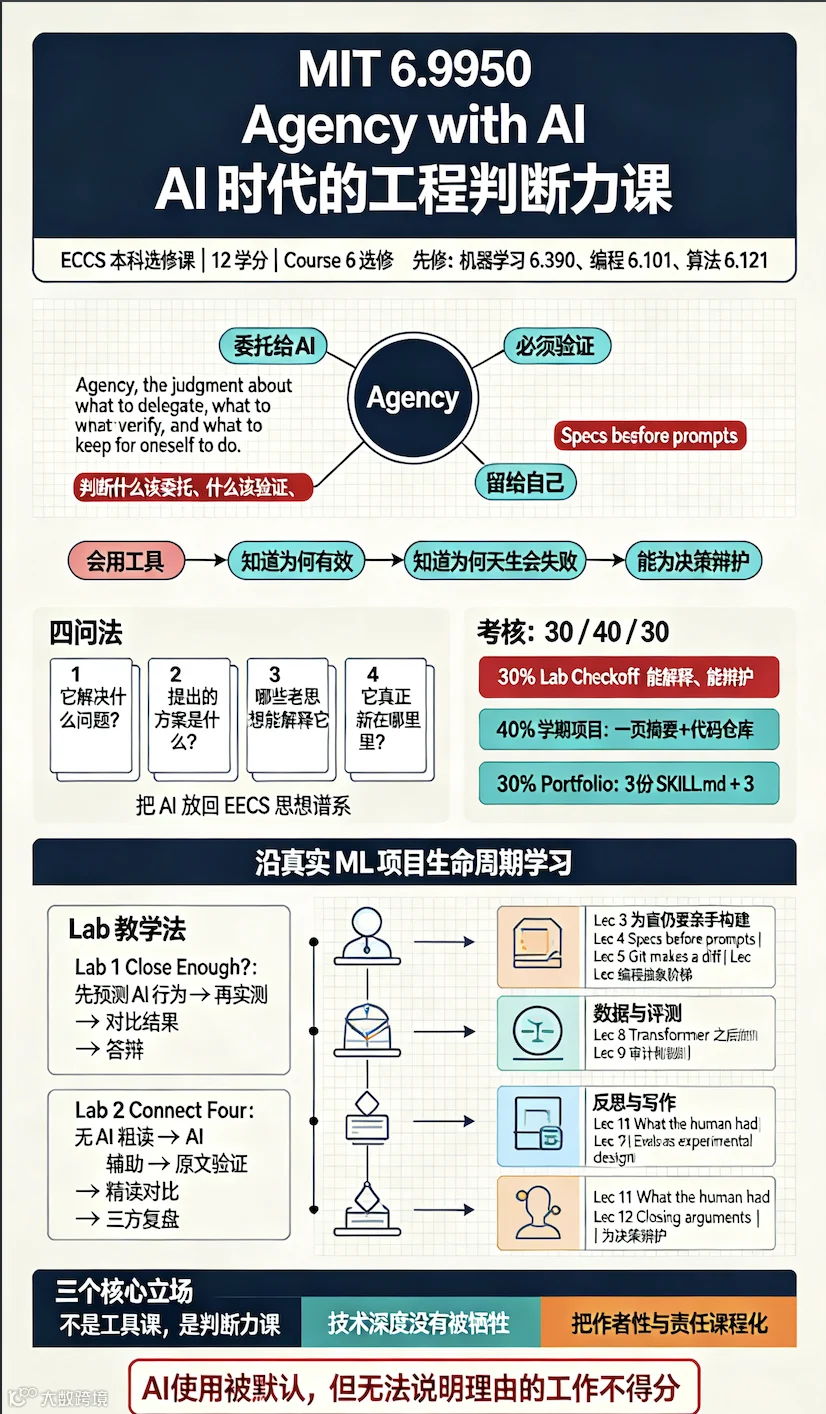
编者摘要:MIT 2026 秋季新开选修课 6.S950《Agency with AI》,面向具备机器学习、算法、编程基础的本科生,它并非 AI 工具教学课,而是一门塑造 AI 时代工程判断力的课程。课程核心概念 Agency(代理权),即判断任务中哪些委托 AI、哪些必须验证、哪些需要亲自完成。课程提出 “增量四问法”,审视任何 AI 技术:解决什么问题、方案是什么、有哪些传统思想支撑、创新增量在哪,破除 AI “魔法化” 认知。
课程沿机器学习项目生命周期分为四大模块共 12 讲:定框与阅读、构建与 Harness 工程、数据与评测、反思与写作。标志性理念为Spec 先于 Prompt:写提示词前必须定义规格、边界条件与验收标准;同时强调 Git 作为人机协作的问责账本,保留改动溯源证据。课程强调模型失效是架构权衡的必然结果(fail by construction),评测本质是实验设计,并且要双重审计产出物与裁判,LLM 评审乃至人类评审都自带偏见。
配套 Lab 极具巧思,通过控制 AI 是否参与,把人机分工决策本身作为实验,要求预先预判 AI 缺陷,留存证据,最终脱机答辩。考核由 Lab 答辩、学期项目、个人资产库 Portfolio 三部分构成,核心规则:允许使用 AI,但无法解释、不能辩护的成果不得分。课程最后探讨作者性、默会知识等议题,警示过度外包会侵蚀人的研究能力。整体是 MIT 对 AI 时代工程教育的系统性回答:工程重心从产出成果,转向决策的可辩护性。

10个关键问题Q&A
-
Q:这门课和普通 LLM 提示词课最大区别是什么? A:普通课教怎么用 AI 工具;本课训练工程判断力,重点是人如何做「委托 / 验证 / 自留」决策,要求决策可辩护。 -
Q:Agency 代理权在课程里的准确含义? A:判断哪些任务交给 AI、哪些结果要核验、哪些工作必须自己动手完成的工程判断力。 -
Q:什么是四问增量思维(Delta Thinking)? A:分析技术四维度:解决什么问题、方案是什么、哪些旧理论可解释、真正新增的创新点,避免神化 AI。 -
Q:“Spec 先于 Prompt” 是什么意思? A:先写输入输出、边界条件、验收标准的规格文档,再写提示词;Prompt 只是规格的口语化表达。 -
Q:课程提到 fail by construction,如何理解? A:模型失败不是偶然 bug,是底层架构设计权衡带来的固有缺陷,理解机制才能提前预判风险。 -
Q:为什么课程仍然要求学生亲手写代码? A:看懂、验证代码的前提是理解;亲手构建培养调试能力,项目责任不能外包给 AI。 -
Q:双重审计(audit artifact and judge)指什么? A:既要审计 AI 产出(代码、数据集),也要审计评审者,不管是 LLM-as-judge 还是人类,二者都存在固有偏见。 -
Q:Git 在 AI 人机协作中的新定位? A:不再只是备份工具,是责任溯源账本,区分人与 AI 改动,用于审查、回滚,留存证据。 -
Q:课程考核是否禁止使用 AI? A:不禁止 AI 使用。但任何成果,只要学生不能解释决策、无法辩护,直接不得分。 -
Q:课程第 11 讲 “What the human had” 核心警示是什么? A:大量任务委托 AI 会慢慢丢失研究者独有的默会知识、问题品味与作者性,存在隐性能力损耗。 附录 MIT 6.S950《Agency with AI》课程全景解读整理
课程定位:MIT EECS 2026 秋新开本科选修课,12 学分,讲师 Shen Shen;不是 AI 工具课,是 AI 时代工程判断力课程。前置硬门槛:机器学习 6.390、编程 6.101、算法 6.121,面向已有扎实 ML 与 CS 基础的学生,不讲授基础,聚焦「在真实机器学习项目里正确使用 AI」。 官网:https://agencyai.mit.edu/
一、核心定义:Agency(代理权)
Agency, the judgment about what to delegate, what to verify, and what to keep for oneself to do. 代理权:判断什么委托给 AI、什么必须验证、什么必须自己亲手完成。
核心学习递进链
会使用 AI 工具 → 理解工具为什么有效 → 理解工具天生的失效机制(fail by construction)→ 对每一项任务做出「委托 / 验证 / 重定向 / 保留」决策,并且能够有理有据地辩护该决策。
贯穿全课的四问分析法(Delta Thinking 增量思维)
审视任意 AI 技术 / 论文概念,固定问 4 个问题,将 AI 放回计算机科学思想谱系,祛魅,拒绝把 AI 当成魔法:
-
它要解决什么问题?(动机 motivation) -
给出的解决方案是什么?(方案 solution) -
有哪些经典旧思想可以解释它?(old idea) -
它真正新增的差异是什么?(delta)
二、课程整体架构:跟随 ML 项目全生命周期,4 模块 12 讲
模块一:定框与阅读|AI 时代如何做研究阅读
Lec1 What this course is|课程立宪
-
定义 Agency;确立四问法;建立评分契约:允许使用 AI,但无法解释理由的作业不得分。考核的不是用不用 AI,而是决策的可辩护性。
Lec2 Reading matters|阅读本身依然重要
-
四问法读论文;识别 AI 摘要常见幻觉;对 AI 输出做原文核验(支持 / 矛盾 / 无法判定);产出领域地图 Field Map。 -
Lab2 实操:无 AI 粗读 → AI 辅助答疑 → 核验 AI 论断 → 无 AI 精读 → 对比「粗读 / 精读 / AI」三方认知,定位自己理解偏差。
模块二:构建与 Harness|人机协作构建工程
Lec3 Why still build|既然 AI 能写代码,为什么人还要亲手实现
-
核心观点:验证的前提是理解;看不懂就无法校验;亲手构建的价值不是产出代码,而是获得调试与风险判断能力;项目责任不可外包。
Lec4 Specs before prompts|规格先行,提示词在后(课程最出圈理念)
-
Prompt 本质是一份不完整的 spec;先定义输入输出、边界条件、验收标准,再写提示词;把人和 Agent 的关系看作甲方与承包商,spec 是合同。
Lec5 Git makes a diff|版本控制作为人机协作问责基础设施
-
Git 不只是备份;diff 记录 AI 改动、划分责任边界;利用提交记录区分「人写」与「AI 生成」,实现可审查、可回滚,保留溯源证据 provenance。
Lec6 The abstraction ladder (of programming)|编程抽象阶梯
-
LLM/Agent 只是计算机抽象层中新的一层,和编译器、操作系统逻辑一脉相承:用可控的不透明换取效率;调试需要向下穿透抽象;上下文管理就是这一层的内存管理;Harness 脚手架工程是必备配套。
模块三:数据与评测|信任不是默认值,评测即实验设计
Lec7 Outsourced data|审查外部 / 外包数据集
-
核查数据源、许可、数据污染、分布偏移、标注质量;AI 批量生成数据带来新风险:垃圾数据可以自动化大规模生产。
Lec8 The machinery beyond vanilla transformers|基础模型底层失效根源
-
跳出原生 Transformer,拆解 RLHF、MoE、RAG、工具调用、长上下文等扩展机制;失败不是 bug,是架构权衡带来的必然结果(fail by construction);只有懂底层,才能预判失效模式。
Lec9 Evals as experimental design|评测 = 实验设计
-
评测不是跑 Benchmark;需要假设、对照组、统计显著性;警惕 Goodhart 定律、基准过拟合、数据污染;针对预判的失效模式设计评测方案。
Lec10 Auditing the artifact and the judge|双重审计:审计产出物,同时审计裁判
-
审计 artifact:模型输出、数据集、代码; -
审计 judge:LLM-as-judge 存在长度偏好、位置偏差、自偏好;人类评审本身同样存在偏见,人不是天然的黄金标准。
模块四:反思与写作|守住研究者的作者性
Lec11 What the human had|人类研究者曾经拥有什么
-
讨论默会知识、问题品味、作者署名、责任;核心命题:委托 AI 存在隐性成本,外包实践会慢慢丢失研究者自身能力。
Lec12 Closing arguments|结案陈词
-
学生当庭辩护自己一学期的委托 / 验证决策;一页纸学术摘要范式:Claim/Evidence/Limits;学生案例甚至可以质疑课程本身的观点;课程论断本身也需要被审计。
三、实验 Lab 设计(课程教学设计精华)
Lab 设计核心思路:控制 AI 在场与否,把人机决策本身当成实验对象,留存完整证据链
- Lab1 Close Enough?
手写 kNN 分类器 1)禁用 AI,提前预估:工作量、AI 实现准确率、预期 AI 错误、验收标准; 2)允许 AI 实现,用预先定义标准校验,留存对话证据; 3)对比第三方现成模型:输出一致 ≠ 系统等价; 4)Checkoff 答辩:脱离 AI,口头解释全部逻辑。 - Lab2 Connect Four
论文对精读(如 BatchNorm vs LayerNorm) 无 AI 粗读 → AI 辅助解惑 → 核验 AI 观点 → 无 AI 精读原文 → 三方对比复盘理解偏差,迁移到新论文阅读。
四、考核体系(30+40+30)
-
30% Lab Checkoff:答辩制,重点是解释、辩护你的决策; -
40% 学期项目:可复用 UROP/MEng 科研项目,交付一页摘要 + 代码仓库; -
30% Portfolio 个人资产库:3 份可复用 AI 工作流 SKILL.md + 3 个真实 AI 使用案例,案例可以支持或反驳课程观点。
核心考核原则:AI 允许使用,不限制使用量;任何无法说明理由的成果,无论效果多好,不得分。
五、课程三大核心立场(MIT 对 AI 时代工程教育的回答)
-
重心从「产出成果」转向决策可辩护性,要求完整证据链,保证人机混合产出可审查; -
不牺牲技术深度:必须理解模型底层机制,才能预判失效;不是简单提示词技巧培训; -
将工程领域过去回避的人文议题课程化:作者性、署名、责任、默会知识,直面 AI 对研究者能力的侵蚀。