导读
本文整理自腾讯高级算法工程师巫晓杰在 Agentic AI Summit-2026-深圳站上的分享。腾讯围绕金融营销合规审核进行了持续实践,内容涵盖智能体架构、多模态长图解析、规则 Skill 化、外部证据查询、专项模型训练,以及规则与模型双轨自进化。
主要内容包括:
1. 人工审核的痛点:风险识别维度的扩展
2. 规则 Agent 化:从长图解析到完整证据链
3. 专项小模型训练:金融合规的定制化能力
4. 双轨自进化机制:规则快轨与模型慢轨的协同
5. 现场问答交流
分享嘉宾|巫晓杰(腾讯 高级算法工程师)
编辑整理|姚昊 内容校对|韩珊珊 出品社区|DataFun
01
人工审核为什么扛不住:风险早已不只藏在文案里
金融营销合规审核并非简单的文案检查。从公开监管案例来看,违规问题主要集中在两方面:一是流程缺失,如宣推海报未经有效合规把关,存在风险揭示和人员资质问题;二是选择性披露,仅展示局部亮眼业绩而隐瞒完整表现。
这两类案例表明,一次完整的合规判断需同时核对内容、数据、主体和流程,最终形成完整的证据链。

此外,审核对象已从纯文本(客服消息、App弹窗)扩展至海报、Banner、产品长页、短视频和直播等多模态素材。传统“接收素材—排队分派—人工判断—抽检复核”的线性流程中,素材量的增长直接意味着人力的同步扩张。这导致了覆盖率不足、审核周期长(以天/周计)、判断标准不一等问题,且新规发布后人工难以快速适应标准落地窗口期。

为此,系统将目标重新定义为四个核心能力:看得全、判得快、判得准、跟得上,将多素材统一接入、发布前审核、稳定复核和新规快速生效转化为系统级能力。

02
把法规变成 Agent 能执行的规则:从长图解析到证据链
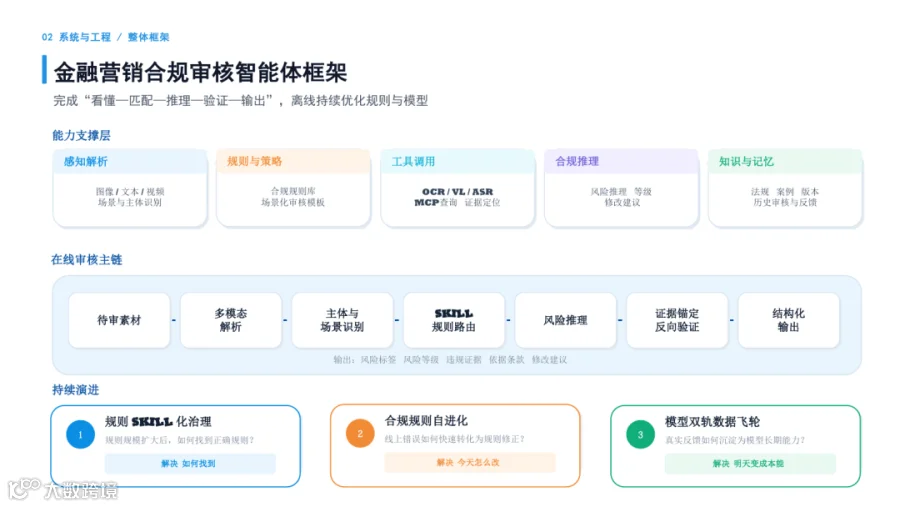
整体在线链路设计为:待审素材进入后,先进行多模态解析与主体/场景识别,再执行 Skill 规则路由、风险推理、证据锚定与反向验证,最终输出风险标签、等级、违规证据、依据条款和修改建议。其底层支撑能力包括感知解析、工具调用、规则策略、合规推理、知识与记忆;离线侧则负责规则 Skill 化治理、规则自进化和模型数据飞轮。
感知解析:图像识别与长图解析挑战
基金宣推长页通常包含产品信息、业绩图表、基金经理介绍及底部风险提示,需兼顾内容完整与视觉空间关系。纯 OCR 会丢失图表与位置信息;而通用多模态模型处理长图时,易漏掉底部小字、产生幻觉或无法解析复杂图表。

工程上采用三阶段处理方案:先按视觉边界、背景变化和 OCR 文字框做语义切图(保留相邻重叠);再逐片输入多模态模型提取文字、图表及位置关系;最后按原图坐标排序、去重并语义拼接。改造后,召回率从 90.15% 提升至 97.59%,F1 从 94.73% 提升至 98.67%,漏字率降至 2.41%,平均耗时由 16 秒微增至 21 秒。

合规规则底座与 SKILL 化治理
规则底座分为基础法律、金融专项规则、内容与 AI 治理三层,并持续接入监管通报与行业自律规则。每条入库规则均附带法规文号、原文、适用主体/场景、状态及案例依据,确保可追溯。

法规原文直接交由 Agent 存在五个执行断点:内容冗长分散、边界抽象、适用范围不清、缺乏证据与处置结构、新旧版本口径漂移。对此,工程改造分五步:按主体/产品/渠道/时间映射;条款原子化(主体/行为/对象/条件/例外/阈值);构建适用范围矩阵;补齐决策条件与人工路由;通过正/反/边界例验证后版本化发布。

在基金宣推场景中,标签体系负责路由,结构化规则负责判定,全面覆盖宣传表述、历史业绩、指数数据等风险维度。

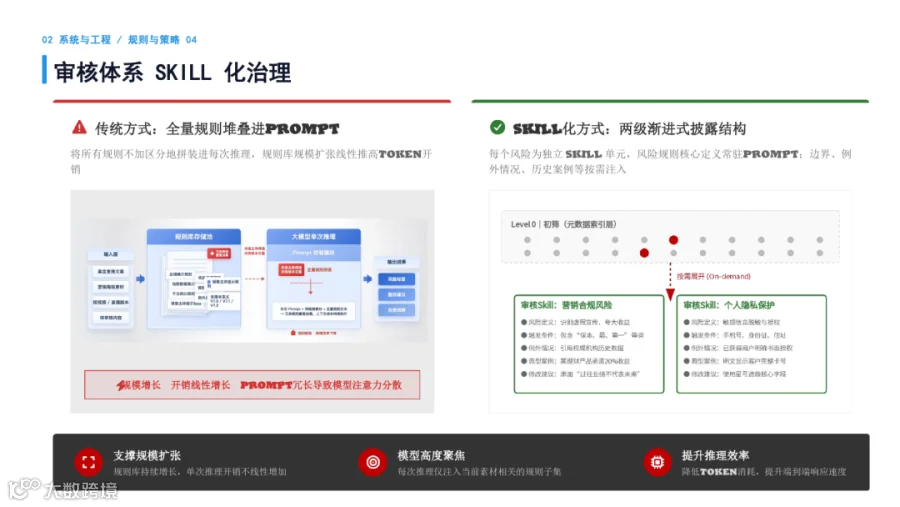
随着规则增多,全量输入 Prompt 会导致 Token 开销线性激增。系统采用两级渐进式披露:核心定义常驻 Prompt 进行高召回初筛;命中风险后,再加载对应 Skill 的边界、例外与历史案例,确保单次推理仅关注相关规则子集。
工具调用与证据锚定
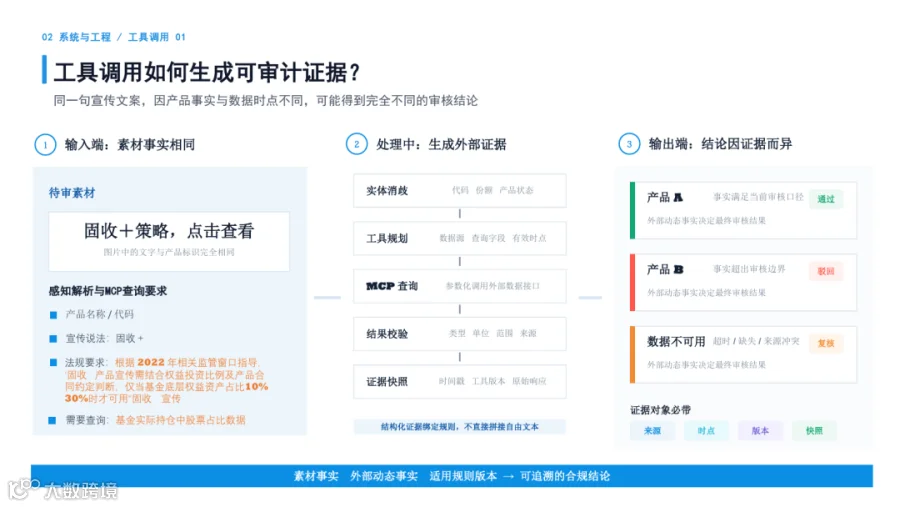
合规结论依赖动态事实(如“固收+”需结合真实持仓)。系统先进行实体消歧,规划数据源与查询字段,通过 MCP 参数化调用外部接口。数据经多重校验后,生成带时间戳和工具版本的证据快照。数据异常时自动降级至人工复核。
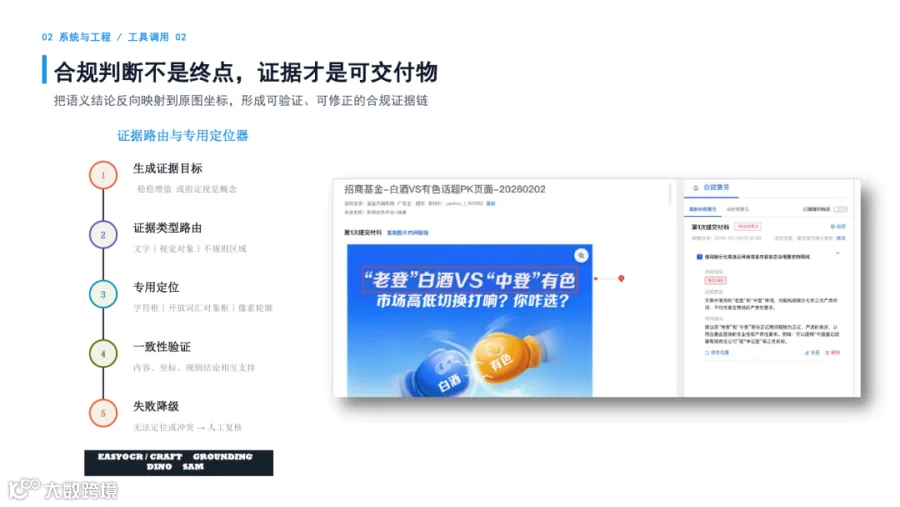
合规判断不是终点,证据才是可交付物。系统将结论反向映射回原图坐标(文字字符框、视觉对象框、像素轮廓等),结合 EasyOCR、Grounding DINO、SAM 完成精准定位。
03
为什么还要训小模型:金融合规要的不是“通用能力”
自研模型:小参数、高准召、低时延
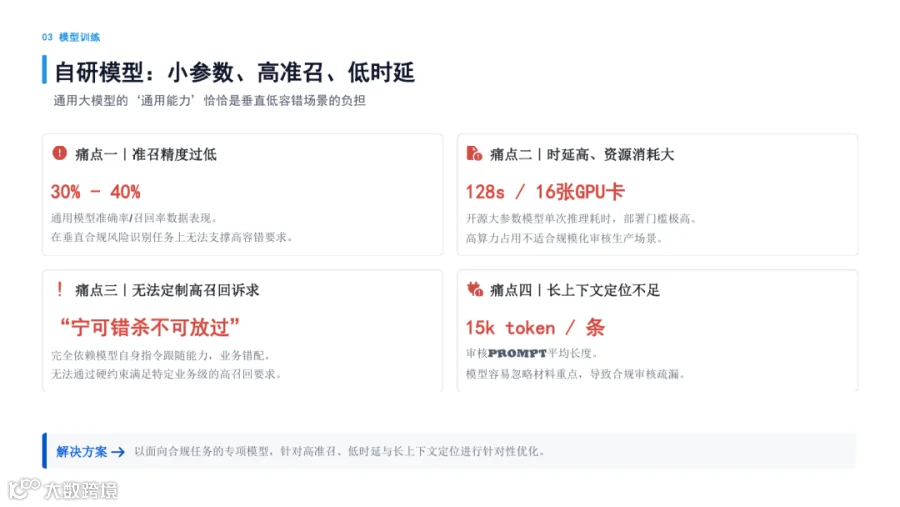
通用大模型在金融审核场景面临四大痛点:垂直风险识别准召率仅 30%-40%;大参数模型推理慢(达 128 秒)且算力成本高;通用训练目标难以满足“高召回优先”的业务要求;长 Prompt(约 15k token)易导致注意力分散。因此,团队聚焦于训练高准召、低时延、长上下文定位的合规专项小模型。
训练分为数据合成、指令微调(SFT)、奖励模型与强化学习(RL)三个阶段。

数据合成采用正反向双路径:反向从金标风险样本修正生成无风险文本,再按标签生成新样本;正向处理无标注素材,通过 OCR、长图拆分与多模型打标合并,并经人工确认。

SFT 专注于审核要求与结构化输出,避免过度训练;RL 则基于合规四元组与各类反例构造 Pair 偏好数据,训练 Model-based 与 Rule-based 奖励模型。
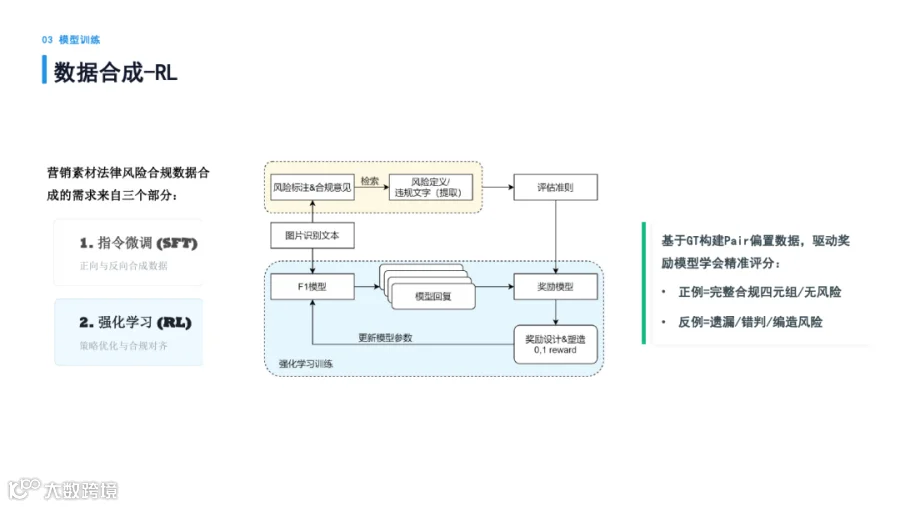
SFT/RL 组合的三个关键决策:数据覆盖原生/合成、有/无风险及长尾类别;SFT 保持轻量以释放 RL 探索空间;基座选择采用 Pass@8 评估潜在上限。

强化阶段的目标函数按业务调整:合规审核更惧漏检,因此采用 F2 指标,将召回权重放大至精确率的 4 倍。

04
规则今天改,能力明天长出来:双轨自进化怎么跑
合规规则自进化
“自进化”并非让 Agent 自行修改规则并上线。系统输入来自法务复核的误判/漏判、主动扫描的监管信号及规则冲突检测。AI 负责归纳规则盲区并生成建议,法务进行确认或驳回。确认后的规则直接进入规则库,下次推理动态加载,无需重训模型,更新频率可达小时级。
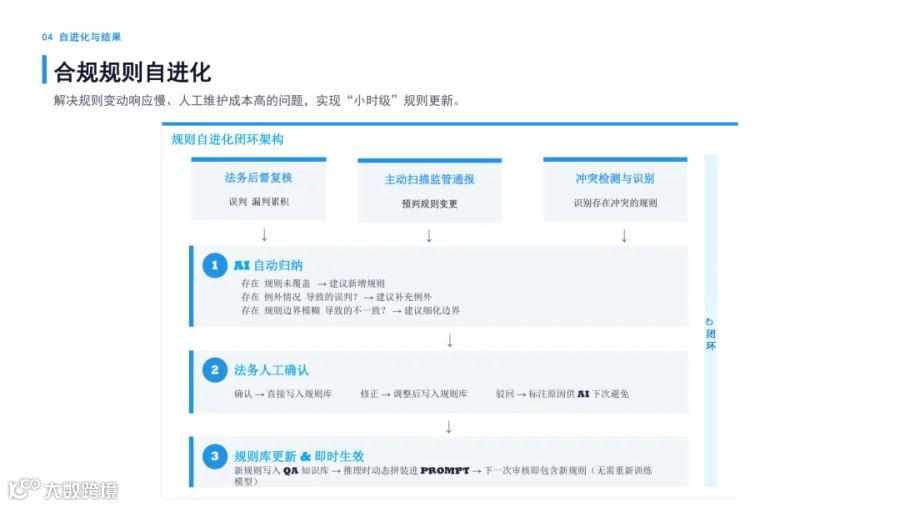
双轨自进化机制
规则轨解决“今天的问题今天改”,将法务反馈直接转化为 Skill 更新;模型轨负责将经验沉淀为能力,把确认/修正/驳回标签转化为强化学习信号,周期性进入 GRPO 再训练。两轨共用同一真实反馈源,分别处理短周期规则变化与深层模型能力演进。

落地效果与结论
落地结果显示:审核从抽检转为全覆盖,周期从 3-5 天缩短至分钟级;专项模型召回率 95%+、精确率 80%+;单次推理从 671B 模型的 128 秒降至自研 32B 模型的 40 秒,耗时下降 69%,算力成本节约 75%;规则更新从周级缩短至 AI 辅助归纳的小时级。
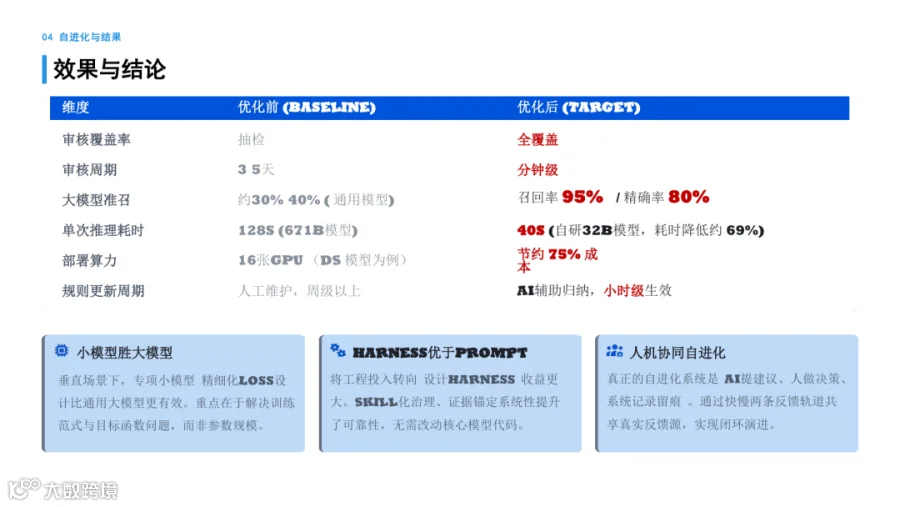
实践得出三个核心判断:在垂直、低容错且标准明确的任务中,小模型胜过通用大模型的关键在于数据、训练范式和目标函数是否贴合业务;相比堆砌 Prompt,将工程投入聚焦于 Harness、Skill 化治理和证据锚定 能显著提升可靠性;自进化必须保留人的决策权,AI 提建议、法务确认、系统留痕,反馈再分流至规则快轨与模型慢轨。
05
现场问答
Q1:这套 Harness 是从零搭建,还是基于开源智能体二次开发?
A:该场景此前已有长期的工具化积累,因此未直接套用通用 Harness,而是围绕已有链路自行搭建。
Q2:基金宣推审核大概有多少个 Skill?
A:基金场景有 20 多个 Skill,本质上按风险拆分。更广的业务范围合计达数百种,但每次仅根据业务、主体和条件按需加载。
Q3:什么场景更适合做垂直微调?
A:当需求量大、任务难度高、边界明确、评估标准规则化,且具备充足场景数据时,垂直模型收益更稳定。分享中使用的是 32B 模型。团队观察到明显的“跷跷板效应”:垂直能力提升后通用能力通常会下降,若两者兼顾,往往需由不同模型分担。