


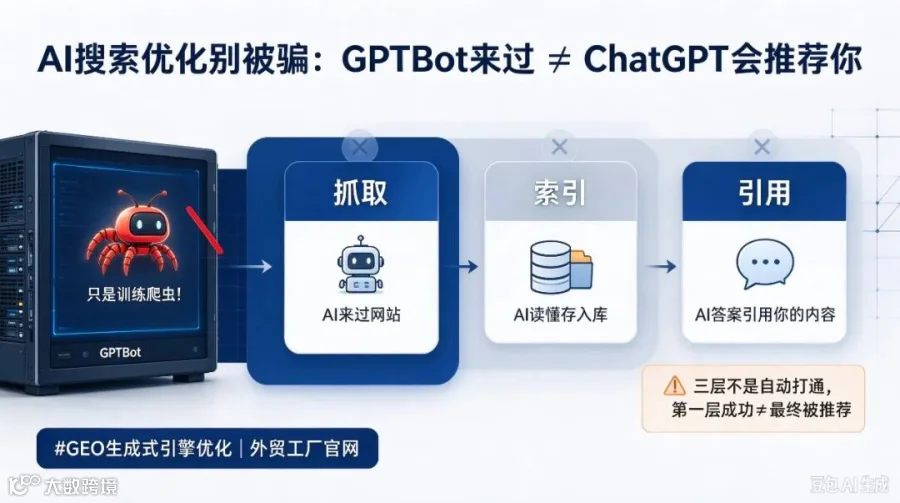
近期,一位五金制造企业负责人在检查网站访问日志时,发现AI爬虫(GPTBot)的记录,误以为其网站已被ChatGPT收录。事实上,仅凭单一爬虫记录并不能证明网站实现了AI搜索可见性。生成式引擎优化(GEO)是一项系统性工程,准确理解AI搜索引擎的抓取、索引与引用机制,是企业开展AI搜索优化的前提。
核心认知:AI搜索优化的三大阶段
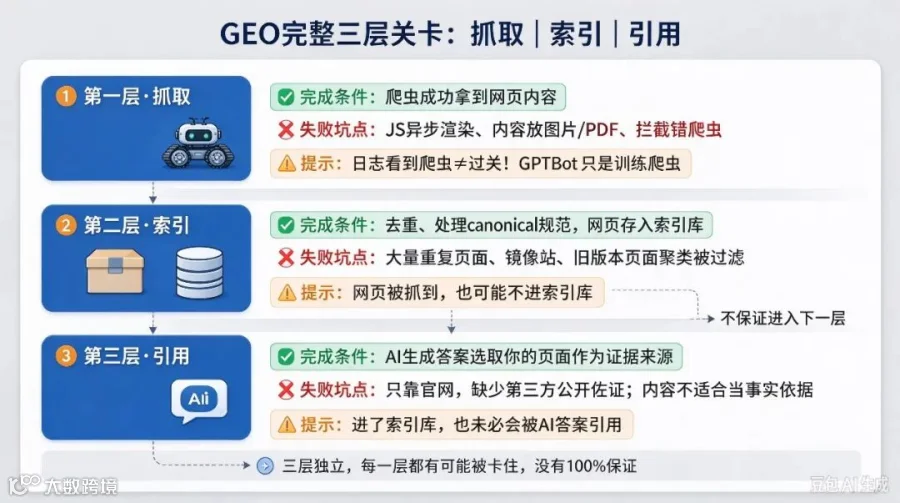
“AI看过我的网站”并非单一动作,而是包含三个严格依序的环节:抓取(获取内容)、索引(保留内容)和引用(在回答中呈现)。这对应了AI搜索优化中最核心的流程。
Google官方文档明确指出,搜索分为抓取、建立索引、提供结果三个阶段,且“并非所有网页都会经历各个阶段”。即使网页符合基础规范,也不保证一定会被抓取、索引或呈现。“不保证”是生成式引擎优化的客观底色,任何承诺“包收录、包展现”的说法均违背行业常识。
爬虫识别:训练类与搜索类的区别
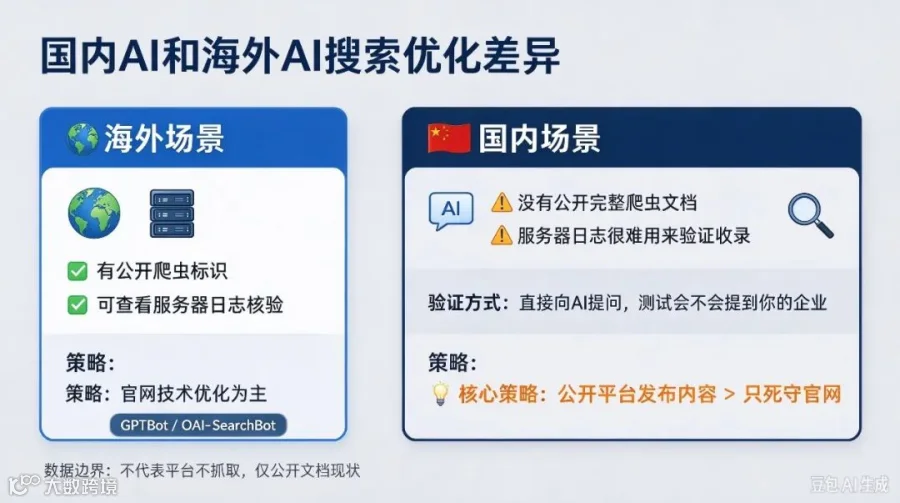
AI厂商通常配备多个功能各异的爬虫。以OpenAI为例,GPTBot负责抓取内容用于模型训练;决定内容能否在ChatGPT搜索中出现的,是OAI-SearchBot;而ChatGPT-User则用于用户提问时的实时页面访问。Anthropic的Claude系列也遵循类似逻辑(ClaudeBot管训练,Claude-SearchBot管搜索,Claude-User管实时访问)。
日志中出现训练类爬虫,不能作为搜索可见度的证据。将两者混淆是AI搜索优化自查中的常见误区。此外,仅凭日志中的“GPTBot”字样不足以证明爬虫身份,规范的核验需通过反向DNS与官方公开的IP段比对完成。

索引机制:内容去重与规范化
内容被抓取后,需经过索引阶段。引擎会解析正文、判断重复并收集信号。对于制造企业而言,最容易在“canonical聚类”环节吃亏。若网站存在大量相似的产品页、PDF版本、旧页面或多语言镜像,搜索引擎会将其归为同一内容的多个版本,仅保留一个代表页面。你以为有几十个页面,实际留下的可能只有十几个。
因此,在AI搜索优化中,优先清理重复和镜像内容,比盲目增加新页面更具效益。
引用逻辑:内容权威性决定AI采纳率
进入引用阶段后,内容由AI的检索和生成机制接管。即使顺利抓取并索引,也不意味着会被AI引用。KDD 2024的一项研究表明,在补充来源引用后,原本排名第5的页面可见度大幅提升115.1%,而排名第1的页面可见度反而下降30.3%(注:此为实验室条件下的相对变化)。
这说明在AI生成的答案中,传统搜索排名优势被削弱,内容是否具备“证据价值”成为核心变量。同时,多伦多大学的研究显示,AI引擎对第三方内容的偏好高达53%至95%。这意味着企业仅靠官网不够,还需在公开平台建立内容背书。

避坑指南:robots.txt的正确配置
许多企业为防止内容被用于AI训练,在robots.txt中设置“禁止所有访问”或在CDN开启“拦截所有AI爬虫”。这种“一刀切”的做法会误杀搜索类爬虫,导致网站在AI搜索结果中彻底消失且无通知。
官方文档明确各爬虫标识相互独立,正确的做法是分类处理:按需屏蔽训练类爬虫,但必须放行搜索类爬虫。在GEO策略中,robots.txt并非单一开关,而是需要精细化配置的控制矩阵。
国内市场:日志验证的局限与应对策略
对于豆包、DeepSeek、文心一言、Kimi等国内主流AI引擎,目前尚无公开且可核对的专用爬虫文档(仅字节跳动的Bytespider有部分公开资料归为训练类)。这意味着在国内市场,依赖服务器日志验证AI收录情况并不可靠。
CNNIC报告显示,生成式AI用户中高达80.9%主要用于“回答问题”。对长三角、珠三角的制造企业而言,在国内AI抓取机制不透明的情况下,将优质内容分发至公开权威平台,比单纯依赖官网更为务实。这也决定了国内与海外GEO策略的差异。
实操建议:低成本完成GEO基础自查
针对中小企业,可通过以下三个步骤完成基础的AI搜索优化自查:
1. 直接提问验证现状
将产品规格、品类、地区等核心信息转化为用户提问话术,在各大AI引擎中进行测试,检查回答中是否提及自身企业及信息的准确性。这是最基础且成本最低的验证方式。
2. 精准核查访问日志
区分日志中的爬虫类型:忽略训练类爬虫,重点监控搜索类爬虫,并结合官方IP段进行严格核验。
3. 规范配置robots.txt
检查网站根目录下的robots.txt文件,确保未误拦搜索类爬虫。注意,该文件必须放置在域名根目录,置于子目录将不被爬虫识别。
核心问答:AI搜索优化常见疑虑
问:在AI中搜索自己,算作有效验证吗?
答:这是国内引擎目前唯一可行的基础验证方式,但结果存在波动性,仅适用于定性判断,不能作为绝对的定量指标。
问:日志中的爬虫记录能作为优化证据吗?
答:需区分类型。训练类记录无效;搜索类记录具参考价值,但前提是必须通过IP段核验真伪。
问:AI搜索优化多久能见效?
答:无法承诺具体周期与结果。Google和Bing官方均不保证内容必然被索引。Bing提供的观察面板仅为参考指标,而非排名系统。
总结:GEO的核心逻辑与避坑指南
生成式引擎优化的完整链条即抓取、索引、引用。抓取决定内容可达性,索引检验内容独特性,引用考量内容权威性。企业开展GEO,首要任务是建立正确的评估指标,避免因误判爬虫日志而在无效动作上浪费资源。先厘清现状,再制定优化策略,才是科学的发展路径。
参考资料
-
Google Search Central,搜索工作原理官方指南,2026年查证。 -
OpenAI,爬虫文档(GPTBot / OAI-SearchBot / ChatGPT-User),2026年查证。 -
Anthropic 帮助中心,爬虫用途与屏蔽方式说明,2026年查证。 -
Aggarwal et al.,KDD 2024,Generative Engine Optimization,DOI 10.1145/3637528.3671900。 -
多伦多大学,arXiv:2509.08919(未经同行评审),2025年。
数据与效果边界声明
本文引用各平台公开文档在写作时的表述,厂商策略可能调整,以官方最新版为准。国内AI引擎未公开专用爬虫文档,相关判断已标注为“未找到官方文档”,不作为最终结论。实验数据为实验室条件下的相对变化,不代表真实环境的必然结果。