大数跨境

Kimi 和 DeepSeek,为什么出现在同一张模型架构图里?

Kimi 和 DeepSeek,为什么出现在同一张模型架构图里? AI科技评论
2026-09-24
3
导读:大模型 Attention 路线变迁:从分流到重组。
大模型 Attention 路线变迁:从分流到重组

    作者丨李娜

    编辑丨岑峰

一张大模型架构图里,同时出现了 Kimi 和 DeepSeek 的影子。
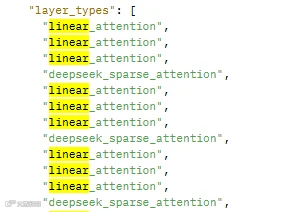
GLM-5.3-Flash项目配置文件:45层架构中,34层采用Kimi路线的KDA线性注意力,另外11层采用DeepSeek路线的KPool-DSA稀疏注意力
今年以来,大模型架构演变出一条清晰的趋势:在混合注意力架构中,原本由全局Attention(全局注意力)承担的角色,正逐渐被 Sparse Attention(稀疏注意力)接替。
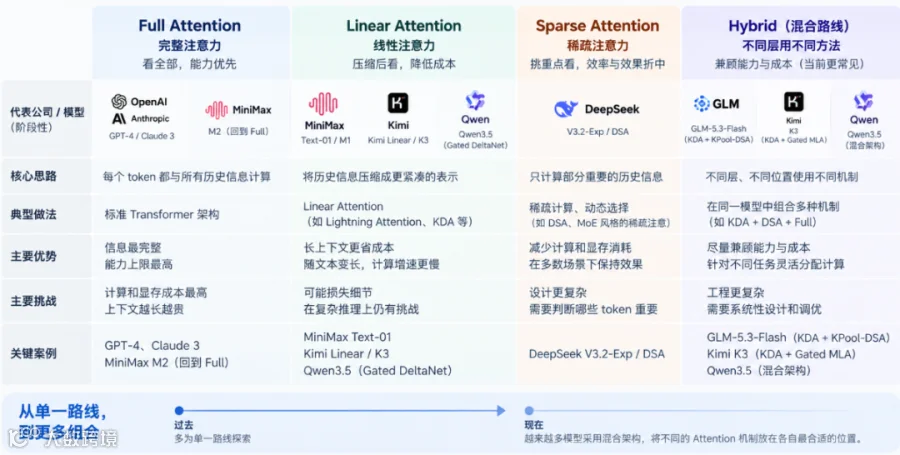
Attention机制的核心在于:模型在处理当前Token时,能否从不断增长的上下文中精准提取有效信息。目前主流的Attention机制可分为三类:全局注意力(Full/Global Attention)直接读取完整历史,信息保留最全但计算成本最高;线性注意力(Linear Attention)将历史压缩为紧凑状态,降低长序列计算成本;稀疏注意力(Sparse Attention)保留完整历史,仅选择关键信息参与计算。
过去几年,业界对Attention的改造本质上是在能力与成本间寻求平衡。作为折中方案的混合注意力架构逐渐流行:高效Attention负责降本,少量全局Attention保留完整历史访问权限。
从不同Attention路线,看大模型公司的选择
今年,部分混合架构中全局Attention的角色,开始显现出被Sparse Attention替代的迹象。
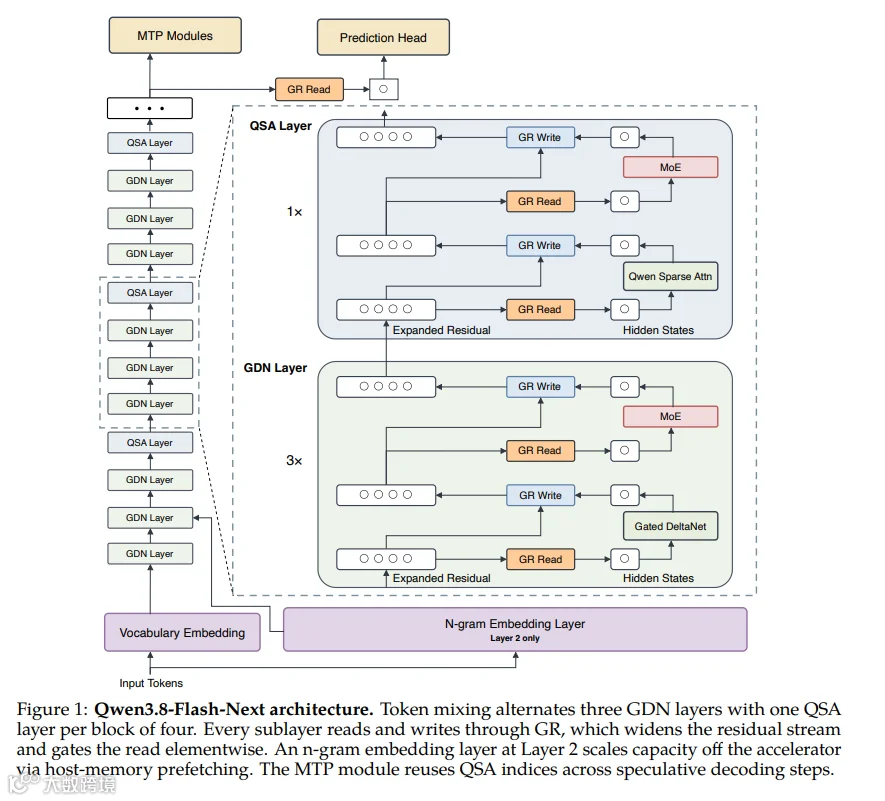
8月发布的 Qwen3.8-Flash-Next 便是典型。它延续了三层 Gated DeltaNet 配一层 Attention 的结构,但原本负责全局精确读取的 Attention 层,被改造为 Qwen Sparse Attention 高效机制。
 Qwen3.8-Flash-Next 架构图:每四层里,三层是 GDN,一层是 QSA
当具体的Attention技术变为可流动的组件,一家大模型公司的“技术路线”究竟意味着什么?

一、MiniMax最终保留Full Attention兜底

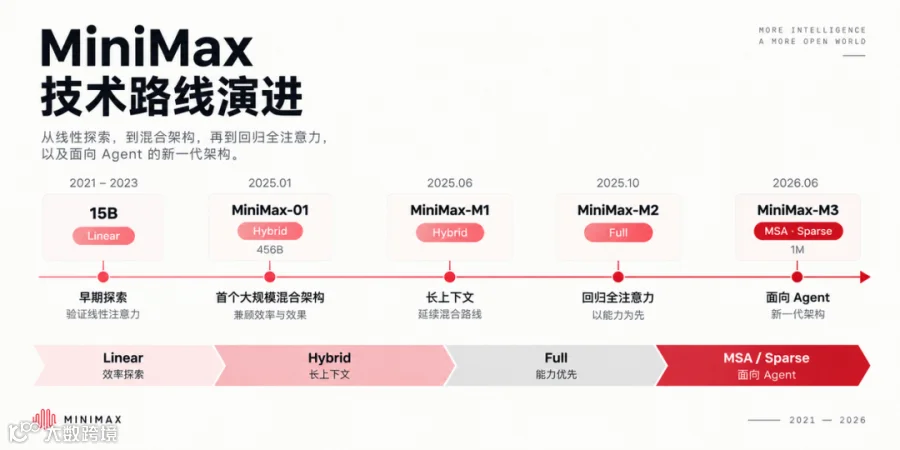
回顾MiniMax的架构演进,完整经历了这一轮反复:从押注线性注意力,到混合注意力,回归全局注意力,再转向稀疏注意力。每次转变都对应着模型 Scale 后暴露的新问题。
2023年底,主导MiniMax-01架构设计的钟怡然在寻找能将 Linear Attention 真正 Scale Up 的公司。他判断 Linear Attention 的核心问题仅剩一个:放大到几百B参数后是否依然成立?
预训练几百B大模型需要庞大的资源倾斜。与闫俊杰交流后,MiniMax决定接下这条未经大规模验证的路线。公司调动超80%的研发资源,去验证仅有五成把握的技术。
MiniMax创始人闫俊杰,图源网络
早期15B纯 Linear 模型效果接近 Transformer,但进一步放大后问题凸显:Linear Attention 将历史压缩进紧凑状态,导致在长文本精确检索时出现信息丢失。
最终,MiniMax-01 采用了 7:1 的混合注意力架构:7层 Lightning Attention 搭配1层传统 SoftMax Attention。大部分计算交由低成本 Linear 处理,周期性通过全局 Attention 读取完整上下文。
历经约3700次预训练实验,2025年1月发布的 MiniMax-01 正式保留该架构,上下文推至400万 token。这证明了在较长周期内,混合架构仍需保留少量全局 Attention 以兜底能力损失。

二、模型Scale引发混合注意力能力损失

模型继续Scale后,第二轮危机显现:复杂的多跳推理。当模型需要串联多个中间步骤进行推导时,混合注意力出现了比 Full Attention 更明显的能力衰退。
混合注意力的真正风险在于:未知能力损失无法被提前穷尽。现有的 Benchmark 难以预警未来更大模型、更复杂任务中的新能力缺口。
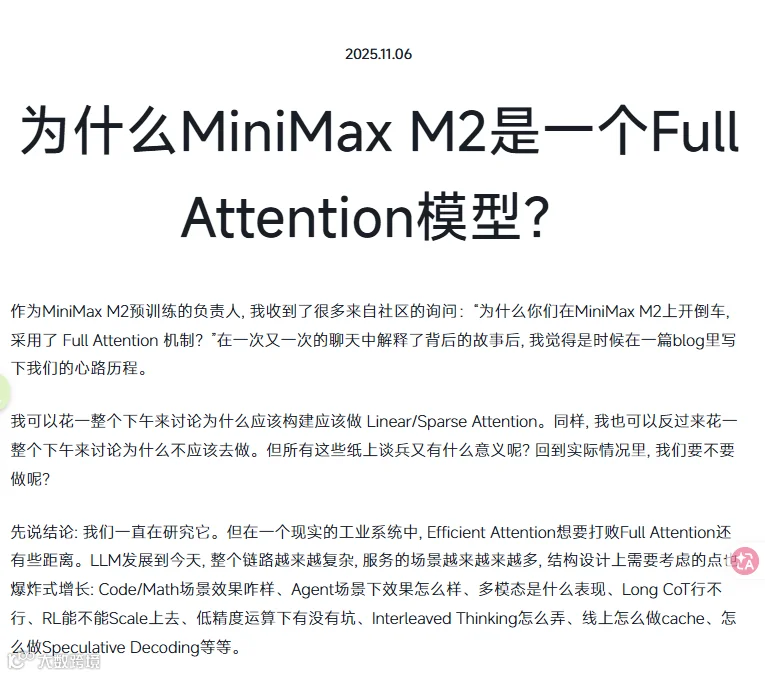
MiniMax官网技术博客截图
因此,M2 模型重新采用 Full Attention。相比可能暴露未知缺陷的高效架构,Full Attention 虽成本更高,但能力边界和工程表现更具确定性。

三、Agent时代放大全局注意力成本

2026年6月,M3 再次放弃 Full Attention,转向自研的 MiniMax Sparse Attention (MSA)。驱动力来自任务形态的演变:Agent 时代的长上下文,不再是单次读取的静态文档,而是随任务执行不断累积的动态工作历史。
历史越长,每轮处理的信息越多,Full Attention 的计算与 KV Cache 成本呈指数级增长。
M3 将“Context Scaling”列为核心,采用 MSA 从长上下文中筛选必要信息。官方数据显示,在100万 token 上下文下,M3 单 token 计算量降至上一代的 1/20。当“确定性保险”的价格被 Agent 放大,团队再次转向稀疏注意力。

四、线性与稀疏注意力融合于同一架构

MiniMax 转向 Sparse 的同时,行业内的混合架构也开始松动。2月发布的 MiniCPM-SALA 将 Lightning Attention 与 Sparse Attention 结合;Qwen3.8-Flash-Next 用 Qwen Sparse Attention 替代了原有的全局兜底层。
在 GLM-5.3-Flash 中,45层模型同时搭载了 Kimi 的 KDA 和 DeepSeek 的 KPool-DSA。Linear 擅长低成本维持长历史,Sparse 负责精准查阅具体细节。两者分工明确,自然融入同一架构。
Attention架构正从寻找单一最优解,走向让不同机制承担不同职能。

过去被当作独立路线的 Linear、Sparse 和 Full,正演变为同一架构设计空间内的可组合选项。

五、技术扩散打破公司路线边界

这种技术融合得益于开源社区的推动。杨松琳维护的线性注意力开源社区 FLA,将算法与底层实现全面开放,Kimi 等公司在推进 KDA 时也吸收了该社区的核心力量。
技术通过代码、社区和人才流动跨越了公司边界。拉开差距的核心不再是谁掌握了某项单一技术,而是何时采用、如何组合,以及在能力、成本与工程风险间如何取舍。

六、尾声:从路线押注到约束判断

GLM-5.3-Flash 中同时出现 KDA 和 DSA,印证了单一 Attention 机制已无法定义公司的技术路线。MiniMax 从 Linear 到 Full 再到 Sparse 的演进,本质上是对不同阶段核心约束的持续判断。
Text-01 时代解决成本问题,M2 规避能力风险,M3 应对 Agent 长上下文挑战。技术会扩散与重组,真正难以被复制的,是团队预判下一堵墙出现在哪里的能力。
参考资料:
1. 晚点聊 LateTalk 104:《我给线性注意力找“金主”,字节 say No,MiniMax say Yes》
2. MiniMax:《MiniMax-01 is Now Open-Source: Scaling Lightning Attention for the AI Agent Era》
【声明】内容源于网络
0
0
AI科技评论
聚焦AI前沿研究,关注AI工程落地。
内容 8971
粉丝 0
AI科技评论 聚焦AI前沿研究,关注AI工程落地。
总阅读255.4k
粉丝0
内容9.0k