

热点观察
发布事件:TypeSafe AI 发布首个“系统一模型” Jev
发布方:TypeSafe AI(旧金山,2024 年创立;创始人 Diogo Almeida、Erik Gafni、Sasha Sheng)
官方网址:https://typesafe.ai
【导读】前 OpenAI 研究员 Diogo Almeida 创办的 TypeSafe AI 发布了首个“系统一模型” Jev。该模型不生成任何文本,仅输出类型化的判断与概率。官方自测显示,其速度最快提升 193.6 倍,成本最低节省 444.6 倍。开放内测 36 小时内吸引 14 万开发者注册,获 Vercel、Cloudflare、LangChain 等相继接入。其核心亮点在于将“校准”做成训练目标(RLCD),但“零幻觉”与“新范式”的说法仍需客观审视。
一、砍掉大模型最贵的“表达”部分
9 月 15 日,TypeSafe AI 结束两年隐身,发布首款模型 Jev。内测 36 小时内吸引 14 万名注册开发者,获 DCVC 领投 4000 万美元种子轮,估值约 2 亿美元。
与常规大模型不同,Jev 不生成文本、代码或对话,其核心理念是“要决策,不要文本”(Decisions, not strings)。传统自回归模型通过逐 token 预测生成文本,虽表达自由但成本高、速度慢。而在许多 Agent 场景中(如网页点击判断、工单分发),系统仅需语义理解与决策,无需开放式生成。
Jev 专为此类任务设计,接收状态与预设问题,直接返回类型化判断与概率。其输出原语包括:Choice(预定义选项选择)、Score(打分)、Noul(0到1的概率判断)。例如,处理客服邮件时,可一次性返回部门分配、紧急程度、退款风险及是否需要人工介入等决策。官方宣称其采用新的 parallel sampler,可在一次查询中并行回答多个独立问题。

图1 | 官方博客 workflow 配图,官方发布的 4 个 production workflow 中最简单的一个
官方演示显示,处理同一批结构化判断,Jev 耗时 0.114 秒,而对照的生成式大模型需 8.566 秒。其定价模式也相应调整:输入每百万 token 0.042 美元,输出不按 token 计费。Jev 砍掉的是“表达”而非“理解”,将输出压缩至软件所需的最小形态。与传统分类器相比,Jev 保留了大模型的零样本泛化能力,这是其核心优势。
二、减少每个 token 成本,还是直接减少 token?
Jev 与 Gemini Flash 等“小快灵”模型有本质区别。后者仍是生成式,旨在降低单 token 成本;而 Jev 的逻辑是:若任务仅需选择或概率,则直接不生成 token。
在复杂的 Agent 任务中,约 95% 的调用(如路由、分类、验证)无需动用生成式大模型。由此可构建分层架构:复杂规划交由前沿模型,普通推理交由 Flash 级小模型,高频判断交由 Jev 等决策模型,确定性逻辑由传统代码处理。
社区对此反应不一。有观点认为这只是“重新发现分类模型”,但另一派指出,Jev 是具备 LLM 级语义理解的通用分类器,若能实现低成本与高速度,将意义重大。
三、核心亮点:面向校准的强化学习(RLCD)
相比“快 193 倍”的传播度,TypeSafe 提出的 RLCD(Reinforcement Learning for Calibrated Decisions,面向校准决策的强化学习)更具探讨价值。
不同于 RLHF(优化人类偏好)和 RLVR(提升数学/代码能力),RLCD 旨在解决模型概率输出的可靠性问题,即“校准”(calibration)。若模型对某任务给出 90% 置信度,其实际正确率应接近 90%。校准良好的模型可支撑稳定的分流机制:高置信度直接执行,中等交更强模型复核,低置信度转人工。这在 Agent 投入生产环境时至关重要。若 RLCD 效果得以独立验证,其价值将超越单纯的速度提升。
四、理性看待“零幻觉”、性能倍数与黑箱
1. “零幻觉”的真实含义
官网宣传的 Zero Hallucinations 指的是类型正确率(如限制在“猫、狗、鸟”中选择,不会返回“大象”或无法解析的乱码),即类型错误率为 0%。但这不代表判断正确,若将猫误判为狗且置信度 97%,仍属业务错误。目前仅约束了输出格式,尚无证据表明其消除了判断层面的错误。
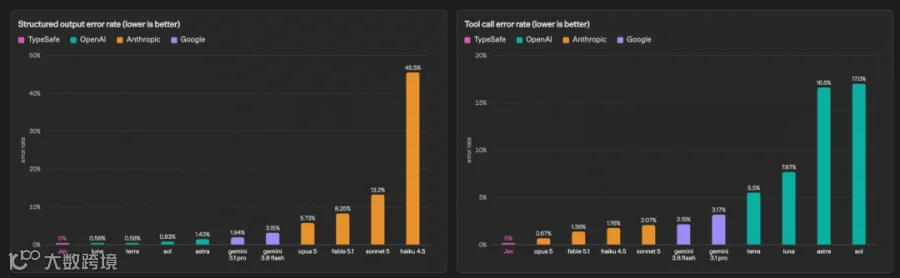
图2 | 官方博客 "Hallucination and Type-safety" 一节配图
2. 性能倍数的测试条件
193.6 倍速度与 444.6 倍成本来源于特定任务的峰值评测。官方均值数据显示,Jev 平均得分约 67.8%,对照的前沿模型为 68%–74%,差距并未如倍数般夸张。此外,测试任务由公司团队设计,部分参考答案由强模型生成,缺乏涵盖准确率、校准、延迟、成本、鲁棒性及扩展性的全面独立评测。
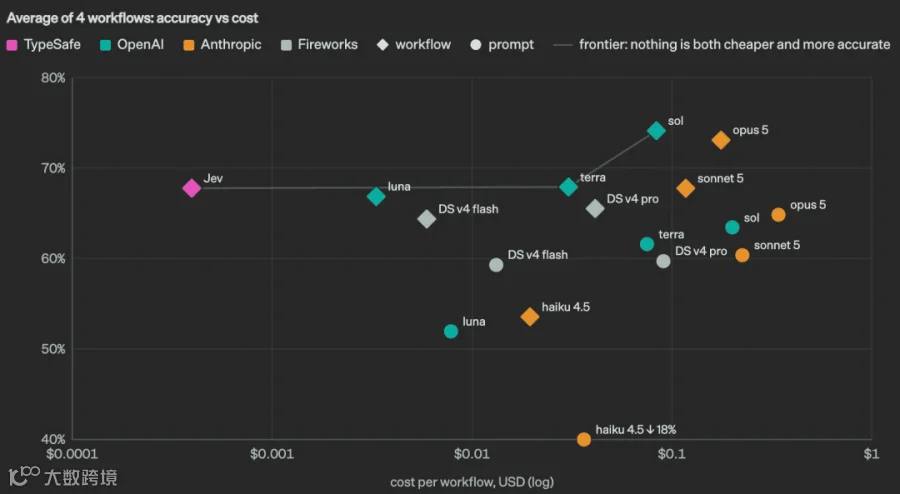
图3 | 官方博客评测图,Jev 与前沿模型在同一批 workflow 上的对比
3. 架构与信息的黑箱
Jev 目前无论文、无参数规模、无架构细节披露,训练数据全为合成数据,RLCD 仅停留在博客层面。社区猜测其底座可能为开源 LLM 改造。在信息可复现前,其“基础架构级范式创新”的定位仍有待检验。
五、发布一周引发的社区生态
Jev 在 Hacker News 发布帖获 1977 分、513 条评论。创始人 Diogo Almeida(InstructGPT 论文作者之一、前 OpenAI 研究员,参与建立 RLHF 训练流程)亲自在社区回应追问。
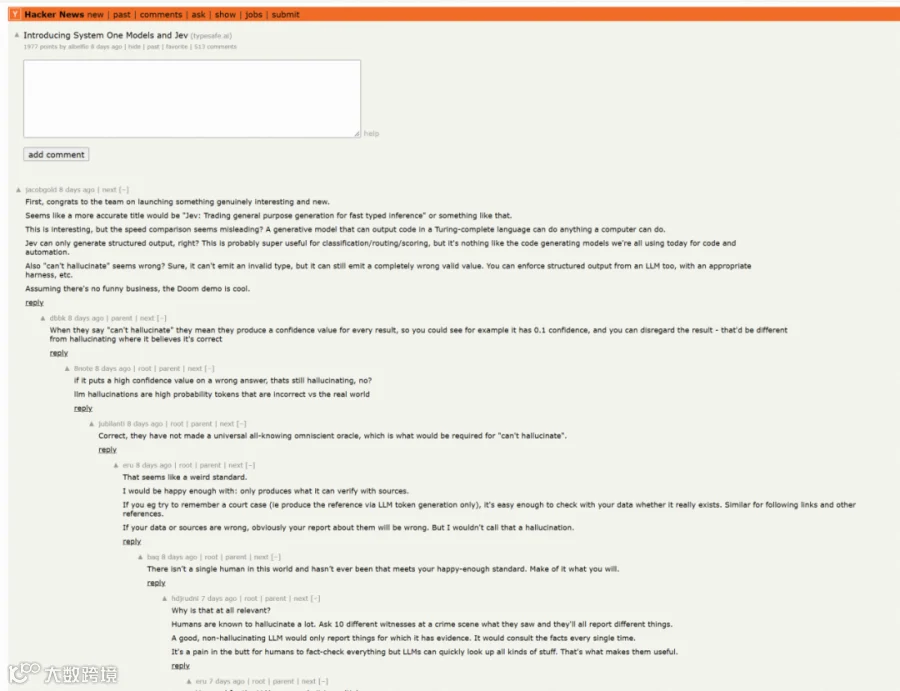
图4 | Hacker News 发布帖截图(1977 分、513 条评论)
社区衍生出丰富的二次创作:25行 Python 复刻最小版 Jev、基于开源模型的决策模型家族 Kev,以及关于生态依赖的讨论等。Jev 命名源自经济学家 William Stanley Jevons(杰文斯悖论),寓意当“智能判断”成本大幅降低,其在软件中的嵌入量将呈爆炸式增长。
六、留给行业的三个思考
Agent 的快思考与慢思考,应拆分为两个模型各司其职,还是由单模型按需切换?
在生产环境中,“校准良好”是否会比“更聪明”更早成为技术分水岭?
产品先于论文发布,是否正成为 AI 创业公司的新常态?