


来源:量子位(QbitAI) | 作者:允中
随着大模型算力需求攀升,GPU采购成本与供给约束持续加剧。
AI推理竞争正从“比拼顶级硬件”转向“极致利用现有算力”。许多开源框架虽能让非主流GPU“跑起来”,但实际压测性能往往远低于官方水平。性能损失的核心,在于模型框架与硬件间存在的性能鸿沟。
这类GPU卡缺乏高速卡间互联,且不在主流开源框架官方验证矩阵中。直接使用社区默认方案,会导致算子回退至低效通用实现、集合通信沿用不适配参数等问题,硬件本身的算力潜力被软件层的适配短板所禁锢。
是石科技自研Meta-Infer推理引擎,破解算力适配难题
是石科技(METASTONE)作为独立第三方全栈算力运营商,不绑定特定大模型厂商,致力于提供涵盖硬件、组网、调度、优化与运营的一站式算力交付服务。凭借国家级计算中心经验,其算力集群SLA达99.95%以上,纳管超20000P算力,运营10多个智算中心及2个国家级超算中心。
针对上述硬件与框架的适配痛点,是石科技自研Meta-Infer高效推理引擎。该引擎面向异构加速芯片,在不改动模型结构与任务语义的前提下,通过纯软件优化充分挖掘GPU推理潜力:
依靠软件优化,成本更低的GPU卡,有机会在部分推理业务指标上,逼近高端GPU的服务能力。
四大核心能力,深度挖掘长尾硬件潜力
Meta-Infer的优化逻辑分为两大关键阶段:
算模协同:释放被硬件差异屏蔽的高性能路径;
通算重构:打通瓶颈,充分榨干硬件资源。
最终沉淀为Meta-Infer的四项核心能力:内核补齐、算子优化与通信重构、并行与容量调优、缓存复用。
1. 内核补齐:解锁原生高性能路径
主流框架对非官方验证硬件常静默降级运行。Meta-Infer通过内核补齐修复适配:对齐元数据与页尺寸,解锁原生算子;替换老旧内核为深度调优实现;扩大通信快路径阈值。

△该图由是石科技提供
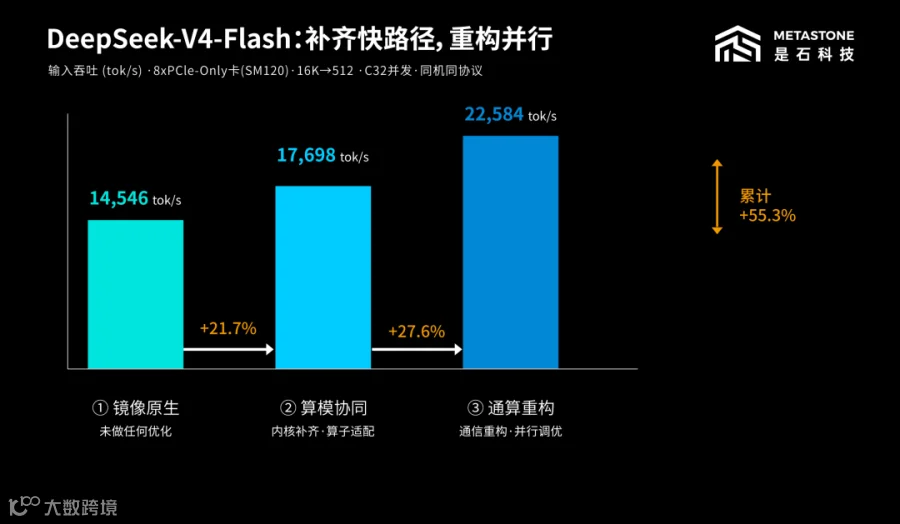
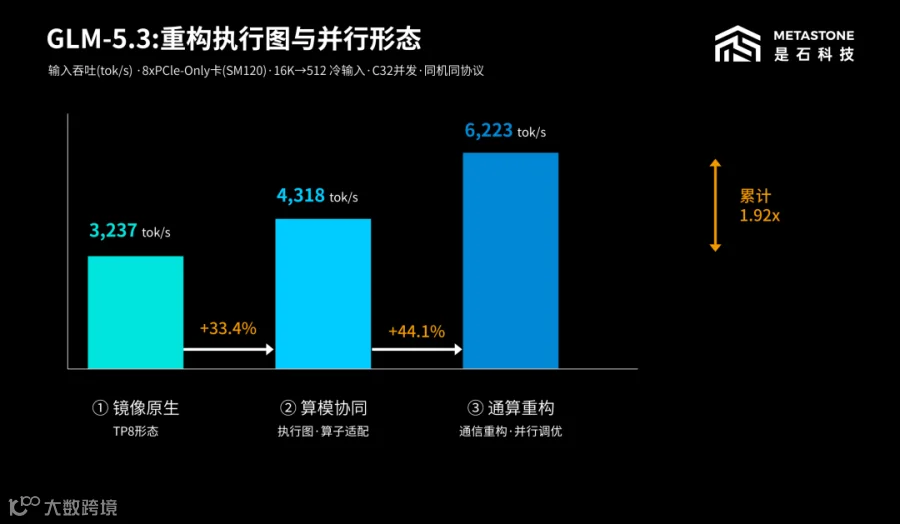
以DeepSeek-V4.1-Flash为例,在8卡PCIe环境部署社区基线版本时,输入吞吐仅1932 tok/s。经算模协同阶段修复后,吞吐直接提升至5850 tok/s。这一阶段并未创造全新算法,而是把硬件与框架本就具备、却被适配问题锁住的性能释放出来。该逻辑在DeepSeek-V4-Flash、GLM5.3等模型上同样实现了20%-33%的吞吐增益。
△该图由是石科技提供
△该图由是石科技提供
2. 算子优化与通信重构:打破计算与通信瓶颈
针对PCIe架构卡间带宽低的问题,引擎对注意力等关键算子进行融合压缩;实现计算与集合通信的时间重叠掩盖;改写通信逻辑适配PCIe带宽,降低等待开销。
3. 并行与容量调优:差异化调度释放资源
放弃全局固化参数,针对Prefill和Decode阶段差异化配置并行策略;动态调整显存占比与KV缓存容量;灵活匹配流水线与张量并行组合,适配各类业务负载。
4. 缓存复用:削减重复计算与显存读写
面向长文本与视频生成场景,提供风险感知的缓存复用机制,动态判断复用与刷新时机,在不降质的前提下削减冗余计算。
以DeepSeek-V4.1-Flash为例,经全套通算重构调优后,输入吞吐从5850 tok/s进一步提升至13274 tok/s,整体实现6.87倍吞吐提升,并支持1M超长上下文。该方法论在多场景下得到验证:
DeepSeek-V4-Flash:输入吞吐提升1.55倍;
GLM5.3:输入吞吐提升1.92倍,P95首Token时延降至46.6秒,上下文支持上限拓至105万Token;
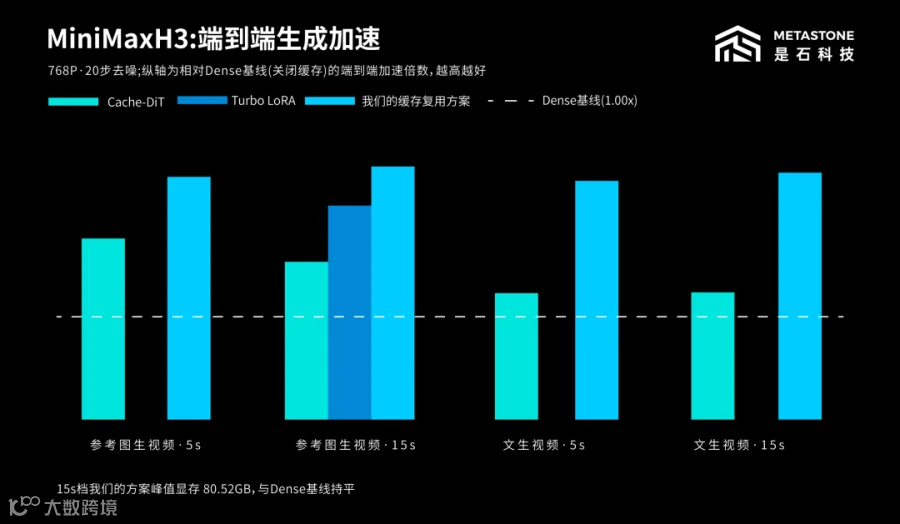
MiniMax H3视频生成模型:依托稀疏注意力与风险感知缓存复用等组合,15秒参考图生视频端到端速度提升2.48倍,峰值显存与基线持平。
△该图由是石科技提供
在视频生成场景中,单机8卡整机配置的文生视频最高吞吐达基线的5.33倍,参考图生视频达4.98倍。
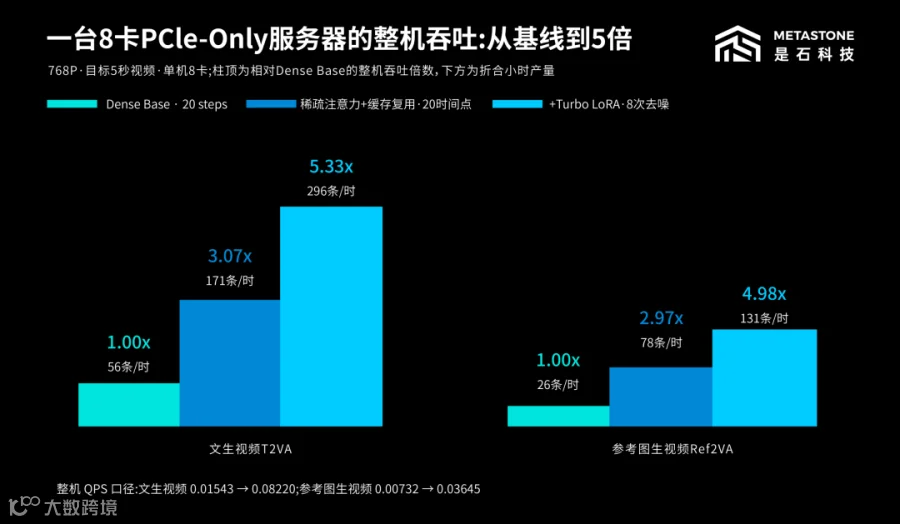
在统一整机口径下,8卡整机的文生视频和参考图生视频吞吐分别约为顶级B300的67%和58%。若按整机吞吐折算,在几乎无损的缓存方案下,约2.6台6000D可对应1台B300的文生视频吞吐;若叠加LoRA方案,该比例进一步缩小至约1.5台。硬件配置未变,性能差距的缩小主要归功于软件栈、缓存策略与模型优化的深度组合。
国产GPU验证:同一套方法论同样适用
Meta-Infer同样在国产GPU上完成验证。针对国产硬件不在官方验证矩阵的问题,引擎通过显式启用NSA稀疏注意力、关闭不适配特性、分阶段配置通信策略等系统适配,显著释放实际推理性能。例如,仅将Shared Expert与Routed Expert改为并行提交,即在35组测试中带来11.26%的吞吐提升,使其更接近规模化生产需求。
长尾硬件新思路:“能跑起来”只是起点
Meta-Infer全程无需改动模型权重与结构,证明了“能跑”与“可规模化生产”之间存在巨大的软件优化空间。
在高端算力成本高企的背景下,Meta-Infer代表了一条新路线:不必盲目追逐顶级硬件,而是通过深度软件体系充分挖掘现有PCIe架构硬件潜力。硬件上限由芯片决定,而实际效能由软件定义。借助深度优化,成本友好的长尾GPU完全有机会在部分指标上向高端硬件看齐。
注:¹ 无损NVFP4量化版本指模型权重以NVFP4部署,保持既有计算定义,未引入额外精度损失。