


科技创新赛道
典型案例:VenusPod-融合AI与超大规模蛋白质数据,赋能生物制造研发范式变革
牵头单位:上海交通大学
项目背景
生物制造研发领域长期存在痛点,如传统蛋白质设计依赖专家经验试错、周期长、成功率低,以及现有 AI 模型受限于数据规模(如 ESM-C 仅 2l 亿条)等。上海交通大学构建了全球最大蛋白质数据集 VenusPod ,打造 AI 蛋白质设计引擎,从“大海捞针”转变为精准设计,激活蛋白质数据要素的潜在价值,推动生物医药与合成生物学产业降本增效。
核心能力
一是汇聚深海与盐湖极端环境高价值数据,保持数据持续更新。一方面,数据集汇聚了全球公共数据库(UniProt、NCBI 等)数据,以及 MEER 计划深海微生物、国内盐湖耐极端环境微生物宏基因组数据,涵盖 l50 亿条蛋白质序列,其中 65 亿条带有温度、pH 值、压强等关键环境标签数据。另一方面,采用“开源清洗+ 自有采集+实验反哺”方式,依托“奋斗者”号及盐湖测序采集特有数据,通过 Venus-Auto 自动化湿实验平台,将验证后的高精度数据实时回流至数据库,实现数据持续更新。
二是以模型为基础,促进实验数据精准预测。基于 Transformer架构预训练 VenusPLM 基础模型,面对不同的下游应用场景进行模型微调,融合干湿实验数据,通过清洗、降重、结构化处理,将海量序列转化为“模板挖酶”和“反应挖酶” 的精准预测能力。
三是广泛应用于生物医药场景 ,实现经济社会双重收益。模型应用于生物医药(抗体稳定性优化)、体外诊断(高灵敏酶改造)、合成生物学(耐高温/酸碱酶开发)等场景。在经济效益上,已服务30 余家企业,帮助多家合作企业缩短研发周期 50%以上,如某体外诊断原料成本降低 52%,单域抗体耐碱性提升 4 倍并实现大规模量产。在社会效益上,突破耐极端环境酶设计瓶颈,助力绿色生物制造与节能减排;构建具有战略意义的国产蛋白质“数据领海”,保障生物数据安全;加速创新药与高灵敏诊断试剂开发,提升公共健康水平。
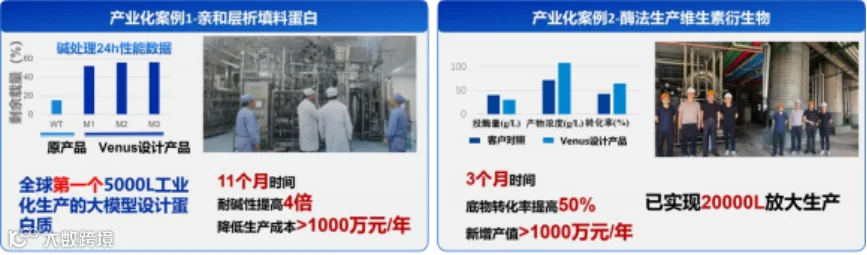
图 1 产业化案例
四是对外提供多层次数据服务 ,创造数据价值。通过“基础库免费+高价值数据订阅+CRO 技术服务”获取收益。提供服务包括数据库订阅及 API调用服务;基于数据的AI 设计 CRO 服务;自研高性能酶产品(如耐碱 VHH抗体)的销售与授权,签约多家制药企业进行技术转化。
转载如有侵权,请联系删除
点击蓝字,阅读原文
往期推荐
大连数产协办 | 普兰店区企业数字化转型与数据资产化专题培训成功举办,助力企业释放数据要素价值
大连数产联合申报项目斩获2026年“数据要素×”大赛辽宁分赛一等奖!
大连数产亮相2026数博会,分享数据基础设施建设经验
点击名片 关注我们