


一、研究背景
在非靶代谢组、天然产物研究中,大量未知化合物无法通过传统谱图库匹配完成鉴定,需要依靠MS/MS 从头结构生成算法直接从质谱推导分子结构。
2025 年提出的 DiffMS 利用图扩散模型开辟了质谱条件分子生成的新思路,但存在两个现实短板:一是图扩散架构难以利用亿级无标注分子做预训练,化学先验学习受限,且推理速度极慢;二是容易产生与质谱碎裂行为矛盾的 “幻觉片段”,缺少定向纠错能力,只能靠增加采样碰运气。
为解决训练规模、推理速度以及分子幻觉三大问题,DiffMS 原团队提出 FRIGID 框架。
二、方法介绍
FRIGID 全称 Fragment Refinement via ICEBERG‑Guided Inference Diffusion,整体由FRIGID‑base 基础扩散语言模型 + ICEBERG 引导推理迭代精炼模块两部分组成。不再直接生成分子图,采用SAFE 片段序列作为中间分子表征,更适合片段级掩码、重编辑操作。
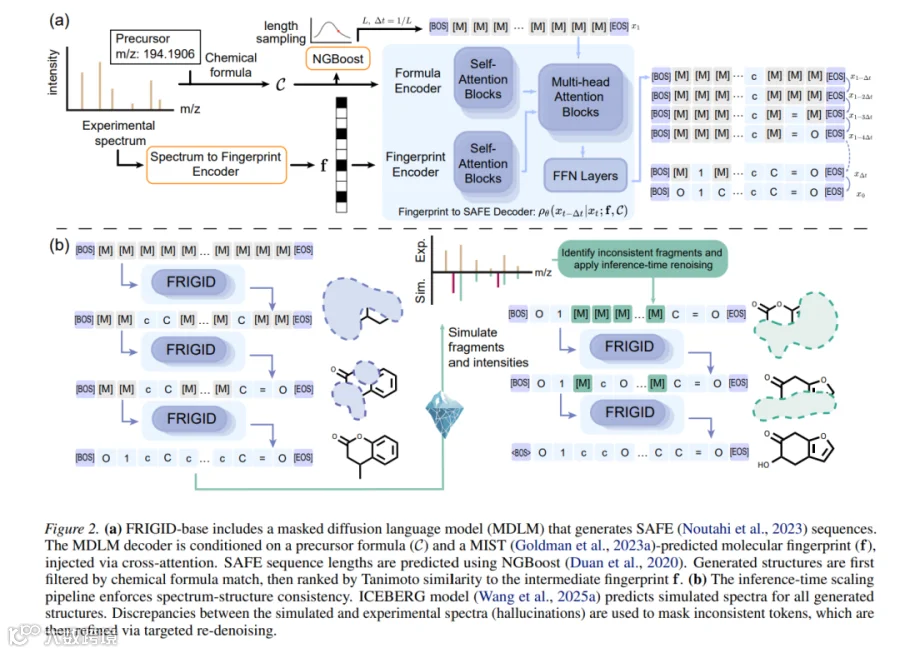
2.1 FRIGID‑base:掩码扩散语言模型 MDLM
管线遵循「实验质谱→分子指纹→SAFE 序列→分子结构」的两阶段范式:
- 构建条件信号:MS/MS 谱输入 MIST 编码器预测 Morgan 分子指纹,结合上游给出的分子式;指纹与分子式编码为条件嵌入,通过交叉注意力输入 Transformer。借助 NGBoost 依据分子式预测 SAFE 合理序列长度,规避无效序列。
- 大规模预训练:基于 BERT 式掩码扩散语言模型 (MDLM),对 SAFE 序列 token 做掩码‑还原学习。该架构支持最高10 亿规模无标注分子库预训练,充分学习通用化学知识;测试集分子全部从预训练数据中剔除,避免数据泄露。
- 条件生成解码:推理时以指纹、分子式作为条件,逐步还原掩码 SAFE token,再转换为可用于评估的 RDKit 分子对象。
2.2 ICEBERG 引导循环一致性精炼(核心创新)
生成结果仍会出现和实测谱冲突的幻觉子结构。FRIGID 没有采用单纯增加采样、延长扩散步数的朴素方案,引入正向碎裂模型 ICEBERG,搭建「生成分子→模拟质谱→定位错误片段→定向掩码重去噪」闭环迭代流程:
-
ICEBERG 作为 “结构转质谱” 正向模型,由候选分子模拟 MS/MS 谱,并且可以将质谱峰溯源到分子内部对应的原子与子片段。 -
比对模拟谱与实测谱,区分匹配峰与幻觉峰,给分子原子打上一致性得分,幻觉片段对应的原子获得负向分数。 -
将原子得分聚合至 SAFE 序列 token 层面,只对出错片段对应的 token 做概率掩码,不会打乱整个分子序列。 -
将部分掩码的序列重新送入 FRIGID‑base 重生成,得到修正后的候选分子;多轮迭代持续扩充候选池。
消融实验证实:性能提升来源于定向片段修正,不是单纯堆算力;同等计算预算下,随机掩码、重复从头生成效果均弱于本方案。该纠错逻辑具备模型无关性,移植到 DiffMS 同样可以涨点,但会带来极高时间成本,实用性很差。
三、实验结果
采用领域两大公开基准数据集 NPLIB1、MassSpecGym(高难度骨架分布外测试集),基线包括 DiffMS、MADGEN、MS‑Novelist、MS‑BART、MolForge 等主流模型,评价指标包含 Top‑k 准确率、MCES、Tanimoto 相似度;全部实验默认给定真实分子式。
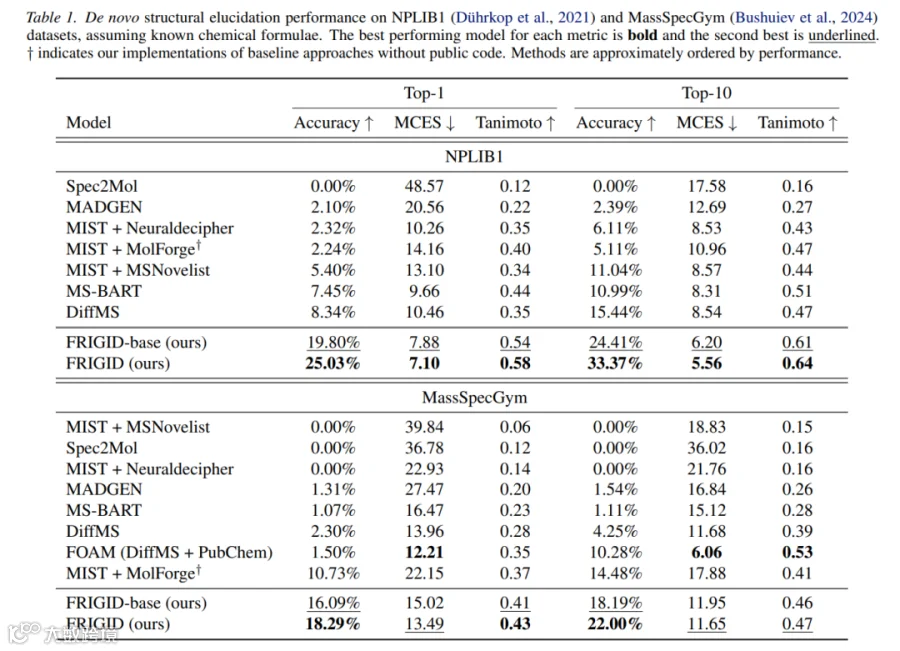
3.1 核心基准性能
- NPLIB1 数据集
DiffMS Top‑1 精确匹配准确率 8.34%;无纠错的 FRIGID‑base 达到 19.80%;完整 FRIGID(开启 ICEBERG 迭代精炼)达到25.03%,Top‑1 准确率约为 DiffMS 的 3 倍;Top‑10 准确率 33.37%,结构相似度全面优于基线。 - MassSpecGym 高难度数据集
DiffMS Top‑1 仅 2.30%;FRIGID‑base 达到 16.09%;完整 FRIGID 实现18.29% Top‑1 准确率,是该基准首个突破 18% 的模型,相对 DiffMS 提升 7 倍。
3.2 现实场景补充验证
-
即使不能完全还原真实分子,FRIGID 大量输出属于 “有意义匹配 (Tanimoto≥0.4)”、“接近匹配 (Tanimoto≥0.675)”,依旧能够给科研人员人工解析提供重要参考。 -
如果替换为 MIST‑CF 预测的 Top‑5 候选分子式而非真值分子式,模型性能明显下降,再次说明分子式准确性是当前体系的核心瓶颈。 -
消融对比证实:“质谱→指纹→分子” 两阶段架构,效果优于端到端直接从质谱生成分子。
四、总结
FRIGID 不是 DiffMS 的简单调参升级,属于质谱从头解析的范式迁移:放弃开销巨大的图扩散,采用 SAFE 序列扩散语言模型,释放亿级分子预训练潜力;再结合 ICEBERG 正向碎裂模型实现片段定向纠错,有效缓解分子幻觉。
核心亮点:
- 性能刷新 SOTA:两大基准数据集大幅超越已有方法;NPLIB1 Top‑1 为 DiffMS 的 3 倍,MassSpecGym 首次突破 18%;
- 推理效率大幅提升:序列扩散带来 20 倍速度提升,让多轮迭代纠错具备落地可行性;
- 新颖纠错范式:不只是过滤候选,而是定位幻觉片段、局部重生成,纠错思路可迁移到其他分子生成模型。
现存局限:
- 强依赖准确的分子式:真实生物样本中分子式本身很难推断;分子式出错,后续生成全部失效。
-
实验基于质量较好的公开基准数据集;面对真实样本低丰度、基质干扰、高噪声质谱,鲁棒性还需要更多实测验证。 -
高准确率模式下迭代精炼会带来不小 GPU 算力开销。
FRIGID 证明质谱驱动分子生成不必直接生成分子图;结合片段序列表示与正向碎裂模拟是极具潜力的方向。后续重要方向:降低对真实分子式的依赖、增强噪声谱鲁棒性,推动生成式 AI 真正走进大规模非靶代谢组分析流程。
论文链接:https://arxiv.org/abs/2604.16648