

导读在构建智能体(Agent)工作流、客服路由和安全护栏时,用自回归大模型处理确定性的分类与二元判断,往往面临数百毫秒延迟、Token 浪费以及输出伪置信度的困境。作为 Jev 的开源复刻与升级,仅含 4.21 亿参数的 Laya 凭借 ModernBERT 双向编码器和基于严格适当评分规则的 RLCD 强化学习训练,在本地 GPU 上实现了 33ms 的极速决策与高精度置信度校准。本文深度拆解 Laya 的白盒架构与数学校准机制,提供 4 步保姆级本地部署代码,并结合实测数据给出 1.25GB 极限显存优化方案及 4 项中文落地避坑经验。
本文 3596 字,阅读约 9 分钟|为什么用生成式大模型做反射判断是一场工程灾难? → 白盒拆解:421M 参数的 Laya 是如何工作的? → RLCD 强化学习:置信度校准背后的数学逻辑 → 四步保姆级实操:本地极速部署与运行 → 显存压榨实测:从 4.39GB 到 1.25GB 的工程调优 → 中文业务落地:4 项关键避坑指南
为什么用生成式大模型做反射判断是一场工程灾难?
在构建现代 AI 智能体工作流或客服系统时,我们经常会遇到大量高频、确定性的反射式判断需求:
用户发来一封邮件,应该路由到售后、财务还是技术支持?
输入的 Prompt 是否包含越狱或注入攻击倾向?
这条工单的问题紧急程度在 0 到 3 级中属于哪一级?
当前操作步骤是否需要立刻触发人工接管?
在过去的工程实现中,最常见的做法是在智能体工作流中“一把梭”——不管是长文本生成还是一个简单的分类路由,所有节点通通接入 8B 甚至 70B 的开源大模型,或者直接调用 GPT-4o 级别的商业 API。
很多开发者会问:这种简单的离散分类任务,难道不能换用 0.5B、1.5B 这种超轻量级的小生成模型(如 Qwen-0.5B、Llama-1B)来做吗?
答案是在实际生产中非常难用。由于自回归生成模型的本质是通过采样预测下一个 Token,0.5B 级别的超小生成模型在 Zero-shot / Few-shot 场景下的指令遵循(Instruction Following)能力极其脆弱:它们不仅经常夹带“好的,为您分类如下”等废话前缀,还极易返回括号残缺、键名缺失的非法 JSON,迫使工程师编写复杂的正则清洗与重试逻辑。开发者过去之所以咬牙上 8B/70B 或商业 API,很大程度上只是为了“买”它们听得懂指令、能稳定吐出合规格式的能力。
然而,这种妥协却带来了严重的工程代价与两难困境:
首先是延迟与算力开销的巨大浪费。自回归解码器在推理时必须逐 Token 串行生成。哪怕我们只需要一个简单的选项标签或布尔值,模型也要走完完整的采样流程,单次网络与推理耗时通常在 300 毫秒到 2 秒之间。当一条流水线串联了意图识别、路由、敏感词、紧急度等多个判断节点时,整体响应会变得极为迟缓,同时还会消耗大量昂贵的 Token 费用。拿数十层 Decoder 去生成一个单标签,无异于开着 50 吨重型卡车去送一封便签。
其次是单向架构的信息瓶颈与伪置信度。生成式 LLM 采用单向因果掩码(Causal Masking),在阅读输入文本时根本无法预先关注后面的待选选项。更致命的是,生成式模型随文本吐出的 "confidence: 0.95" 只是下一个 Token 的字面预测概率,在交叉熵驱动下天然存在“过度自信(Overconfidence)”的数学缺陷。工程代码根本不敢轻易依据这一伪置信度执行自动化放行,极易出现“模型极其自信地给出错误分类”的安全隐患。
人脑在思考时存在 System 1(快速直觉反射)与 System 2(深度逻辑推理)的分工。正如 Andrej Karpathy 所指出的,业界不仅需要越来越长链条的慢思考,在帕累托最优曲线上同样存在被长期低估的需求:无需复杂展开、单步极速、输出经过严格数学校准的概率判断。
由 Convai Innovations 开源的 Laya 正是解决这一困境的破局者。它采用 Apache-2.0 协议完全公开模型权重,参数量仅为 421M(约 0.42B),专为分类与打分等 System 1 决策设计,在本地 GPU 上的前向延迟可压缩至 33~38 毫秒。
白盒拆解:421M 参数的 Laya 是如何工作的?
Laya 完全摒弃了自回归文本生成路线,转向端到端的双向判别式架构。它接收一个输入状态(State,如原始文本或 JSON 数据)以及一组带类型的问题(Questions),通过单次前向传播直接输出概率分布与经过校准的置信度。
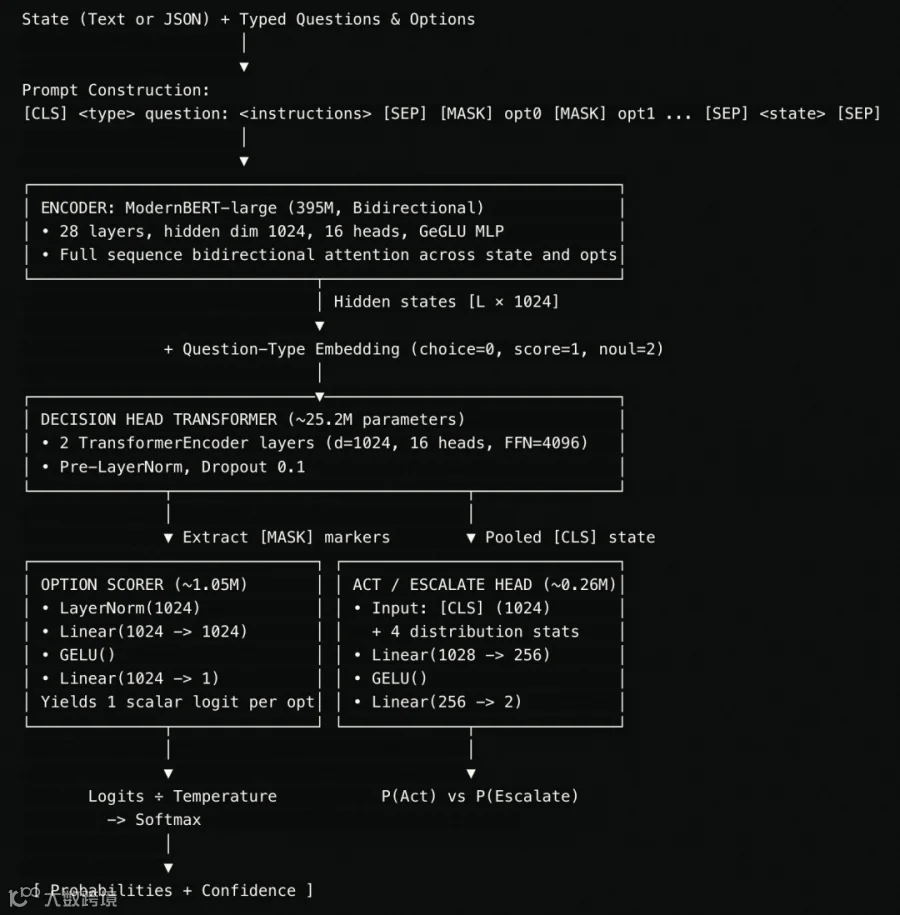 图片说明:Laya 421M 架构中的 ModernBERT 主干与选项抽取机制 图片来源:Convai Innovations
整个模型由三个核心组件紧密结合而成:
1. ModernBERT-large 双向编码器主干
Laya 使用包含 3.95 亿参数的 ModernBERT-large 作为基础编码器(28 层,隐藏维度 1024,16 个注意力头,GeGLU 激活函数)。得益于双向注意力和 RoPE 旋转位置嵌入,它原生支持 8192 个 Token 的上下文窗口。输入中的每个 Token 都能够同时关注状态文本与候选选项的所有信息,彻底摆脱了自回归模型因单向因果掩码而产生的信息瓶颈。
2. [MASK] 选项提取机制与单次并行前向
为了支持动态、任意数量的候选选项,Laya 在构建输入序列时引入了 [MASK] 标记机制。对于每个问题,序列会将问题描述与各个候选选项拼接,并在每个选项前放置一个 [MASK] Token。
数据经过 ModernBERT 编码以及两层决策头 Transformer 后,模型通过 torch.gather 精确抽取所有 [MASK] 处的隐藏状态。选项评分器(Option Scorer MLP)将每个 1024 维的标记向量投影为一个标量 Logit,最后对该问题下的所有选项执行带温度参数的 Softmax 计算,直接得到归一化的概率分布。如果一条输入同时关联 5 个不同的评估问题,模型会将它们打包成一个批次,在 GPU 上仅需一次前向传播(约 35ms)即可同时算出所有问题的答案。
3. 行动与升级(Act / Escalate)决策头
在自动化流水线中,确定“何时可以自动放行、何时必须交给人工”至关重要。Laya 额外设计了一个动作决策头:它将池化后的 [CLS] 向量与 4 个概率分布特征(最高概率、前两名分值差、归一化熵、选项预算比)拼接成一个 1028 维特征向量,输入两层 MLP 输出 [P(act), P(escalate)],为自动化流水线提供原生的门控依据。
RLCD 强化学习:置信度校准背后的数学逻辑
为什么很多传统分类器在预测概率时总表现得“过度自信”?
在传统的交叉熵损失函数下,只有当获胜类别的 Logit 趋近于正无穷大时损失才能降为零,这会天然驱使模型极度自信。如果采用“预测正确给 +1、错误给 0”的朴素强化学习,策略梯度同样会把最高概率推向 1.0,从而破坏概率的真实校准。
为了让模型输出诚实、可信的真实概率,Laya 采用了 RLCD(面向校准决策的强化学习)训练框架,其核心是将决策理论中的严格适当评分规则(Strictly Proper Scoring Rules)作为强化学习奖励函数。
数学上,当且仅当模型预测的概率分布完全等于客观真实分布时,严格适当评分规则的期望奖励才能达到全局最大值。Laya 在无监督交叉熵参与的情况下,完全依靠纯策略梯度进行训练,其复合奖励综合了三类评分:
1. 对数评分(Logarithmic Score):针对分类概率施加严格惩罚,若模型给真实类别的概率极低,将获得极大的负向奖励(设置下限截断保持数值稳定)。
2.
球面评分(Spherical Score):提供 [0, 1] 范围内的有界平滑奖励,鼓励概率质量向正确类别集中,同时防止极端梯度震荡。
3. 排序概率评分(Ranked Probability Score, RPS):专门用于有序评分任务(如 0 到 3 级紧急度)。它衡量预测累积分布与真实累积分布之间的平方距离,迫使模型理解量表数值之间的距离关系(猜成 2 级远比猜成 0 级合理)。
在置信度输出上,Laya 使用归一化香农熵(Normalized Shannon Entropy)进行计算:
$$\text{confidence} = 1.0 - \frac{H(p)}{\log(K)}$$
其中 $K$ 为选项数量。当所有选项概率均为 $1/K$ 时,熵达到最大值 $\log(K)$,置信度精准归零;当某一选项概率达到 1.0 时,置信度达到 1.00。开发者可以直接在业务代码中使用这一置信度设定拦截阈值。
四步保姆级实操:本地极速部署与运行
Laya 已经发布至 PyPI 和开源社区,支持 Linux 与 macOS(x86_64 及 Apple Silicon),推荐在 Python 3.10+ 环境下运行。下面是完整的上手部署流程。
第一步:环境配置与依赖安装
建议创建独立的虚拟环境,并安装核心库。在国内服务器从 Hugging Face 或 ModelScope 拉取权重时,可配置镜像加速:
第二步:理解三套预训练权重分工
Laya 官方目前提供了三个针对不同分工的预训练检查点:
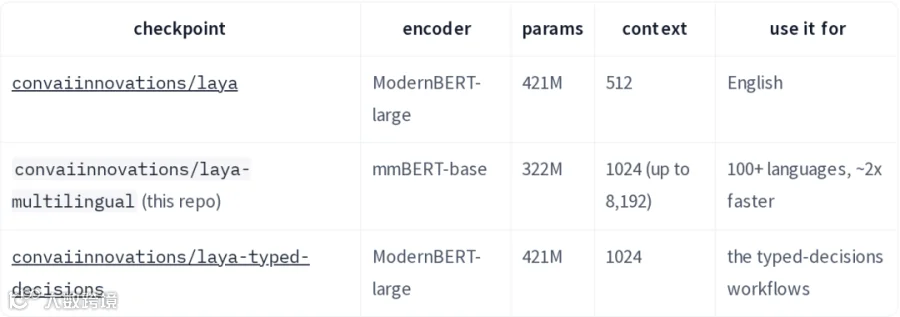 图片说明:Laya 官方在 Hugging Face 发布的三个预训练权重参数与上下文对照表 图片来源:Hugging Face / Convai Innovations
convaiinnovations/laya:英文主模型,基于 ModernBERT-large 构建,适合纯英文业务场景。
convaiinnovations/laya-multilingual:多语言分支,底座替换为 mmBERT-base,覆盖包含中文在内的 100 多种语言。
convaiinnovations/laya-typed-decisions:面向工单分诊、客服、发票和安全事件微调的专用场景权重。
在日常使用中,官方提供的 Router 接口会自动分析输入文本的语种分布并完成调度。当输入中文占主导时,会自动分流至 multilingual 分支。
第三步:编写最小运行脚本
新建 test_laya.py,编写包含输入状态、问题定义与前向推理的代码:
在终端运行该脚本,首次执行会自动下载权重并缓存到本地:
第四步:解析真实返回结构与门控接入
推理返回的结果是一个纯净的 Python 字典,无需进行复杂的字符串正则匹配或 JSON 容错处理。典型返回结构如下:
在工程落地中,开发者重点关注三个字段:
1.
choice:最高胜出标签(如 billing),直接对接下游业务函数。
2.
confidence:基于熵校准的综合置信度。可直接编写自动化门控逻辑:置信度高于阈值则全自动流转,过低则推入人工坐席复核。
3.
routing.model:指示本次实际执行的底层权重分支。
显存压榨实测:从 4.39GB 到 1.25GB 的工程调优
在实际生产部署中,显存占用与调用模式密切相关。在 GB10 算力卡上的基准实测展示了不同调用方式的性能与显存表现:
 图片说明:社区 XiaokeAILabs 在 aarch64 架构 GB10 算力卡上的三种调用模式实测对比 图片来源:Datawhale / XiaokeAILabs 实验日志
1. Router 自动分流模式(开销 4.39 GB)
Router 实例为了能够随时在多语种之间切换,会预加载所有分支,实测常驻显存约为 4.39 GB。该模式的好处在于能够自适应处理混合语种输入,且语种判定本身仅带来约 0.2 毫秒的极低延迟。
2. Agent 单分支锁定模式(极限压榨至 1.25 GB)
如果您的业务主要是中文工单分流或纯国内业务,完全可以绕过 Router,直接通过 Agent 类锁定加载 multilingual 单个子分支:
实测显示,锁定单分支后,显存占用直接从 4.39 GB 骤降至 1.25 GB,而 P50 延迟依然保持在 8.31 毫秒 左右。这意味着即使在配置较低的边缘端卡或消费级 GPU 上,也能轻松常驻运行。
中文业务落地:4 项关键避坑指南
结合中英双语测试集与真实工单样本的实测数据,在将 Laya 接入中文生产系统时,建议遵循以下 4 项实践经验:
1. 中文置信度容易偏高,需将自动放行阈值提至 0.95+
在客服场景的 20 组双语对照中,多语言分支的中文分类准确率达到了 95%,完全具备实战能力。但实测发现中文样本的平均置信度(0.866)显著高于英文样本(0.506),极少数分类错误的边缘样本也可能获得 0.90 以上的置信打分。因此,在中文自动化门禁设计中,建议将全自动放行阈值从默认的 0.85 提高至 0.95 以上,低于该阈值的请求统一转人工或由大模型兜底。
2. 是非题建议转换为双选项单选题
当前版本的 boolean(是非题)题型在处理中文复杂语义时,概率分布有时会出现向中间压缩的现象,导致边界判断不够果断。在实际工程中,建议将是非判断明确改写为包含正反两个语义描述的单选题(choice),判定稳健性会明显提升。
3. 生产服务接入前必须进行冷启动预热
由于底层 CUDA 上下文的初次初始化开销,模型载入显存后的第一条前向请求耗时可能长达 1.9 秒左右。在服务正式挂载流量前,务必先发送一条测试样本空跑预热,随后即可稳定进入 8~30 毫秒的极速响应区间。
4. 建立 System 1 与 System 2 协同的“双脑架构”
在复杂的智能体流水线中,Laya 绝不是要完全替代通用大模型,而是充当“前置护栏与快路由器”:
System 1(Laya):承担高频意图识别、敏感词过滤、工具分流和置信度门禁,以毫秒级响应过滤 80% 以上的标准请求;
System 2(Claude / GPT / Qwen):仅在 Laya 给出低置信度(< 0.95)或遇到开放式长文本创作需求时介入处理。
这种架构不仅能将流水线的整体 P95 响应延迟大幅降低,更能帮助企业削减 90% 以上的 API 调用成本,真正让大模型在最适合它的深度推理场景中发挥价值。
参考资料
Laya 官方代码仓库: https://github.com/NandhaKishorM/laya
Laya ModelScope 社区主页: https://modelscope.cn/models/convaiinnovations/laya
测试与验证实验仓库: https://github.com/li-xiu-qi/XiaokeAILabs/tree/main/experiments/test_jev_open_source/laya
ModernBERT 模型论文: https://arxiv.org/abs/2412.13663
— THE END —
文章仅做学术分享,如有侵权请联系删除,非常感谢!