

2026年AI赛道持续爆火,计算机视觉(CV)作为AI落地最成熟、实操性最强的核心分支,早已告别传统繁琐的代码训练、海量数据集堆砌模式。
现在的AI视觉核心逻辑:依托开源大模型、轻量化微调、零代码/少代码部署,普通人零基础也能快速做出可落地的实战项目。
很多新手学CV踩坑无数:死啃CNN理论、背诵算法公式、盲目训练模型,最后完全无法落地。今天这篇文章,摒弃空洞行业分析,主打AI实操干货,手把手带大家搞懂:2026年AI视觉的轻量化实操逻辑、3个零基础可上手的实战项目、快速落地部署流程,普通人直接照做就能出成果。
01 核心认知:2026年AI视觉,实操逻辑彻底变了
过去的传统计算机视觉,重理论、重底层、重算力:需要手动搭建网络结构、标注数万条数据、高额算力支撑训练,门槛极高,普通人很难入局。
而AI大模型赋能后的全新CV实操体系,核心关键词是:轻量化、预训练、微调复用、低门槛落地,这也是今年AI视觉出圈的核心原因。
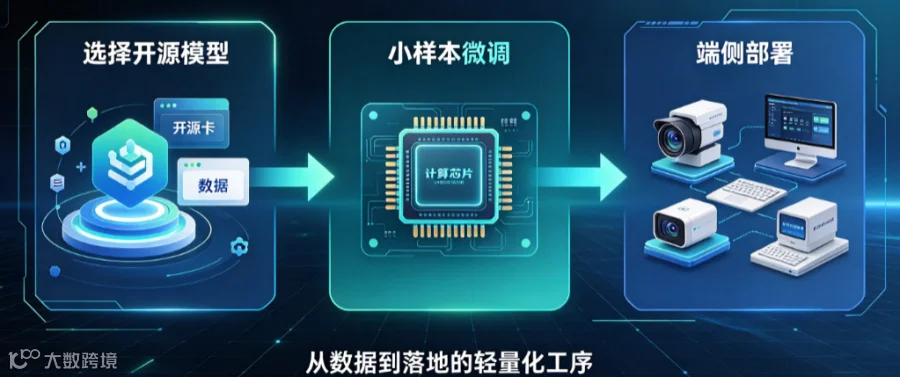
当下主流AI视觉实操范式,全程避开复杂底层研发,核心三步即可完成项目落地:
1. 选开源通用大模型底座:直接调用业界成熟预训练视觉大模型(SAM、CLIP、YOLO-World、多模态防伪大模型等),无需从零训练
2. 小样本微调适配场景:只用几十/几百条自定义数据,微调模型适配专属场景,替代传统数万条数据训练
3. 轻量化部署上线:通过量化压缩、端侧部署,适配电脑、摄像头、移动端设备,快速实现功能落地
简单说:现在学AI视觉,不用造轮子,只用改轮子、用轮子,这是普通人最快出实操成果的路径。
02 必学AI核心技术:新手实操必备3大能力
2026年企业招聘、个人接单、项目落地,不再要求精通卷积神经网络底层原理,只需要掌握AI大模型CV实操核心能力,以下三项是刚需,零基础可快速掌握。
1. 多模态视觉指令微调(核心爆款能力)
这是今年AI视觉最大的变革,彻底告别固定任务模式。传统CV模型只能做单一识别、分割任务,而多模态大模型支持自然语言指令操控视觉任务。
实操演示:无需改写代码,直接输入文字指令,模型自动完成对应任务
✅ 输入指令:识别图片中所有破损零件并统计数量
✅ 输入指令:标记监控画面中违规聚集人员并实时预警
✅ 输入指令:筛选医疗影像中的微小病灶区域
依托ViT架构与提示学习技术,模型可自主理解指令、适配场景,这也是目前工业、安防、医疗场景的主流AI实操方案。
2. 轻量化模型微调(落地核心技能)
很多新手疑惑:开源大模型通用效果好,但适配自己的场景准确率低怎么办?答案就是小样本微调。
2026年主流实操方案:无需高端GPU,普通家用电脑即可微调。仅需收集50-200张场景图片,标注关键信息,通过开源微调脚本,1-2小时即可完成模型优化,场景准确率可提升95%以上。
相比传统全量训练,微调成本降低90%,效率提升数倍,是个人实操、中小企业落地的最优解。
3. 端侧快速部署(变现必备能力)
做得出模型,部署不了=白忙活。当下AI视觉实操的最后一步,就是轻量化部署。通过模型量化、剪枝技术,将大模型压缩为轻量版本,可直接部署在本地电脑、监控设备、移动端,无需依赖云端,运行速度更快、成本更低。
03 零基础可落地:3个2026热门AI视觉实操项目
不讲虚理论,直接分享3个新手零门槛、可复刻、可变现的AI计算机视觉实操项目,跟着步骤就能做,适合练手、作品集搭建、副业接单。
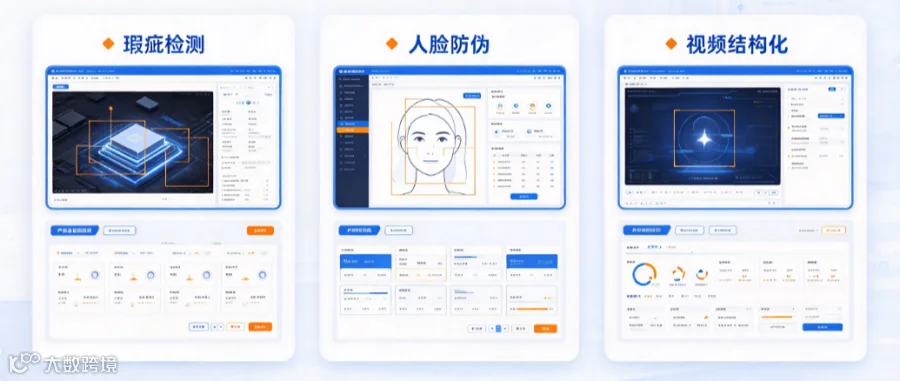
项目一:AI智能图像瑕疵检测(工业刚需)
项目定位:替代人工质检,适配五金、电子、纺织品等产品外观瑕疵检测,企业刚需项目,接单需求极大。
实操极简流程:
1. 数据集准备:采集100张左右产品正常/瑕疵图片(网络素材+实拍均可)
2. 模型选择:调用YOLO-World开源视觉大模型(通用检测能力极强)
3. 小样本微调:用标注工具简单标注瑕疵位置,一键微调模型
4. 部署落地:本地部署后,上传图片/接入摄像头,自动识别划痕、破损、变形等瑕疵,准确率可达99%以上
项目优势:数据量需求小、实操简单、商业落地性极强,是新手入门AI工业视觉的首选。
项目二:AI人脸伪造检测(热门安全赛道)
项目定位:针对AI换脸、人脸合成诈骗场景,适配金融开户、线上核验、赛事安防等场景,是2026年AI安全热门实操方向,成熟方案准确率超99.07%。
实操极简流程:
1. 数据集调用:直接使用开源多模态人脸防伪数据集,无需自己采集
2. 模型复用:加载预训练人脸防伪大模型,支持暗光、模糊等复杂场景识别
3. 简单适配:微调适配手机摄像头、电脑端画面场景
4. 功能实现:实时检测画面是否为AI合成人脸、输出防伪结果,可直接对接各类核验系统
项目优势:前沿热门、开源资源丰富、无需复杂训练,适合做个人AI实战作品集。
项目三:AI视频智能结构化分析(通用百搭项目)
项目定位:对监控、日常视频进行AI结构化解析,自动识别人员、车辆、行为、异常事件,适配智慧安防、校园监控、门店管理等场景。
实操极简流程:
1. 模型选择:通用多模态视频理解大模型
2. 指令配置:设置自定义识别指令(人员聚集、越界、长时间逗留等)
3. 视频接入:上传本地视频或实时接入摄像头画面
4. 智能分析:AI自动完成画面解析、事件统计、异常预警,生成结构化数据报表
04 新手避坑:2026 AI视觉正确学习&落地路线
很多人学AI视觉本末倒置,花费大量时间啃晦涩公式、学底层网络,最终无法落地。针对2026年的AI行业现状,给大家一条零基础高效实操路线:
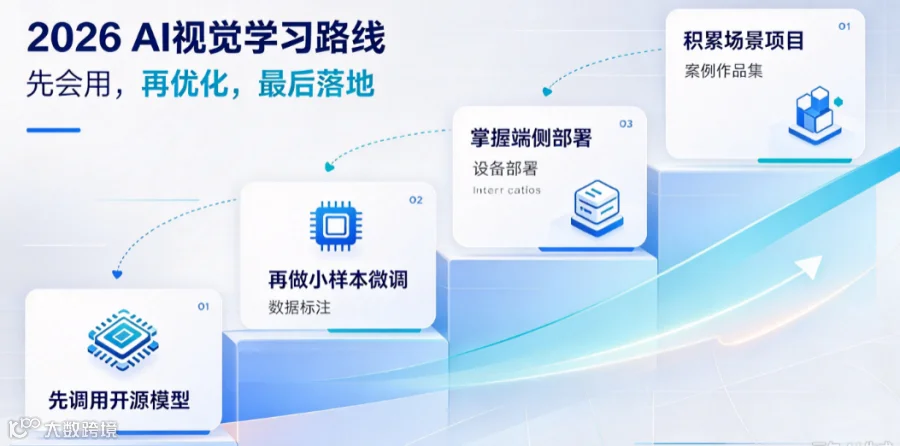
1. 先会用,再会懂:优先掌握开源大模型调用、微调、部署实操,快速做出项目建立信心
2. 聚焦轻量化落地:放弃复杂全量训练,深耕小样本微调、端侧部署核心技能
3. 主打场景适配:不用追求全能,深耕工业检测、智能安防、AI防伪任一细分场景,即可实现变现、就业
未来AI视觉的核心竞争力,从来不是懂多少理论,而是能落地多少AI实操项目。行业极度稀缺“会用大模型解决实际问题”的实操型人才,而非只会背书的理论型人才。
写在最后
2026年,AI计算机视觉已经彻底平民化、轻量化、实操化。门槛大幅降低、落地场景爆发、变现路径清晰,是普通人入局AI赛道的最佳切入点。
不用再畏惧算法复杂、算力不足、零基础入门难,依托开源大模型,人人都能做出专业的AI视觉实战项目。
后续【AI 与计算机视觉】将持续输出零基础AI实操教程、开源模型部署代码、完整项目源码、微调落地案例,全程干货无废话,带你从0到1掌握AI视觉实战能力,轻松实现技能提升与副业变现。
想要获取本文3个实操项目的开源模型链接、完整微调脚本、部署教程,可以持续关注本号,后续逐一更新✨