9 月 24 日,在 2026 云栖大会期间,有云栖学院主办的举行的「搞点事情」产品发布活动中,JoinAI 卓印智能创始人兼 CEO 俞开文现场发布并展示了面向 Physical AI 的空间生成平台及相关能力。
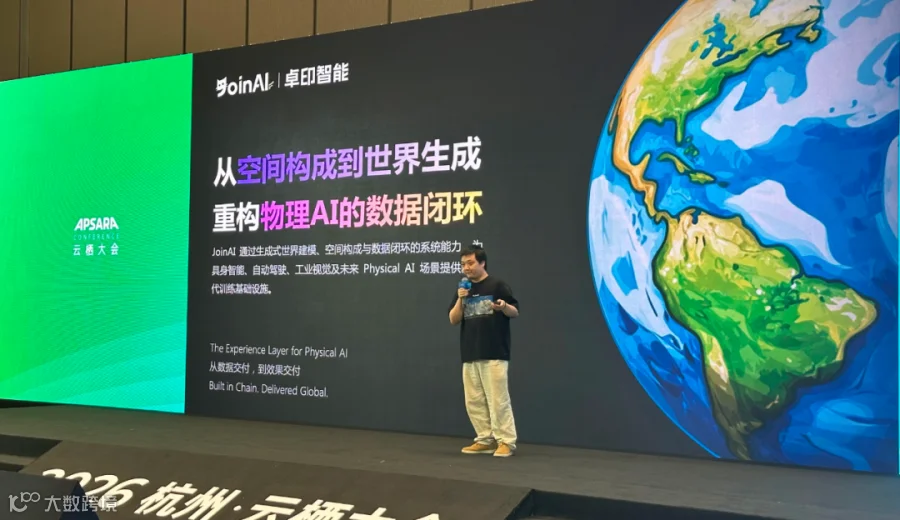
从一句自然语言指令开始,一个完整的三维空间可以被生成;空间中的对象可以继续被增加、删除和修改;而伴随空间产生的,也不只有最终呈现的图像,还包括深度、分割、点云、相机参数等训练所需要的信息。
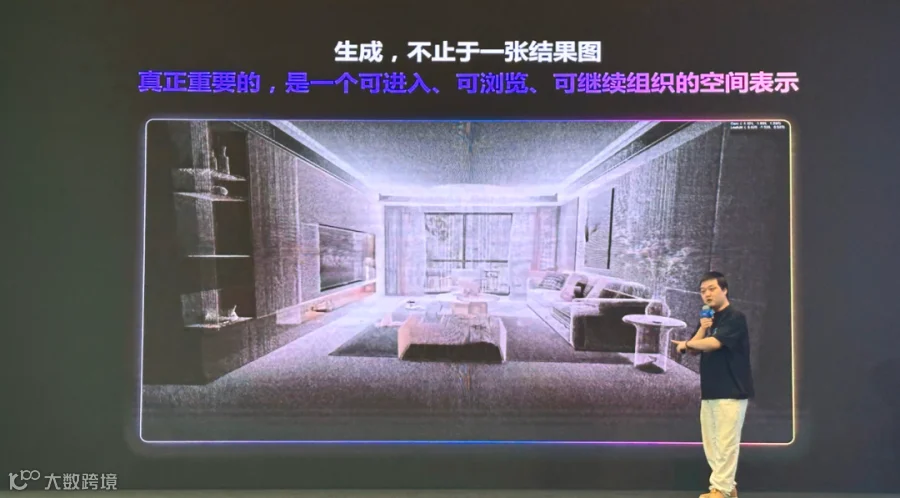
JoinAI 希望解决的,并不只是“怎样生成一个世界”,而是怎样让生成的世界,进一步成为 Physical AI 可以学习的经验。
从一句 Prompt 开始,让空间成为可以继续“生长”的世界,过去几年,生成式 AI 已经越来越擅长生成逼真的图像和视频。但对于正在进入物理世界的 AI 来说,“看起来真实”远远不够。
机器人(具身智能)、自动驾驶以及更多 Physical AI 系统真正需要理解的,是物体在哪里、彼此之间是什么关系、空间如何组织,以及当主体与环境发生交互时,世界会如何变化。
因此,相比生成一张/批量生成多张最终结果图,JoinAI 此次发布的空间生成平台更关注另一件事情:
生成一个可以被进入、被编辑、被重新组织,并继续产生训练数据的空间。
现场演示中,用户只需要通过自然语言描述需要的场景,即可直接进入空间构成;生成后的场景不是一张固定的图片,而是一个“可进入、可浏览、可继续组织”的空间表示。
空间中的对象也成为可以被操作的基本单位。
例如,一句“在杂志上放置一个玻璃杯”的指令,就可以改变场景中的对象及其关系,而不需要重新生成一张无法继续操作的结果图。

这背后改变的,不只是空间生成的方法。
当空间中的对象、关系与环境条件都成为可以被定义的变量,数据生产也开始从“等待场景发生”,走向“主动定义需要发生什么”。
生成一张图不是终点,真正重要的是它能产生什么可被传递的经验(experience)对于 Physical AI 来说,一个可以被编辑的空间依然只是起点。真正能够进入训练流程的,是这个空间中包含的视觉、空间、时间与交互信息。
因此,在此次展示中,JoinAI 将生成后的空间进一步转化为图像与视频,并同步提供包括 Depth、Segmentation、Point Cloud、Camera Parameters 等在内的空间与物理信息。
这意味着,同一个被构建出来的世界,可以进一步成为不同训练任务的数据来源,而不只是一次性的视觉生成结果。
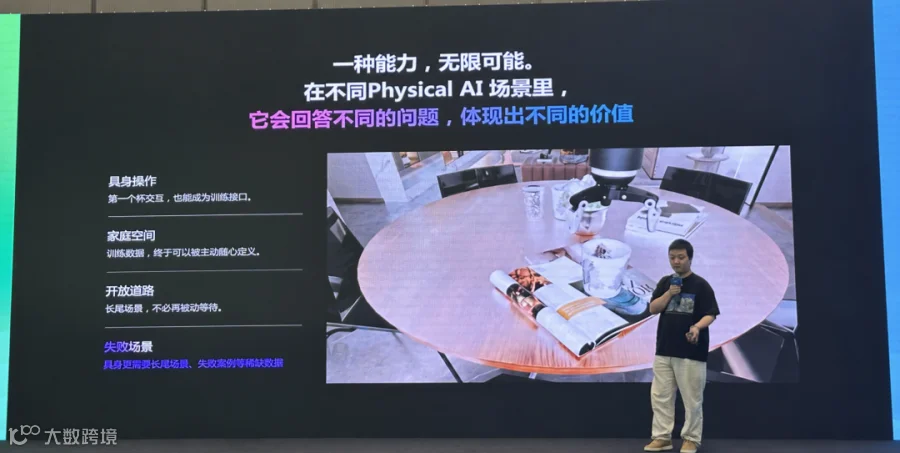
一个可学习的世界,不应该只输出一种数据。
这也是 JoinAI 空间生成平台与其既有产品和技术能力开始发生连接的地方。在 JoinAI 的产品体系中,空间生成并不是一项孤立能力。
以 Simulaix 为载体的场景与数据生产、组织能力,与空间构成、生成式世界建模以及 Terra 世界模型共同形成一条从“构建世界”走向“产生训练经验”的链路。
空间构成让对象、关系和环境成为可以主动定义的变量;生成式世界建模进一步扩展视觉、空间与时间维度的信息;而不同模态的数据最终进入下游训练与评测流程。
世界被构建,经验被生成,模型完成训练与评测,结果又进一步影响下一轮需要构建什么样的数据和场景。
JoinAI 想建立的,不是一次生成,而是一条持续运转的数据闭环。
Physical AI 真正稀缺的,是那些“需要、但还没有发生”的经验,这也是为什么 JoinAI 将空间生成指向 Physical AI,而不是停留在生成本身。
真实世界的数据采集天然受到成本、时间、隐私和场景发生概率的限制;传统仿真则高度依赖人工与预设规则,在真实性和规模化扩展之间持续面临取舍。
但对于 Physical AI 而言,真正决定模型能力边界的,往往恰恰是那些不容易发生的情况。
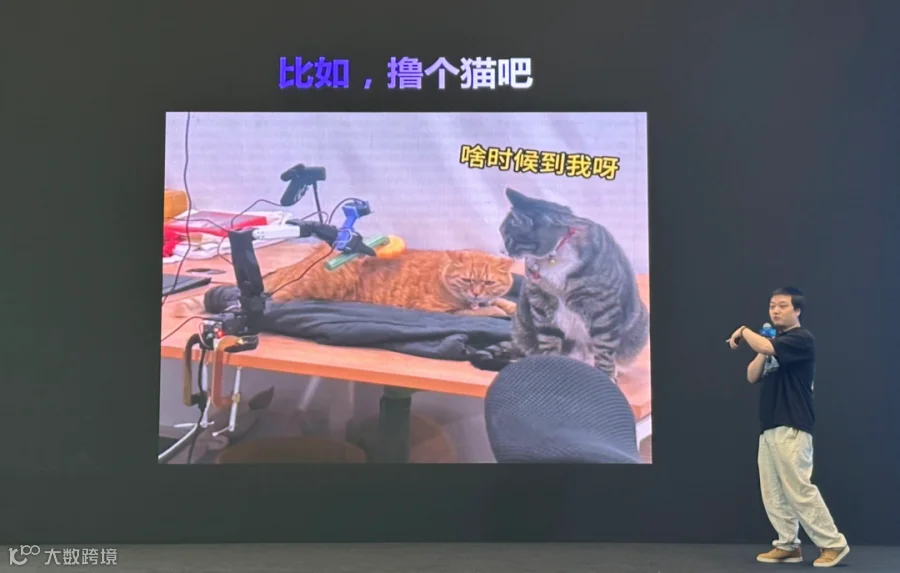
真正决定上限的,是非常规 case。
一个已经学会正常抓取杯子的机器人,下一步真正缺少的,未必是更多“成功抓起杯子”的数据。它可能需要的是杯子被遮挡、位置发生变化、抓取失败、环境突然改变,甚至执行过程中出现意外碰撞时的经验。
就像之前的自动驾驶,正常道路每天都在发生,但真正决定系统安全边界的长尾场景,却无法按照训练需要随时在现实世界中重现。
Physical AI 面临的问题并不只是“数据够不够多”。
更进一步的问题是:
模型现在不会什么?下一步需要经历什么?这些经验能不能被主动构建出来?
在 JoinAI 展示的产品体系中,家庭空间可以重新构成,对象可以被增加和移动,同一环境可以产生不同观察,长尾与失败场景也可以被主动定义,并进一步转化为对应的训练数据。
从具身操作、家庭空间,到开放道路与失败场景,空间生成因此开始承担一个新的角色:
除了常规场景,让长尾场景和非常规case也不必再被动等待,让训练需要的经验可以被主动定义。
从数据交付到效果交付:为什么是 Experience Layer?
在现场分享中,俞开文也进一步谈到了 JoinAI 对 Physical AI 数据问题的判断,以及公司为什么将下一阶段定义为 “The Experience Layer for Physical AI”。
“Physical AI 真正缺少的,不只是更多数据,而是足够丰富、能够持续迭代的经验。我们希望做的,是把这些原本只能在真实世界中等待发生的经验,变成可以主动构建、规模化生成,并根据模型效果持续迭代的基础设施。这就是我们所说的 Experience Layer。”
——JoinAI 创始人兼 CEO 俞开文
对于 JoinAI 而言,Experience Layer 并不是对“空间生成”的重新命名。
相反,它试图把过去几年逐渐形成的能力连接到同一个闭环之中:
真实世界的数据与知识进入系统,空间与场景可以被主动构建,世界模型进一步生成和扩展训练所需要的经验,而训练与评测结果再次反馈到数据生产过程。
从这个角度看,空间生成只是 Experience Layer 的一个入口。
它解决的是“世界如何被构建”;而更进一步的问题,是这些世界如何成为模型真正需要的训练经验,又如何根据模型效果持续变化。
这也延续了 JoinAI 一直强调的另一件事:
从数据交付,到效果交付。

Physical AI 需要的不是无限堆积的数据,而是能够真正改变模型表现的数据。当模型能力成为数据生产的反馈信号,“生成什么”就不再只由数据供给决定,而开始由模型下一步“需要学会什么”决定。
从生成世界,到生成经验 -
当 AI 从语言世界走向物理世界,数据问题也正在随之变化。
核心瓶颈不再只是“有没有数据”,而是能否有效地构建世界、表示世界,并让模型与真实世界之间持续形成数据闭环。
从空间构成,到生成式世界建模;
从图像和视频,到空间、物理与交互信息;
从数据生产,到训练、评测与反馈。
JoinAI 正在做的事,是让 Physical AI 所需要的经验,从只能在真实世界中被动获得,进一步成为可以被主动构建、规模化生成,并根据模型效果持续迭代的一层基础设施。
The Experience Layer for Physical AI.
Better data, Better AI,
For everyone, Forever.