

📝 英文题目:Artificial intelligence and generative AI in entrepreneurship education: A systematic review of competency development, entrepreneurial intention, and the sustainability disconnect
📚 来源期刊:The International Journal of Management Education
🗓 发表时间:2027-03-01
✍ 作者:Raya Sulistyowati, Jejen Jaenal Aripin, Khusnul Fikriyah, Ade Sobandi, Merlyn Kurniawati, Asti Putri Kartiwi, Farizki Maulana Rafliansyah
🏆 期刊等级:JCR Q1 · 中科院 教育学1区 · TOP 教育学TOP · SSCI Q1 · Scopus
📌 本文看点
01
创业教育
02
生成式 AI(GenAI)
03
AI 三层分级(生成式 / 广义 AI / 分析式 AI)
BACKGROUND
研究背景
问题提出
创业教育这两年上 AI 上的很凶,而且不只是「上课用一下」的程度。AI 已经写进了课程设计、商业模式画布、机会识别训练、商业计划书打磨这一整条链条里。 与此同时,第二个压力从旁边压过来:可持续发展议程。高校被要求把创业教育跟联合国可持续发展目标(SDG)对齐,创业教育也确实被证明能影响可持续创业意向。于是「AI + 创业教育 + 可持续发展」这三个词被很自然地缝在了一起,变成了一句听上去完全成立的因果链:用了 AI → 学生能力更强 → 创业意向更高 → 顺带还能推动 SDG。 问题在于:这条链的每一环都有文献在声称,但没有一篇综述从头到尾走过一遍。 相关综述各有各的停靠点——有的停在技术本身(GenAI 在创业教育里怎么用),有的停在能力,有的只谈伦理。没人把「AI 采纳 → 能力形成 → 可持续性产出」这条路走完,更没人去查:那些关于可持续性的说法,到底有没有被测量过。 一句话概括本文要处理的现实问题:创业教育领域关于 AI 的说法,跑得比证据快。
难点剖析
难点有四,而且每一个都是「不做这一步,结论就站不住」的那种难点。
(1)「AI」不是一个构念,是三个。检索出来的 21 篇里,有的研究让学生用 ChatGPT 做商业模式设计(生成式),有的测的是「AI 使用」这种笼统感知(广义),有的用的是 KABADA 这种贝叶斯网络的商业规划平台(分析式,压根不生成任何东西)。把这三类混在一起做汇总,就等于用一个数字去回答三个不同的问题。 本文的解法是把证据按 AI 类型分层:Tier 1 生成式(9 篇)、Tier 2 广义 AI(7 篇)、Tier 3 分析式非生成式(5 篇)——后面所有结论都必须交代自己站在哪一层上。
(2)时间锚点抓不住。这个领域的研究对象(生成式 AI)有一个明确的发布日(ChatGPT,2022 年 11 月),所以「数据什么时候收的」本应是硬信息。但11 篇(52.4%)根本没报数据收集时间。作者的处理是「记录这个缺陷,而不是从发表年份倒推收集期」——这个克制很关键,因为从发表年倒推,恰好会把「前 ChatGPT 时代的研究」伪装成「生成式 AI 研究」。
(3)可持续性这个词在文献里有两层意思,混着用。一层是名义相关:任何一篇在高校里做的、跟创业有关的研究,都能被轻松映射到 SDG 4(优质教育)或 SDG 8(体面工作与经济增长);另一层是真的测量了可持续性结果。如果只统计前者,「覆盖率」可以做到很好看,但那只是在数上下文,不是在数证据。 本文把这两层彻底分开编码,也明确排除「审查者自行推断出来的 SDG 映射」,不进结论。
(4)能不能做元分析,不由综述作者决定。元分析需要精度信息(SE / CI),而21 篇里只有 5 篇报标准误、3 篇报置信区间(还只报了间接效应)。所以本文从一开始就放弃了合并效应量,一律报告描述性趋势,并用四组敏感性分析替代元分析的功能。
理论脉络
本文不是「文献综述 + 一些理论」,而是两个功能完全分开的框架拼在一起(Fig. 1)。这是全文方法上最值得学的地方。
① CIMO 逻辑(Denyer 等,2008)——用在「设计阶段」,负责把问题拆成检索条件。四个要素分别是: - Context(情境)=高等教育创业项目里的学生; - Intervention(干预)=AI(生成式或其他),出现在教学场景里或被测量为学习者层面的构念; - Mechanism(机制)=AI 辅助学习可能起作用的过程:能力/才能发展、自我效能形成、机会识别、风险感知、创业拼凑、心理距离; - Outcome(结果)=创业意向与创业能力,再加上可持续性专属结果与 SDG 关联。 CIMO 在这里的价值是纯操作性的:每一个要素在检索之前就必须写死,而每一条写死的规格都会变成一条纳入/排除标准(IC1–IC3)。
② TCM-ADO 框架(Paul 等,2017; Paul & Benito, 2018)——用在「分析阶段」,负责组织提取出来的证据。 - TCM(理论-情境-方法)负责给领域画地图:理论一栏清点 21 篇用过的框架、指出整合性理论的空缺;情境一栏记地理、机构、参与者,以及数据收集期(正因为有这个字段,才能判断每篇研究坐在 ChatGPT 发布线的前面还是后面);方法一栏记研究设计、分析技术和报告了哪些不确定性信息——这让「这个领域报告习惯有多差」变成一个看得见的事实,而不是印象。 - ADO(前因-决策-结果)负责组织实质性综合。
③ 一处刻意的改动:把 ADO 里的「D(Decisions 决策)」改写成「M(Mechanisms 机制)」。作者解释得很清楚:这不是装饰性的改名。原版 ADO 的 D 是给管理者列选项清单的,而本文的兴趣是解释性的——它要做的是中介与调节的综合,不是一个管理者可以做哪些选择的目录。所以 D 必须换成 M,框架才装得下「什么通过什么、在什么条件下起作用」这类命题。
④ 两个框架的咬合点就是纳入标准本身:CIMO 管设计的一半、产出进入本综述的准入条件;TCM-ADO 管分析的一半、产出组织证据的结构;纳入标准是两者的铰链。合起来,这篇综述才能不止回答「研究过什么」,而是回答「哪条主张有哪些证据在撑」。
⑤ 作者明确声明与既有综述不争高低,只列三点不同:追随完整路径(AI 采纳 → 能力形成 → 可持续性产出,此前无综述走完);按 AI 类型分层(因为把 AI 当单一构念会掩盖哪些发现其实依赖生成式系统);把 SDG 的名义相关与 SDG 实际测量分开——这一步把一个关于可持续性的修辞式主张,转成了一个可以被实证检验的主张。
METHOD
研究方法
理论模型
这是一篇系统综述,没有统计模型,但有两条「模型」需要看清:一条是综述自己的设计模型,一条是它最终画出的领域整合概念模型(Fig. 4)。后者是这篇论文真正的产出。 一、设计模型:CIMO × TCM-ADO 的咬合(Fig. 1) - CIMO 在前:把 Context-Intervention-Mechanism-Outcome 四个要素在检索前写死,每一条规格变成一条纳入标准(IC1 干预=AI;IC2 结果=可持续性专属或一般创业构念;IC3 情境=高等教育创业项目)。 - TCM-ADO 在后:Theory / Context / Methods 画领域地图,Antecedents / Mechanisms / Outcomes 组织实质证据。 - 关键设计选择:Outcome 栏里挂了一条「可持续性分支」,且明确规定研究不必满足这一分支即可入组。作者说得很明白——正因为「允许但不要求」,本文才可能把「这类结果的缺席」报告为一项实证发现,而不是用筛选规则把它提前抹掉。这一句话是全篇最聪明的方法决策。 二、整合概念模型:三列结构 + 路径系数(Fig. 4) ① ANTECEDENTS(前因)——三个框 - GenAI 整合式教学法ᵃ(Tier 1) - 创业教育ᵃ - AI 使用、AI 素养与 AI 能力ᵇ(Tier 2) - 组织准备度ᵇ(虚线框,标注「hypothesis——仅 1 篇」:这是被降级的那个机构因素主张) ② MECHANISMS(机制)——四个框 - 创业自我效能与 AI 自我效能(实线框,标注「mediates and moderates」——它同时是中介和调节) - 机会识别(实线框) - 风险感知(实线框) - 能力与才能发展(虚线框,标注「untested for generative AI」——对生成式 AI 未经检验) ③ OUTCOMES(结果)——三个框,两个带叉 - 创业意向(实线框,标注「12 of 21 studies; all positive」) - 创业行为(虚线框 + 打叉的箭头,标注「not measured (0 of 21)」) - 创业能力(实线框,标注「4 studies」) - 可持续性产出(虚线框 + 打叉的箭头,标注「not measured in any study (0 of 21); 16 of 21 never mention the SDGs; no study names an environmental SDG」) ④ 图上的路径系数(全部来自具体研究,不是合并估计) - GenAI 整合式教学法 → 创业意向:β = 0.244(同时有一条直达顶部的弧线) - GenAI 整合式教学法 → 自我效能:β = 0.523 - 创业教育 → 自我效能:β = 0.596 - AI 使用/素养/能力 → 机会识别:β = 0.214;→ 风险感知:β = −0.072;→ 能力发展:β = 0.743 - 能力与才能发展 → 创业能力:β = 0.578 - 组织准备度 → 能力发展:虚线箭头,标注「hypothesis」 ⑤ 一句话读图法:这张图用「实线/虚线」和「有没有打叉」把整个领域的证据状态编码了。实线框=已被检验到;虚线框=主张存在但没被检验(或只被非生成式证据撑);打叉的箭头=这个结果一篇都没测过。所以 Fig. 4 不只是模型,它本身是一张证据缺口地图——画到最后,右边那一列有三格是空的或虚的,这就是全文的结论。
研究问题与预期命题
这是系统综述,不设统计假设,但作者在开篇明确给出了三条「原初主张」,并在讨论部分逐条公开推翻或降级——这是本文最有学性的结构,所以这里按「预期 vs. 实证」对照列出。 本文要回答的总问题:创业教育里的 AI,这套证据能支持什么?又支持不了什么? 开篇立下的三条原初主张(作者的初稿读法) - 主张 A:AI 对创业意向的效应不仅方向为正,而且解释力可观。 - 主张 B:能力发展是核心机制——AI 是通过提升能力来提升意向的。 - 主张 C:组织因素比技术先进性更重要。 分层与质量加权之后的实证裁决 - 主张 A → 方向保留,幅度撤回。方向:支持(12/12 全正)。幅度:不可知。理由三条,条条致命:最大的 R² 来自质量评分最低的两篇、其中最大的那个来自一篇前 ChatGPT 的「广义 AI」研究(这正是 Sterne 等 2011 描述的漏斗图不对称的主要来源:最弱的设计给出最强的估计);而且不到四分之一的研究报标准误,想检验也检验不了。 - 主张 B → 降级为研究优先事项(research priority),不再作为既定发现。理由:撑着这个机制的三篇(Imjai 2024、Gong 2025、Utama 2026)全部是 Tier 2——测的都是笼统的「AI」,没有一篇真的部署生成式工具;而在 Tier 1 证据里,唯一看能力的是 Somià & Vecchiarini (2024),53 人、没报任何推断统计、没有 p 值、没有置信区间。作者还给出了一个很具体的理论理由说明「为什么两者可能真的不同」,见下条「分析策略」。 - 主张 C → 降级为待检验假设(hypothesis)。理由:整个主张只压在一篇 Tier 2 研究(Gong 等 2025)身上,而且这篇的因变量是 AI 营销绩效,不是任何教育结果,全样本里没有第二篇能佐证。 四条贯穿全文的「预期方向」(作者认为证据能支持的部分) - ① 方向一致性:所有测了意向的研究,AI 都是正向——跨三个 AI 层级、四个大洲、十一种理论框架都成立。这是全文最有信心的一条。 - ② 自我效能是边界条件:自我效能高的学习者,从 AI 增强的创业教育里获益更多。 - ③ 双路径结构:AI 使用同时通过提升机会识别(正)和抬高风险感知(负)作用于意向,净效应取决于两者平衡。 - ④ 可持续性断层:名义相关遍地,实测为零。 一个必须点出来的自我修正姿态:作者用的措辞是「在我们原本给出的三条读法上,分层且质量加权的证据并不支持我们最初的解读」。一篇综述公开把自己开篇的判断退回,这个动作本身就是本文的方法论示范。
分析策略
分析路线五步:PRISMA 流程 → AI 三层分级 → MMAT 逐条质量评价 → SDG 双层编码 → 四组敏感性分析。全程不做元分析。 ① PRISMA 2020 检索与筛选(检索截止 2026 年 2 月 5 日) - 数据库:Scopus(Title-Abstract-Keywords)+ Web of Science 核心合集(Topic),不限年份、不限学科,限同行评议英文期刊论文。 - 检索式结构(三块 AND):AI 词块 × 创业教育词块 × 可持续性词块。 - 检索结果漏斗:154 条(Scopus 107 / WoS 47)→ 过滤器后 92 条(54 / 38)→ 去重后 59 条唯一记录 → 全文评估后纳入 21 篇。 - 一个必须交代的检索式缺陷(作者主动披露):Scopus 检索式里,可持续性词块前的 AND 没有加括号,导致三个可持续性词变成了析取项而非第三个合取块——结果是 54 条 Scopus 记录里有 32 条根本不含任何可持续性词。这个缺陷的影响是检索更宽而非更窄,所以不会漏掉相关研究,但它确实是这套检索式的一个技术瑕疵,作者选择写出来而不是藏起来。 ② AI 三层分级(本文最核心的分析创新) - Tier 1 生成式 AI(9 篇):ChatGPT、Claude、Gemini、DeepSeek、DALL·E、Jasper 等。 - Tier 2 广义 AI(7 篇):把 AI 作为一个笼统构念测量,或研究一般的 AI 采纳。 - Tier 3 分析式非生成式 AI(5 篇):如 KABADA(贝叶斯网络的商业规划平台)、深度学习预测模型等。 - 分层的理由:如果把检索到的「AI in general」当作一个构念,就会允许作者对生成式 AI 下结论——而那些结论其实建立在别的技术上。所有结论都必须说明自己站在哪一层。 ③ 质量评价:MMAT 2018(Mixed Methods Appraisal Tool, Hong 等 2018)逐条评价 - 结果:高(5/5)6 篇、良(4/5)4 篇、中(3/5)5 篇、低(2/5)3 篇、极低(1/5)2 篇,另 1 篇设计开发类研究在 MMAT 的结果导向条目上不可评价。 - 良好及以上占 47.6%(10/21)。两篇 1/5 的研究没报任何推断统计,因此对本综述不贡献任何量化主张。 - 作者的一句关键判断:这个领域的弱点不在它选了哪些估计方法,而在它没报什么。 ④ SDG 双层编码(本文第二个分析创新) - 维度一:关联依据——明确(点名了具体 SDG)/泛泛(提了 SDG 但没点名)/审查者推断(没提,但内容可以做映射)/无。审查者推断出来的映射只作报告、不进结论。 - 维度二:测量状态——已测量/部分测量/仅讨论/未测量。 - 关键规则:部分测量那一档是针对那一个例外写的——Somià & Vecchiarini (2024) 把「伦理与可持续思维」作为 EntreComp 量表里的一个条目测了(M = 3.566,SEM = 0.122),这只是自评能力评分而不是可持续性结果,而且作者自己都说明:他们的量表没有明确涉及 ChatGPT 在促进可持续性上的作用。这条被单独标注、单独排除。 ⑤ 四组敏感性分析(本用来替代元分析) - 限定 Tier 1 → 意向的正向关联成立(5 篇 Tier 1 测了意向,5 篇全正);自我效能边界条件成立(受独立性限定);能力中介机制不成立;机构因素主张无 Tier 1 研究涉及;可持续性断层加强(9 篇 Tier 1 里 0 篇测了可持续性结果,8 篇从没提过 SDG)。 - 剔除低质量研究(MMAT ≤ 2/5) → 方向全部不变,但两个后果:意向的 R² 区间收窄到 0.269–0.468(原先的两个极端值 0.881 和 0.587 恰好都来自 2/5 和 1/5 的研究);社会创业结果的证据彻底消失(因为它只靠 Ng 等 2024 一篇撑着)。 - 剔重(Duong 2026 与 Nguyen, Duong 等 2025 报告的是同一批 1061 名受访者) → 唯一参与者总数降到 约 7801,自我效能证据收缩为来自 2 个课题组的 3 个独立样本。没有任何关联发生方向反转。 - 剔除前 ChatGPT 研究 → 方向全部不变,同一个 R² 区间再次收窄到 0.269–0.468。结论:这个文献里最大的那些效应,恰恰来自与生成式 AI 关系最弱的研究。 ⑥ 一个反过来的机制解释(讨论部分最精彩的一段) 作者为「为什么生成式 AI 与广义 AI 可能真的不同」给了一条具体推理:分析式 AI 只是给练习搭脚手架,任务最终还是学习者自己完成;而生成式系统可以替学习者完成任务——于是意向上去了,能力却没动,产出的是「自信的、但能力是空的」学习者。这不是作者臆测,而是一个认知科学已有结论的必然预测:人在「外包比自己做更省力」时就会外包认知工作,而外包出去的东西不会被保留下来(Risko & Gilbert, 2016; Sparrow 等,2011)。Gerlich (2025) 把这个结论搬到了 AI 工具上——高频使用与更强的认知外包、更低的关键思维得分相关,且在年轻用户中最明显,恰恰是本样本抽取的人群。而 21 篇研究里,一篇都没有引用这条文献。
DESIGN
实验设计
数据收集
不是实验,是系统综述的检索与筛选流程;但有两条「收集」需要交代清楚——文献的纳入过程和数据的提取过程。 一、文献收集(PRISMA 2020 四阶段) ① 识别(Identification) - 时间:2026 年 2 月 5 日执行检索(这个日期很重要,后面会变成一条自我声明的局限)。 - 数据库:Scopus(TITLE-ABS-KEY)与 Web of Science 核心合集(Topic)两库并行。 - 语言与类型:限同行评议英文期刊论文;不限年份、不限学科领域。 - 命中:Scopus 107 条 + WoS 47 条 = 154 条。 ② 筛选(Screening) - 过滤器后降至 92 条(Scopus 54 / WoS 38)。 - 去重后得到 59 条唯一记录。 ③ 资格评估(Eligibility)——三条纳入标准(IC): - IC1:在高等教育创业教育场景中部署了 AI(生成式或其他),或把 AI 作为学习者层面的构念进行测量。 - IC2:析取式标准——满足「特定可持续性构念」或「一般创业构念」任一即可入选。作者专门解释了为什么 IC2 要设计成析取:如果要求必须有可持续性结果,样本会接近空集,而「缺席」这件事本身就会被筛选规则抹掉;也正因为 IC2 是析取的,「缺少可持续性结果测量」就不能再作为排除理由。 - 对应的排除项还包括:只谈 SDG 而不涉及 AI 或创业教育的研究应被排除。 - IC3:情境为高等教育创业项目中的学生。 ④ 纳入(Included) - 最终 21 篇实证研究。 - 注意这个数字的构成:21 篇里有 2 篇是前 ChatGPT 时代的(Nuseir 等 2020;Zhu & Zhang 2022),1 篇横跨发布线(Lešinskis 等 2023)——生成式 AI 的占比在整批证据里其实不到一半,这也正是本文必须做 AI 分层的原因。 二、数据提取 - 结构与 CIMO / TCM-ADO 一一对应:CIMO 的四要素 ↔(IC1–IC3 纳入标准);TCM-ADO 的六个分析维度 ↔ 提取字段。 - CIMO 的 Mechanism 一栏直接变成提取字段:能力与才能发展、自我效能形成、机会识别、风险感知、创业拼砌(bricolage)、心理距离——六个机制维度。 - 每篇研究额外提取三类关键信息:① 数据收集期(用于判定前/后 ChatGPT,11 篇缺失);
② 报告的不确定性信息(点估计 / p 值 / 检验统计量 / 标准误 / 置信区间五档,逐篇编码);
③ SDG 双层编码(关联依据 + 测量状态)。 三、提取质量的两个保障 - 质量评价与提取分离:MMAT 逐条评价产出的是每篇研究的方法质量评级(1/5 到 5/5),这个评级随后被用作敏感性分析的过滤器,而不是用来给研究「打分排名」。 - 推断与证据分离:所有「审查者推断出来的 SDG 映射」都被单独编码、单独报告,明确排除在结论之外——这条规则挡住了最容易做漂亮的那个数字(把所有高校研究都映射到 SDG 4)。 四、伦理与资金声明 - 本文未获任何专项资助;无利益冲突声明;数据应要求提供。 - 附生成式 AI 使用声明(见金句部分)——这个细节对一篇研究生成式 AI 的论文来说,构成了一处有趣的自我指涉。
研究样本
样本是 21 篇实证研究,不是人。但把它们的人口学特征汇总起来,样本画像非常清楚——而且这个画像本身就是一条局限。 一、规模 - 21 篇实证研究,合计约 7801 名不重复参与者(去重前约 8862,因两篇研究报告的是同一批 1061 名受访者——Duong 2026 与 Nguyen, Duong 等 2025——按一次计入)。 - 覆盖 14 个国家。 二、设计构成 - 横截面调查 42.9%(n = 9)——最常见 - 准实验 23.8%(n = 5) - 混合方法 19.0%(n = 4) - 时序/纵向调查 9.5%(n = 2) - 设计型研究(design-based research)4.8%(n = 1) - 关键缺席:整批证据里没有任何一项随机对照试验(RCT)。 三、地理分布(集中度很高) - 亚洲 57.1%,其中中国大陆单独占 28.6%(n = 6) - 东南亚 23.8%(越南 3、泰国 1、印尼 1) - 欧洲 19.0% - 中东与南亚 14.3% - 拉美 4.8%、北美 4.8% - 作者点名的空白区:撒哈拉以南非洲与南美基本缺席,这直接限制了结论的可迁移性。 四、学科与人群 - 全部位于高等教育场景;商学与管理类项目占 66.7%。 - 本科生占 90.5%;只有 Cocu 等 (2025) 与 Ng 等 (2024) 在商学课程之外。 - 一处必须标注的例外:Cocu 等 (2025) 的 64 名参与者是创业者,不是学生(这也是它无法进入「学习者结果」结论的原因)。 五、AI 类型分布(决定所有结论的适用范围) - Tier 1 生成式 AI:9 篇 - Tier 2 广义 AI:7 篇 - Tier 3 分析式非生成式 AI:5 篇 - 前 ChatGPT 研究:2 篇,横跨发布线:1 篇 六、时间锚点的缺失(本文最硬的一处质量批评) - 11 篇(52.4%)没有报告数据收集时间。 - 在一个「研究对象有明确发布日」的领域里,这是实质性报告缺陷——因为无法报收集期,就无法判断一篇研究的结论到底属于生成式 AI,还是属于它之前的技术。作者的态度是:记录它,而不是从发表年份去倒推它。 七、参与者规模的两个极端(值得单看) - 最大:Duong (2026),1061 人(越南,横截面) - 最小:Ng 等 (2024),45 人(38 名对照 + 7 名实验)——而这唯一一篇还撑着社会创业方向的证据,在剔除低质量研究后,这条证据就消失了。作者对这一处的措辞很直接:社会维度「实质上缺席」,唯一候选研究只有 7 名自我选择的学生组成的实验组,且其社会责任分量表上报告无显著变化。
测量工具
系统综述的「工具」不是量表,是评价与编码工具。本文一共用了四件,每一件都在对应位置上解决了「否则就无法成立」的问题。 ① 报告规范工具:PRISMA 2020(Page 等,2021) 用于检索、筛选、资格评估、纳入全流程的透明化报告,产出 Fig. 2 的流程图(154 → 92 → 59 → 21)。 ② 设计逻辑工具:CIMO(Denyer 等,2008) Context / Intervention / Mechanism / Outcome 四要素在检索前写死,直接转译为 IC1–IC3 纳入标准。其中 Mechanism 一栏的六个过程——能力与才能发展、自我效能形成、机会识别、风险感知、创业拼凑、心理距离——直接成为数据提取字段。 ③ 综合分析工具:TCM-ADO(Paul 等,2017; Paul & Benito, 2018) - TCM 半部:Theory(理论清点与整合空缺)、Context(地理、机构、参与者、数据收集期)、Methods(研究设计、分析技术、不确定性报告实践)。 - ADO 半部:Antecedents / Mechanisms(本文把原版 Decisions 改写为 Mechanisms,因为要做的是中介-调节综合而非管理选项目录) / Outcomes。 ④ 质量评价工具:MMAT 2018(Mixed Methods Appraisal Tool, Hong 等,2018) - 逐条(item-by-item)评价,按研究类型选用对应条目集;分级:5/5 高、4/5 良、3/5 中、2/5 低、1/5 极低。 - 产出两级用途:① 描述领域质量画像(良好及以上 47.6%);② 作为敏感性分析的过滤条件(剔除 ≤2/5 的研究后重跑全部结论)。 - 一处必须说明的边界:设计开发类研究在 MMAT 的结果导向条目上不可评价,本文明确标注而不强行打分。 ⑤ 自建编码方案:SDG 双层编码 - 维度一(关联依据):明确(点名具体 SDG)/泛泛(提了但没点名)/审查者推断(没提但可映射)/无。 - 维度二(测量状态):已测量/部分测量(专门为「量表里的一个条目」这种情况设的一档)/仅讨论/未测量。 - 配套硬规则:审查者推断的映射只报告、不进结论;点名的环境类 SDG 单独统计。 ⑥ 自建分类工具:AI 三层分级 Tier 1 生成式(点名了具体生成式系统)/Tier 2 广义 AI(笼统测量 AI)/Tier 3 分析式非生成式(如 KABADA 贝叶斯商业规划平台)。这套分级的作用是给每一条结论贴上一个适用范围标签,防止把分析式 AI 的发现说成生成式 AI 的发现。 ⑦ 报告完整度编码(把「没报什么」也变成数据) 对每篇研究逐项编码五个层次的精度信息是否报告:点估计(17/21,81.0%)、p 值(15/21,71.4%)、检验统计量(11/21,52.4%)、标准误(5/21,23.8%)、置信区间(3/21,14.3%,且仅限间接效应)。 - 这套编码就是「为什么不做元分析」的证据基础——不是作者不想做,是这套文献根本不提供可合并的精度信息。 ⑧ 敏感性分析(替代元分析的四把校准尺)
① 限定 Tier 1;
② 剔除 MMAT ≤2/5;
③ 剔除重复样本;
④ 剔除前 ChatGPT 研究。每一组都重跑全部结论,只有方向不变才保留。
RESULTS
结果与分析
质量评价与报告完整度
先给结论:本文的可信度不在「结果有多稳」,而在「它主动把不稳的地方标出来了」。 (1)质量画像:MMAT 2018 逐条评价(21 篇全员) - 高(5/5):6 篇 - 良(4/5):4 篇 - 中(3/5):5 篇 - 低(2/5):3 篇 - 极低(1/5):2 篇 - 不可评价:1 篇(设计开发型研究,在 MMAT 结果导向条目上无法评价) - 良好及以上合计 47.6%(10/21) - 两篇 1/5 研究没有报告任何推断统计,因此对本综述不贡献任何量化主张。 (2)报告完整度:这才是真正的弱点(本文最有力的一张证据表) - 点估计:17/21 = 81.0% - p 值:15/21 = 71.4% - 检验统计量:11/21 = 52.4% - 标准误:5/21 = 23.8% - 置信区间:3/21 = 14.3%(且仅限间接效应) - 作者判断:「这个领域的弱点不在它选了哪些估计方法,而在它没报什么」——不到四分之一的研究提供了合并所需的精度信息,这是文献的属性,不是综述的属性,它框定了任何综合能合法声称的边界。 - 一个连带的报告缺陷:11 篇(52.4%)没有报告数据收集时间;在一个研究对象有明确发布日的领域,这是实质性报告失败。 (3)为什么不做元分析——这就是答案 - SE 只有 5 篇、CI 只有 3 篇(且只覆盖间接效应)。因此本文全程报告描述性趋势,不做任何合并估计,并用四组敏感性分析替代元分析的功能。这是一个「承认工具不足所以不用工具」的决定,而不是「懒得做」。 (4)四组敏感性分析:什么活了、什么死了、什么加强了 | 分析 | 结果 | | --- | --- | | 限定 Tier 1(生成式) | ✅ 意向正向关联成立(5 篇 Tier 1 测意向,5 篇全正)<br>✅ 自我效能边界条件成立(受独立性限定)<br>❌ 能力中介机制不成立(理由见下)<br>❌ 机构因素主张无 Tier 1 研究涉及<br>🔺 可持续性断层加强(9 篇 Tier 1 里 0 篇测可持续性结果,8 篇从没提 SDG) | | 剔除低质量研究(MMAT ≤2/5) | 方向全部不变;但 R² 区间收窄为 0.269–0.468(原先极端值 0.881 与 0.587 恰好来自 2/5 与 1/5 的研究);社会创业结果的证据彻底消失(原本只靠 Ng 等 2024 一篇) | | 剔除重复样本 | 唯一参与者总数降至 约 7801;自我效能证据收缩为来自 2 个课题组的 3 个独立样本;无任何关联方向反转 | | 剔除前 ChatGPT 研究 | 方向全部不变;R² 区间同样收窄为 0.269–0.468;「最大的效果来自与生成式 AI 最不相关的研究」这一模式被确证 | (5)本文最强的一处方法诚实:自我效能的「4 篇」不是 4 次独立复现 - 表面看有 4 篇研究支持自我效能的调节作用,但:Duong (2026) 与 Nguyen, Duong 等 (2025) 报告的是同一批 1061 名受访者,Duong & Vu (2025) 与它们共享第一作者。 - 实际证据量:来自 2 个课题组的 3 个独立样本;其中只有 Xie & Wang (2025) 完全独立于 Duong 课题组。 - 作者的措辞是:方向不受影响,但证据的分量比「4 篇」这个数字所暗示的要轻。 (6)另一处被坦白的混淆:R² 之间不可比 - 9 篇报告了意向结果的 R²,区间 0.269(Zulfiqar 等 2026)到 0.881(Nuseir 等 2020),中位数 0.443。 - 作者明确说:这个区间只作描述,不从中做任何推断——因为它们指向不同构念、来自不同估计方法、且有的纳入协变量有的没有。「这个文献表面上很强的解释力,部分是弱测量的产物。」 (7)须一并说明的边界 - 无 RCT;横截面主导;无一篇测量真实创业行为(意向-行为缺口完全未被处理);地理高度集中于亚洲与中国;21 篇本身是窄基底;检索截止 2026 年 2 月,作者自称这是一份「带有已知保质期的快照」。
核心发现与敏感性检验
核心结论五条:方向一致性 | 幅度不可知 | 能力中介降级 | 自我效能边界条件 (但证据量打折)| 可持续性断层 。
---
【一】创业意向:方向极其一致,幅度不能信
方向(本文最有信心的一条)
- 21 篇里 12 篇测量了意向结果(一般/数字/电子创业意向),12 篇全部报告与 AI 或生成式 AI 的正向关联。
- 这个方向一致性跨三个 AI 层级、四个大洲、十一种理论框架成立——作者称其在创业教育文献中「罕见地宽」。
幅度(三条问题叠加)
- R² 区间 0.269 – 0.881,中位数 0.443。两个最大值(0.881、0.587)恰好来自两篇质量评分最低的研究,而且最大的那个来自一篇前 ChatGPT 的「广义 AI」研究。
- 这正是 Sterne 等 (2011) 指出的漏斗图不对称的首要来源:最弱的设计给出最强的估计。而本文无法检验它——因为不到四分之一的研究报了标准误。
- 共同方法偏差:几乎所有研究都在同一个人身上、用同一个工具、在同一时点同时测量前因和结果——正是 Podsakoff 等 (2003) 指出放大效应最强的那种配置,而 21 篇没有一篇采用他们推荐的补救措施。
- 意向是行动的有损代理(Kautonen 等 2015),而没有一篇研究测量了真实创业行为——意向-行为缺口完全未被处理。
- 作者的原话最狠:「看起来很强的解释力,是这个文献里最弱的成员生产出来的。方向可信;大小目前无从得知。」
- 顺带被推翻的一个常见主张:AI 是否优于创业教育本身,这是一个开放问题,不是一项发现。
---
【二】能力中介机制:降级为「研究优先事项」
- 表面证据:能力与才能发展是出现最频繁的被提中介。
- Imjai 等 (2024):串行模型 AI 能力 → 设计思维 → 战略智能 → 创新型创业能力,其中战略智能是最强预测变量(β = 0.578);
- Gong 等 (2025):动态能力中介 AI 驱动因素与营销绩效(β = 0.459, f² = 0.460);
- Utama 等 (2026):AI 采纳 → 创业能力直接路径 β = 0.457;
- Somià & Vecchiarini (2024):ChatGPT 使用最多提升 EntreComp 的「评估想法(Valuing Ideas)」领域(Cohen‘s d = 0.328–0.516)。
- 致命限定:撑着这个机制的三篇(Imjai 2024、Gong 2025、Utama 2026)全部是 Tier 2——测的都是笼统的「AI」,没有一篇部署生成式工具。而在 Tier 1 证据内部,只有 Somià & Vecchiarini (2024) 一篇看了能力,53 人、没有推断检验、没有 p 值、没有置信区间。
- 作者的处理:「能力中介机制在一般人工智能上得到良好支持,在生成式 AI 上基本未经检验;我们把它报告为研究优先事项,而不是既定发现。」
- 为什么两者可能真的不同(这是全文最有价值的一段推理):分析式 AI 给练习搭脚手架,任务最终仍由学习者完成;生成式系统可以直接替学习者完成任务——于是意向上去了,能力却没动,产出「自信的、但能力是空的」学习者。这不是猜测,而是认知科学的一个既有预测(人在外包比自己做更省力时会外包认知,被外包的东西不保留——Risko & Gilbert 2016;Sparrow 等 2011),Gerlich (2025) 已把这一结论搬到 AI 工具上(高频使用与更强认知外包、更低关键思维得分相关,在年轻用户中最明显——恰恰是本样本的人群)。而 21 篇研究一篇都没引用这条文献。
- 唯一在生成式条件下看能力的那篇,报告的正是这种矛盾:参与者认可 ChatGPT 提升了想法评估,但在创造力上回答不一致——一种「增强 vs. 替代」的张力,作者指出但没有解决。
---
【三】双路径结构:一个「统一正向叙事」解释不了的异常
- Zou & Guo (2026):AI 使用同时通过提升机会识别(β = 0.214)和抬高风险感知(β = −0.072)作用于创业意向,净效应取决于两者平衡。
- Nguyen, Duong 等 (2025) 概念性复现了这种不对称:生成式 AI 提升了感知合意性(desirability),但没有提升感知可行性(feasibility)。
- 作者补上的理论解释(文献自己没做的):用解释水平理论看,合意性是高解释水平构念、可行性是低解释水平构念——一个「让创业变得容易想象、同时暴露执行难度」的工具,理应把这两者拉开。研究们报告了这个分裂,但没有一篇去解释它。
- 它解释了什么异常:Mavlutova 等 (2025) 发现 AI 提升了感知技能与行为控制,但没有显著提升意向的态度或情感维度——如果 AI 同时抬高机会意识和风险显著性,两种相反效价在态度测量上相互抵消,而仍然在技能类测量上显形。「这个模式不是噪声,它就是一条双路径过程在只观察其态度净值时应该长的样子。」
- 落点不是压制风险感知,而是给它配仪表:Pandey & Chadha (2026) 表明在机会识别之外同时建设风险承担能力才能促进创业成长。风险感知不是需要被最小化的缺陷。
---
【四】自我效能:边界条件成立,但它顺带暴露了一个没人测量的公平问题
- 模式:自我效能(创业的与 AI 特定的)是最一致的调节变量,出现在 4 篇研究中,角色互补:Duong (2026) 显示 AI 自我效能强化「AI 素养 → 数字创业自我效能」这条路;Xie & Wang (2025) 显示创业自我效能中介「GenAI 整合教育 → 意向」;Duong & Vu (2025) 与 Nguyen, Duong 等 (2025) 佐证其调节作用。
- 证据量打折(见上):4 篇 ≠ 4 次独立复现,实际是 2 个课题组的 3 个独立样本,只有 Xie & Wang (2025) 完全独立。方向不受影响,分量比「4 篇」轻。
- 这条模式最值得记住的含义:按面值接受,它意味着一种「自我效能放大效应」——Merton (1968) 命名的累积优势逻辑,从科学生涯搬到了课堂技术上:AI 让本来就有信心的人获益更多,而对最需要支持的人增益更温和。
- 如果这是真的:无脚手架地部署 AI 会抬高班级均值,同时拉大班内离散度——而一个只报均值的评估(本样本里每一篇都是这样)根本检测不到这件事。作者那句最锋利:「一种被用来普及创业机会的技术,可能在悄悄地把它分层。」
- 两层对策:教学上的对策是脚手架与导师制;测量上的对策更简单,而且没有一篇研究采用——报告方差,不只报告均值。
---
【五】SDG 与可持续性断层:不是测量缺口,是整套框架的缺席
测量维度(明确、无歧义)
- 没有任何一篇研究测量了可持续性专属结果。没有一篇采用经过验证的可持续/绿色创业意向量表、可持续性能力工具,或任何环境或社会类 SDG 指标作为因变量。
- 唯一的「部分例外」:Somià & Vecchiarini (2024) 把「伦理与可持续思维」作为 EntreComp 量表里的一个条目测了(M = 3.566,SEM = 0.122)——这是自评能力评分,不是可持续性结果,而且作者自己指出:他们的工具没有任何明确涉及 ChatGPT 在促进可持续性上的作用的表述。本文报告它以求透明,但排除在结论之外。
关联维度(同样刺眼)
- 只有 2 篇点名了任何 SDG:Manrique Molina 等 (2025) 引用 SDG 4、8、9;Lešinskis 等 (2023) 引用 SDG 4。而两篇的引用都出现在背景框架里,不在研究设计里。
- 3 篇泛泛提及 SDG 而不点名(Gong 等 2025;Mavlutova 等 2025;Ng 等 2024)。
- 16 篇(76.2%)从没提过可持续发展目标,没有一篇点名环境类 SDG。
- 唯一内容上真正以可持续性为导向的一篇:Cocu 等 (2025) 用生成式 AI 加 RAG,抽取并专家验证了 159 个可持续性触发点(刻画环境与可持续商业实践)。但即便如此,可持续性存在于平台里,而不存在于任何被测量的学习者结果里——它的 64 名参与者是创业者不是学生,学习者试点留作未来工作,且没点名任何 SDG。
- 作者提前堵住了一个漂亮的数字:任何更高的「覆盖率」(比如因为研究发生在大学里就把大多数研究映射到 SDG 4)都是从上下文推断的,而不是研究自己声称的——这类推断被排除在本文结论之外。
按可持续性的三维拆解看,断层更彻底
- 经济维度:文献几乎只涉及——通过创业意向、营销绩效、就业能力。
- 环境维度:完全缺席——样本里任何地方都没有测量绿色创业意向、循环性或气候相关能力。
- 社会维度:实质缺席——唯一候选研究(Ng 等 2024)的实验组只有 7 名自我选择的学生,且其社会责任分量表报告无显著变化。
- 作者结论:「这道断层不是文献边缘的一个细微测量缺口,而是可持续性框架整个不存在于这个领域的实证词汇里。」
---
【六】被降级与被推翻的那条
- 原初主张「组织因素比技术先进性更重要」不成立:它只压在一篇 Tier 2 研究(Gong 等 2025)身上,而那篇测的是笼统 AI、因变量是 AI 营销绩效而非任何教育结果,全样本没有第二篇佐证,没有任何生成式 AI 研究涉及这个问题。
- 相邻文献确实同情这个主张(教师培训、伦理治理、课程对齐被识别为成功要素),但作者把界限划得很清楚:「相邻文献里的同情,不是本综述里的证据。我们把这个主张重述为需要直接检验的假设。」——这条正是 Fig. 4 里那个虚线框、标注「hypothesis—one study」的来源。
---
【七】最干净的一个实验结果,与「技术」无关
- Manrique Molina 等 (2025) 发现:自主型教学法(反思式、原理式)在促进伦理化 AI 使用上,大幅优于他律型(规则式)(显著对比 Cohen’s d = 0.525–1.100);而他律型策略与「不干预」在统计上无法区分(d = 0.055, p = .999)。
- 一句话:告诉学生 ChatGPT 的使用规则,什么都没达成;让他们去推理规则为什么存在,达成了很多。
- 这正是自我决定理论预测的(自主支持的教导把规则内化,控制式的教导让规则停留在外部且惰性)。而本文的另一个自嘲式发现是:这个文献里最干净的发现,是由一个 21 篇研究全都没引用的理论解释的——这本身就是这个领域理论狭窄程度的一个度量。
CONCLUSION
总体结论
研究结论
① 主结论一:方向可信,幅度不可知。 每一个测了创业意向的研究都报告了与 AI 的正向关联,而且这个一致性跨三个 AI 层级、四个大洲、十一种理论框架都成立——这个方向一致性本身就罕见,也是本文最有信心的一条。但幅度不能信:最大的解释力数值来自质量最差的研究,最大的那个还来自一篇前 ChatGPT 的「广义 AI」研究,而且绝大多数研究不报任何不确定性信息。作者的判断可以浓缩成一句:「这个文献表面上的解释力,是它最弱的成员生产出来的。方向可信;大小暂时无从得知。」
② 主结论二:领域最相信的那个机制,还没在生成式 AI 上被检验过。 「AI 通过提升能力来提升意向」是文献最常提的中介,但撑它的三篇全部只测了笼统的「AI」,没有一篇让学生真的用生成式工具;而在生成式证据内部,能力只被一篇 53 人的研究看过,那篇连推断统计都没报。更关键的是为什么两者可能真的不同:分析式 AI 给练习搭脚手架,生成式系统可以直接把任务做掉——于是意向上去了、能力没动,产出「自信但能力是空的」学习者。这不是猜测,而是认知科学早有结论的必然预测(被外包出去的认知工作不会被保留),而 21 篇研究一篇都没引过这条文献。
③ 主结论三:可持续性断层比初稿判断更严重——它是理论上的,其次才是实证上的。 没有一篇测量可持续性专属结果,大多数从没提过 SDG,没有一篇点名环境目标,也没有一篇使用可持续性科学框架。 作者特别强调:这个缺席不能用「缺理论或缺工具」来开脱——可持续创业作为领域已存在十余年,可持续性关键能力参考框架、高等教育可持续创业综合能力框架都早有提案并被验证;这些构念已被明确、工具已被验证,这个文献只是不去拿它们。所以作者的原话是:「这道断层是一个选择,不是一个约束。」
④ 为什么它是「理论上先于实证上」的断层:一个领域测不出它的理论没有命名的东西。 主流框架——计划行为理论(TPB)、刺激-机体-反应(SOR)、技术接受模型(TAM)——里面没有任何一个可持续性构念;而流通中的测量工具都源自不含任何可持续性条目的通用意向量表。这就是断层的结构性解释:「一个领域无法测量它的理论没有命名的东西。」 而借助创业推动环境可持续性,需要有意识地对齐具体的 SDG 目标——在这里,这种对齐不是「弱」,而是「不存在」。
⑤ 对理论化的三个具体动作(本文给领域开的处方) - 从「意向形成」转向「分布式能力形成」:TPB 把胜任力定位在个体内部、把环境只当作规范来源;但当学习者与生成模型共同产出一个创业概念时,能力是分布在这个配对上的——这正是社会物质性(socio-material)与分布式认知视角本来要描述的状态。它的推论证伪点很具体:真正的问题不是「学生能不能完成任务」,而是「把 AI 撤走之后还剩下什么」——而没有一篇研究问过这个问题。 - 从「接受」转向「挪用(appropriation)」:TAM 与 UTAUT 只能建模学习者是否接受一个工具,无法建模学习者是把工具从属于自身目的,还是把自身目的从属于工具——而这正是适应性结构化理论(adaptive structuration)所说的 appropriation。上面两个异常(合意性/可行性分裂、技能提升但态度不动)都是它的症状。文中已在样本里出现但未被充分利用的两个理论——解释水平理论与动态能力理论——形状正好合适。 - 从「通用能力」转向「可持续导向的能力」:验证过的框架已经存在(Ploum 等 2018);在采用一个之前,「AI 增强的创业教育推进了 SDG」这个主张不只是无证据,而是不可检验的——因为这个领域根本没有一个构念可以让这个主张失败。
⑥ 给实践者的三条(作者明确说「最清楚的证据是关于教学法而非技术」) - 让学生推理「为什么存在这些 AI 使用规则」,优于只发布规则(这是他律型 d = 0.055 与自主型 d = 0.525–1.100 之间的差距)。 - 无脚手架地部署 AI,有扩大「自信学习者」与其余人之间距离的风险——而只报均值的评估看不见这件事。 - 教学上的对策是脚手架与导师制;测量上的对策是报告方差,不只是均值——后者更简单,而且没有一篇研究采用。
⑦ 一句话概括这篇综述的性格:它的贡献与其说是累积性的,不如说是纠正性的——它把自己开篇的三条读法退回了两条半,把「能力中介」降级为研究优先事项、把「机构比技术重要」降级为待检验假设,然后把整张证据缺口图画成了模型图上的虚线框和叉号。
研究局限
作者把局限分成两层来写:证据基底自身的局限(限定上面每一条结论),以及本综述自己新增的局限。这个结构本身值得学。 一、证据基底的局限(限定所有结论) 1. 地理高度集中,限制可迁移性。样本集中在亚洲(57.1%),中国大陆单独占 28.6%,撒哈拉以南非洲与南美基本缺席。作者明确指出这限制了结论向欠代表地区的外推。 2. 横截面主导,且没有任何随机对照试验(RCT),这约束了因果推断。设计分布为:横截面 42.9%、准实验 23.8%、混合方法 19.0%、时序/纵向 9.5%、设计型 4.8%。 3. 不到四分之一的研究报告标准误——这是「为什么做不了元分析」的直接原因,也因此本文报告的每一个效应量都只是描述性趋势,不是合并估计。 4. 没有任何一篇测量真实创业行为,全部依赖意向类或自评类结果,意向-行为缺口完全没被处理。 5. 超过一半的研究不报告数据收集时间(11/21 = 52.4%)——在一个由特定发布日期(ChatGPT, 2022-11)定义的领域里,这是实质性的报告失败。 二、本综述自身的局限(作者主动新增) 6. 快速演进技术领域的不可消除的时序问题:检索于 2026 年 2 月关闭,而这个领域的研究对象按季度发布周期被修订,稍后出现的工作可能实质性改变证据基底。因此作者自己给这份综述下了定义:「应当被读作一份带有已知保质期的快照」,并预期生成式 AI 在这批文献中的占比(目前不到一半)会快速上升。 7. 可持续性的处理是概括性的:虽然把可持续性拆成经济、环境、社会三维,但并没有为每一维应用独立的检索词。作者明确说:一个专门针对绿色创业意向或循环经济能力的检索式,可能找出本文漏掉的研究——这一点被标注而不是被驳开,即便原检索式确实包含了可持续创业与 SDG 词、且纳入的研究里没有一篇测量了任何可持续性结果。 8. 排除了非英文文献。 9. AI 构念的异质性是真实存在的——这正是证据按层级分层而不做合并的原因,但也意味着本文不能提供一个关于「AI」的单一效应估计。 10. 21 篇研究作为基底太窄,不足以承载任何确定性结论。 三、一节特别值得注意的自我披露(不算在局限里,但性质相近) - 检索式本身有一处技术瑕疵:Scopus 检索式中「sustainable entrepreneurship」前的 AND 没加括号,导致三个可持续性词成为析取项而非第三个合取块,54 条 Scopus 记录中有 32 条不含任何可持续性词。作者主动写出来,并说明其影响是「检索更宽而非更窄」,因此不会漏掉相关研究。 一篇批评文献报告习惯的论文,把自己的检索瑕疵也写进正文——这个动作和它的论点是一致的。
未来展望
作者给出的未来研究不是一串愿望清单,而是三条「不做就无法推进」的优先事项,另加三个理论动作。 一、三条优先事项(直接对应断层)
① 确立生成式 AI 是在「建设能力」还是在「替代能力」——方法是测量工具被撤走之后学习者还留下什么。 - 这是全文方法上最具体的一条可执行指令:不要只测学生「能不能完成任务」,要在 AI 撤走后测「还剩下什么」。 - 对应设计上的改造:必须有一篇研究测出「AI 撤走后的留存」。 作者的原话是:「没有人能解决这个问题,因为没有任何研究测量过学习者在 AI 被撤走之后能做什么。在这种设计改变发生之前,能力中介只是一个假设,我们就把它当成一个假设来报告。」
② 报告不确定性,并测量意向之外的结果——只有这样才能让「幅度」变得可知。 - 具体门槛已经从本文的数据里算出来了:从 23.8% 报标准误的现状往上走,否则元分析永远做不了,效应大小永远只能停在「方向可信、大小不可知」。 - 同时必须走出意向:测量真实创业行为(当前 0/21),打破意向-行为缺口。
③ 采用一个已验证的可持续创业能力框架——否则「AI 推进 SDG」这个主张不可检验。 - 可用资源是现成的:可持续性关键能力参考框架(Wiek 等 2011)、高等教育可持续创业综合能力框架(Lans 等 2014)、已验证的可持续创业能力框架(Ploum 等 2018)。 - 在采用之前,这个领域连一个「可以让该主张失败」的构念都没有——这就是为什么作者说这个断层是理论上的。 二、三个理论动作(本文 5.7 节给出的处方)
④ 从「意向形成」→「分布式能力形成」。 - 当学生与生成模型共同产出创业概念时,能力分布在这个配对上,而不是装在个体里。 - 可借用的视角:社会物质性(Orlikowski, 2007)、分布式认知。样本里没有一篇引入过它们。
⑤ 从「接受」→「挪用(appropriation)」。 - TAM / UTAUT 只能建模「是否接受」,不能建模「谁从属于谁」——是学习者把工具从属于自身目的,还是把自身目的从属于工具。 - 可借用的视角:适应性结构化理论(DeSanctis & Poole, 1994);文中已出现但未被充分开发的两个理论——解释水平理论(Trope & Liberman, 2010)与动态能力理论(Teece, 2007)——形状正好适合做这件事。
⑥ 从「通用能力」→「可持续导向能力」。 - 直接落点是采纳现有的已验证框架,让可持续性主张变成可以被数据推翻的主张。 三、两条针对测量实践的具体建议(散见于讨论,价值很高)
⑦ 报告方差,不只报告均值。如果自我效能的放大效应是真的,无脚手架部署 AI 会抬高均值同时拉大离散度——而只报均值的评估结构上看不见这一点。修改一条统计表就能解决,但没有一篇研究这样做。
⑧ 把风险感知从「待消除的缺陷」改成「需要配仪表的过程变量」。 - 双路径结构说明 AI 同时抬高机会意识与风险显著性,压制其中一条只会扭曲净效应; - 可延伸的方向:在机会识别之外同时建设风险承担能力(Pandey & Chadha, 2026)。 四、一条针对「文献生态」的建议(作者用叙述方式给出的)
⑨ 把认知科学那条文献接进来。外包认知工作不会被保留——这条结论已被搬到 AI 工具上(Gerlich, 2025),而且恰恰在年轻人群中效应最强,也就是本领域的样本人群。21 篇研究无一引用。 接上这条线,才可能真正回答优先事项
①。
金句
原文:“The direction is credible; the size is not yet knowable.”(Sulistyowati et al., 2027) 解读:这大概是全篇最该被抄在自己本子上的一句话,共十一个单词。 它把一整个领域的证据状态压缩成了一次切割——把「方向」和「大小」当成两件不同的事,分开下判断。我们平时看文献最容易犯的错,就是把这两件事合成一句「AI 对创业意向有显著正向影响」。但方向的一致性和幅度的大小,需要完全不同的证据质量来支撑:方向只需要大家都往一个方向走(12/12 都正),幅度需要精度信息(标准误、置信区间),而这个领域只有 23.8% 的研究提供标准误。所以那些看起来很大的 R²(0.881、0.587)不是发现,是缺证据的产物——它们恰好来自质量最差的两篇。这句话的实用价值在于它给了一条判断模板:以后读到「X 显著提升 Y」,先问方向,再问研究者有没有资格告诉你大小。如果没有,「方向可信、大小不可知」才是诚实的表述。 原文:“The disconnect is thus not a subtle measurement gap but a near-total absence of the sustainability frame from the field‘s empirical vocabulary.” 以及 “The gap is a choice, not a constraint.”(Sulistyowati et al., 2027) 解读:这两句放在一起,是全文最锋利的一段。前半句把「断层」的性质说清楚了:它不是「测得不够准」,是「根本没测」——21 篇里 0 篇测过可持续性结果,没有一篇点名环境类 SDG,76.2% 全程没提 SDG。后半句更狠,它把责任落到了具体位置:这不是能力问题,是选择问题。 因为作者特意去查了「是不是缺理论、缺工具」——答案是都齐了:可持续创业作为领域已存在十余年,可持续性关键能力框架有(Wiek 等 2011),高等教育可持续创业能力框架有(Lans 等 2014),而且还被验证过(Ploum 等 2018)。工具架上摆着仪器,研究者只是不去拿。 这个论断之所以有力,是因为它不是道德指责,而是有清单支撑的事实陈述。它也给所有做「用 AI 推进可持续教育」的人提了个醒:别只说自己对齐了几个 SDG,先看看你测了什么。 原文:“A field cannot measure what its theory does not name.”(Sulistyowati et al., 2027) 解读:这是本文对「为什么断层会存在」给出结构性解释的那把钥匙。 作者没有把断层归因于研究者不重视可持续性,而是指出了一条更底层的机制:主流的三个框架——计划行为理论(TPB)、刺激-机体-反应(SOR)、技术接受模型(TAM)——里面没有任何一个可持续性构念;而流通中的测量工具都是从通用意向量表衍生来的,那些量表里根本没有可持续性条目。所以结果就是:你若问一个 TPB 研究者「AI 教学有没有提升可持续性」,他的模型里连一个能回答这个问题的变量都没有。 这句话的价值在方法层面可以推广到任何领域:当你发现某个重要变量总是「没被测量」,第一件该查的事不是研究者疏忽,而是主流理论里有没有命名它。 工具不是凭空长出来的,它长在理论的命名能力上。 原文(讨论 5.4 节末尾):“A technology adopted to democratise entrepreneurial opportunity may quietly stratify it.”(Sulistyowati et al., 2027) 解读:这句话是全文唯一的「预告式警告」,而且它来自一个只是「方向成立」的发现。逻辑链条很紧:自我效能被反复证实是边界条件——自我效能高的人,从 AI 增强的创业教育里获益更多。按面值接受,这就是Merton (1968) 命名的累积优势效应,从科学生涯搬到了课堂:AI 让本来就有信心的人收获更多,对最需要帮助的人增益更小。如果这是真的,无脚手架地部署 AI 会抬高班级平均值,同时把班内差距拉大——而本样本里每一篇研究都只报均值,结构上检测不到这件事。所以这句警告不只是修辞:它指出的是评估工具的盲区。作者给的对策也极简:教学上是脚手架和导师制;测量上是「报告方差,不只报告均值」——修改一张统计表就能做的事,没有一篇研究做。 原文(讨论部分最干净的一个对照):“Telling students the rules for using ChatGPT achieved nothing; having them reason about why the rules exist achieved a great deal.”(Sulistyowati et al., 2027) 解读:这是全文唯一一个「干净」的实验结果——而且它跟技术无关,跟教学法有关。Manrique Molina 等 (2025) 的对比极为干脆:自主型教学法(反思式、原理式)在促进伦理化 AI 使用上,显著对比的效应量达到 Cohen’s d = 0.525–1.100;而他律型(规则式)策略与「什么都不做」在统计上根本无法区分(d = 0.055, p = .999)。翻译成人话:你发一份《AI 使用规范》贴在群公告里,效果等于没发;你让学生坐下来讨论「为什么要有这条规范」,效果显著。 作者补的那一笔更值得记:这个文献里最干净的发现,是由一个 21 篇研究全都没引用过的理论(自我决定理论)解释的——这本身就是这个领域理论狭窄程度的一个度量。对一线老师来说,这条的可操作性最高:你不是需要更好的 AI 工具,你需要换一种讲规则的方式。 延伸解读(一处很有意思的自我指涉):这篇论文在正文里带了一份生成式 AI 使用声明——作者使用了 Claude(Anthropic)与 ChatGPT(OpenAI) 来协助文献综合的组织、语言润色,以及主题类别的初步结构化,并在使用后由作者审阅与编辑、承担全部责任。也就是说:一篇系统综述了 21 篇「AI 在创业教育里的作用」的论文,自己的工作流里就有生成式 AI,而且它选择写出来、写上具体产品名、并把责任边界划清楚。 这个动作与它论文里的主张形成了呼应——它没有假装 AI 不存在于学术生产里,而是把使用情况作为可核查的事实披露出来。这一点,比很多只在方法部分泛泛写一句「no AI was used」的论文要诚实得多。
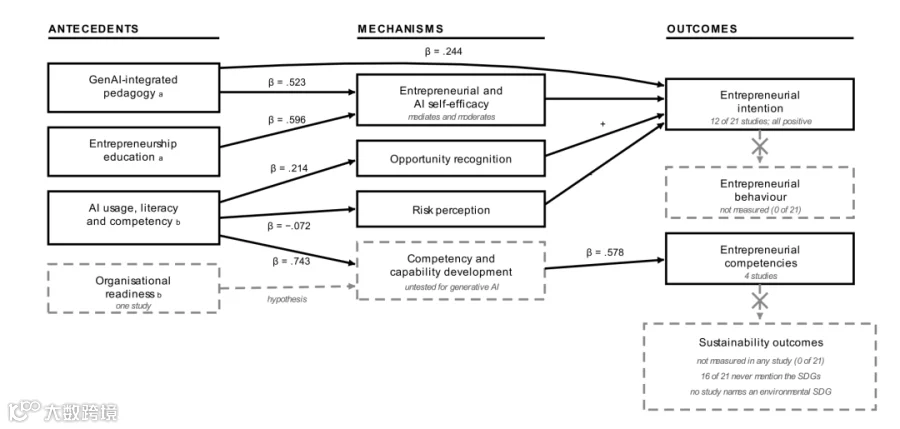
— 研究模型图
📄 摘要原文
Entrepreneurship education increasingly deploys artificial intelligence (AI), yet claims that it builds entrepreneurial competence and advances sustainability rest on an unexamined evidence base. This review asks what that evidence supports, and what it does not. Following PRISMA 2020, Scopus and Web of Science searches yielded 21 empirical studies with approximately 7800 unique participants across 14 countries. Studies were stratified as generative, broader or analytical AI, quality was appraised item by item with the Mixed Methods Appraisal Tool, and every conclusion was tested by sensitivity analysis. CIMO logic specified the question; TCM-ADO organised the synthesis. AI was positively associated with entrepreneurial intention in every study that measured it, but its magnitude cannot be established: the largest estimates come from the lowest-quality studies, and few report uncertainty estimates. Competency development, the assumed mechanism, rests almost entirely on non-generative AI studies and is untested for generative systems. Self-efficacy operates as a boundary condition, raising an equity concern no study measures. Nominal relevance to the Sustainable Development Goals is widespread, yet none measured a sustainability outcome or named an environmental goal. It supplies a stratified, quality-weighted evidence base and shows that closing the sustainability gap requires theory and instruments, not more intention surveys.
📎 阅读原文:DOI: 10.1016/j.ijme.2026.101524
END
我是扣子,高校教师/在读博士/AI顾问。关注AIGC,学术科研,博士生活;分享AI赋能和论文带读,打破AI信息差。视频号:扣子说AI。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。
欢迎关注我的视频号
(❤️会不定期更新AI工具哦❤️)

三连一下,不失联!