


9月11日,国家数据产权登记服务系统上线试运行。
从这天起,数据可以领一张“身份证”了。登记机构会在凭证上写明三件事,谁持有、谁能用、谁能经营。
上线首日,56份数据产权登记凭证向社会公示。
往前推十天,9月1日,两项数据资产国家标准正式实施。一项管分类,把数据资产分成结构化、半结构化、非结构化三个小类、十五个细类;一项管登记,把初始、变更、注销三类登记的流程统一了起来。
制度这一侧,走得很快。
但把这些制度放在一起看,会发现它们有一个共同的、没被写出来的前提。
你得先知道,自己有什么数据。
登记要填登记对象,分类要落到具体条目,入表要先确认资产范围。这些动作头一件事都不是确权,是盘点。
而对相当多的企业来说,事情就卡在这一步。
卡住的原因也很现实。盘点这件事不直接带来收益,它不会让报表变快,不会让大屏变好看,也不会在汇报里出现一个漂亮的成果。于是它总是排在所有“能看见东西”的项目后面,一推就是几年。

可以做几个很简单的自测。
问一家企业,你们现在有多少张在用的报表?答不上来。
哪些数据每天都在被访问?大概能说几个,说不全。
哪些数据从建好那天起就没被打开过?没人知道。
这三个问题跟技术没关系,甚至跟系统贵不贵也没关系。它们只问一件事,你有没有一本账。
有意思的对比就在这里。
同样一家公司,你问上个月差旅费花了多少,财务能给你一个数,精确到元。因为这个数有科目、有凭证、有报销单,每一笔都能追到具体的人和时间。
你再问,上个月经营分析用到的那几个指标,是从哪些数据算出来的?
会议室会安静一会儿。
钱有账,数据没账。
这不是疏忽,是这两样东西在组织里的地位从来就不一样。钱是资产,从第一笔开始就要记账;数据是副产品,业务系统跑起来它就在那儿了,没人被要求给它记一笔。
于是就出现了一个很奇怪的局面。一家企业可以为几千块钱的报销走三层审批,却说不清自己手里到底有哪些数据。
真下决心做过一次盘点的企业,通常会遇到两个意外。
第一个意外是,数据比想象中少。以为自己有一座矿,清完发现常用的就那么几十项,其余都是重复抄送、临时导出、以及不知道谁在维护的副本。
第二个意外是,同一批数据在不同部门有三个名字。销售叫它客户档案,售后叫它服务记录,财务叫它往来单位,说的其实是同一张表。

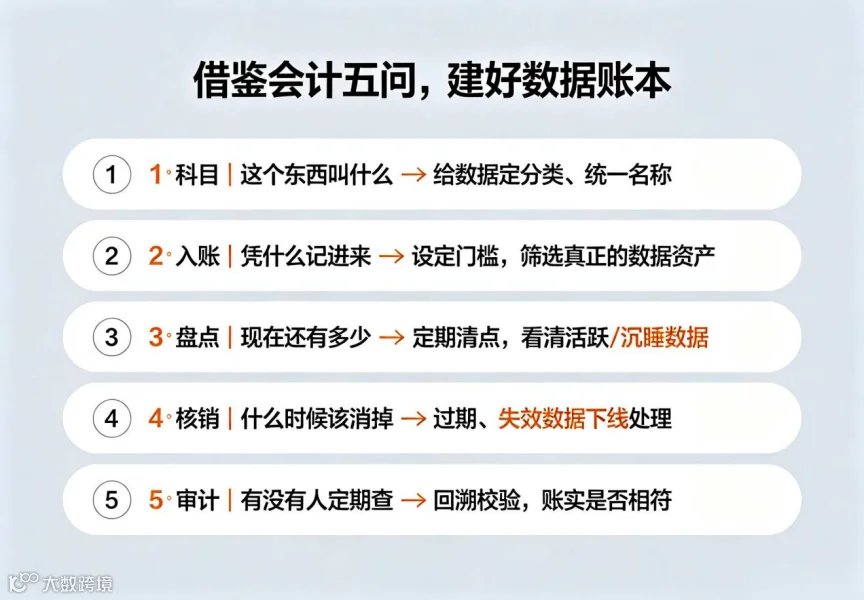
会计这套东西能运转几百年,不是因为它高级,是因为它回答了五个很朴素的问题。
这个东西叫什么,这是科目。
凭什么记进来,这是入账。
现在还有多少,这是盘点。
什么时候该消掉,这是核销。
有没有人定期查,这是审计。
五个问题,没有一个是技术难题。它们只是一套需要长期执行的纪律。
数据之所以在企业里管不起来,恰恰是因为这五个问题一个都没被回答过。
谁的系统产生了数据,数据就留在谁那里。业务部门不会去登记它产生了什么,IT部门只对系统不宕机负责。中间没有任何一个岗位,被明确要求把这笔数据记下来。
所以数据的处境很特别。它每天都在产生,每天都在被使用,但从来没有被清点过。
没有被清点过的东西,就没法被管理。这不是数据领域特有的规律,这是所有资产管理的常识。
制度在往下游使劲。产权登记解决的是数据走出企业之后怎么被认可,入表解决的是数据怎么进财务报表,都是必要的一步。
但它们都默认了一件事,数据已经被找出来了。制度设计者也清楚这个前提——国家数据局在《数据产权登记工作指引》中围绕统一登记对象、统一登记类型等“六统一”做出安排,其中“统一登记对象”本身就要求企业对自身数据有基本认知。但制度只能规范动作,不能替企业完成动作。
国标给出的分类框架是三个小类、十五个细类,那是面向登记和流通的,企业不必照抄。
但企业必须有自己的一套。
至少要能回答一个问题,在一家公司里,哪些数据算资产。
注意是“哪些算”,不是“有多少”。数据资产和数据的区别在于,前者被人反复使用,后者只是躺在硬盘上。
分类还有个容易被忽略的作用,统一名字。上面那三个名字,得在分类表里并成一条,并且注明它的正式叫法、由哪个系统产生、归哪个部门。
这一步不需要任何系统投入,只需要有人把大家叫到一间会议室,把名字对一遍。
具体怎么做,别一上来就全公司铺开。挑一个业务域先做,销售、生产、供应链,哪个最常被老板问就先做哪个。
把这一个域里正在产生的数据列出来,订单、客户、库存、价格、费用、达成率。
列完你会发现两件事。一是比你以为的少,二是有些你以为有的,其实从来没被存下来。
列清单这个动作本身,就值一次项目立项会。
会计入账是有门槛的。一笔支出要记进来,得是真实发生的、有凭证的、能计量的。不是所有流水都能进账。
数据这边从来没有这道门槛。
于是企业里的状态通常是两种极端。
一种是什么都不记。系统里的数据一大堆,但没有任何一份清单说清楚哪些是被认可的资产,用到的时候临时找,找到了就用手头的那一份。
另一种是什么都记。日志、临时表、三年前某个项目的中间表,全都算资产,全都堆在那儿。
这两种极端的结果是同一个,账本上全是噪音,真正重要的那几项反而看不出来。
补这一道关,只需要定一条简单的标准。被两个以上部门使用过的数据,进账;影响过一次实际决策的数据,进账;其余的先放在候补区,不占用资产的位置。
标准不必精确,粗糙一点没关系。候补区也不必删,它只是暂时不占资产的位置,半年后再看一次,还在候补区的,通常就可以下线了。
它的作用不是保证准确,是把“值得管”和“不值得管”分开。
一道门槛立起来之后,后面四道关才有工作量可言。不然一本账要管几千项,管到第二年一定烂尾。
会计每月结账,每年清查。数据从来没有这个动作。
结果是数据只增不减。表建了就不删,任务跑了就不停,接口接了就不下线。三年下来,库里躺着几百张表,一半以上一年都没被访问过,但存储和运维成本一分不少。
更麻烦的是,没人知道哪一半是有用的。
盘点头一件事不是清理,是看清。
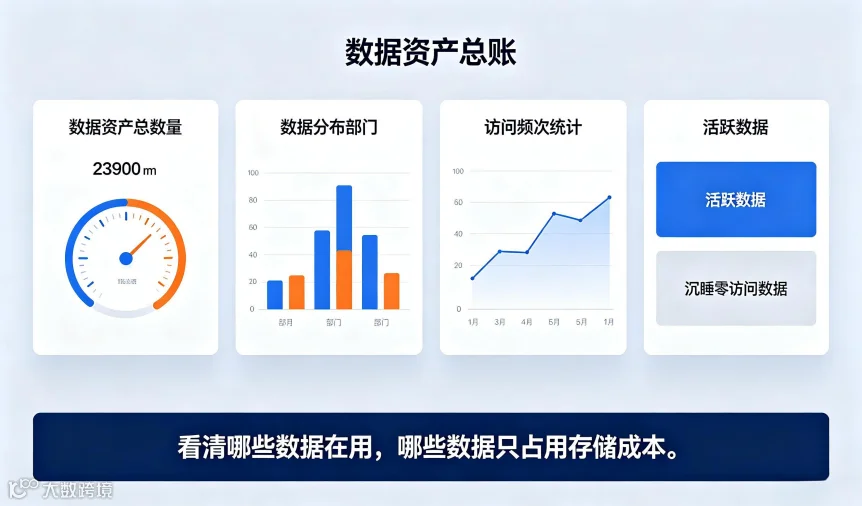
这一块,市场上已有数据资产可视化类工具在做类似的事。例如天枢数的数据资产大屏,它把后台那些只有技术能看懂的数据资源,变成一张业务也能看懂的总账本:有多少资产、分布在哪、被访问了多少次、访问占比是多少。哪些数据是活的,哪些只是占着位置,一屏就能看出来。
数据只有先被看见,后面才谈得上被管理、被复用、被分析。
看清楚之后,清理才有依据。连续半年零访问的表,可以先下线;访问量集中在某几张的,就是最该被保护和维护的核心资产。
清理的收益并不难算。存储成本降下来是一部分,更重要的是找东西的时间降下来了。一个分析员每天花在“找对表”上的那半小时,一年就是一百多个小时。
先数清楚,再决定扔什么。顺序反了,就会把还在用的东西删掉。
会计有折旧,有报废。一项资产用完了、到期了,要走流程核销,从账上消掉。
数据没有这个概念。
三年前建的表还在跑,两年前作废的制度文档还在库里,去年就已经改掉的口径还在被人引用。它们不会自己消失,只会一直待在那儿,等着某天被某个人翻出来再用一次。
在AI接入企业数据之后,这件事的性质变了。
以前旧文档过期了,顶多是人翻到旧版本,一看日期就知道不对。现在AI检索到三年前的口径,会用非常肯定的语气把它当成事实说出来。它说错的时候,语气和说对的时候一模一样。
补法不复杂,给数据加两个字段,生效时间和责任人。
有了生效时间,过期数据才能在回答时往后排;有了责任人,过期了才知道该问谁。

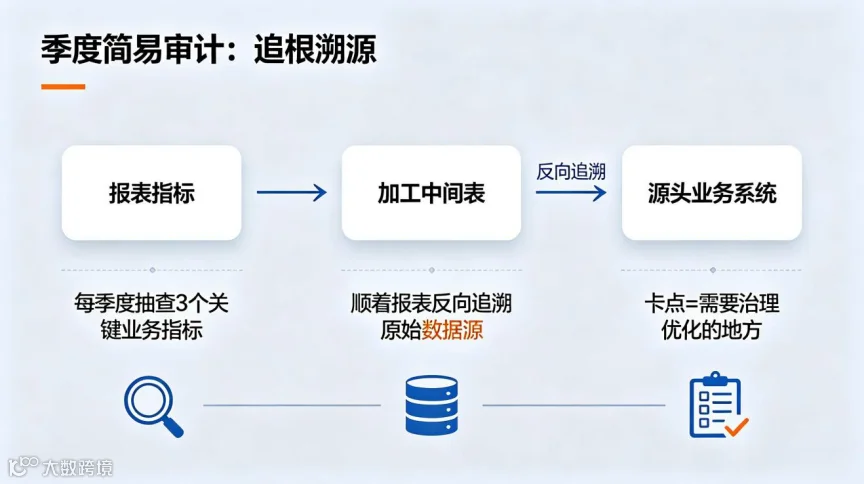
会计有内审,有外部审计,一年至少查一次,查的是账实是不是相符。
数据这边没有任何形式的检查。
一本账如果从来没人查,它的可信度就只能靠信任维持。而信任这种东西,撑得住三个月,撑不住三年。
可以做的动作很轻。每个季度挑三个影响决策的关键数字,从最终看到的那张报表开始,一路往回追,追到它最初产生的那个系统。
追得下去,说明这本账是通的。追不下去,卡在哪一层,哪一层就是下一季度要补的地方。
实际追的时候,卡点通常出现在三个地方。某一层的加工规则是写在某个人电脑里的一个表格文件;某个中间表的字段在两年前改过名,新旧两套叫法都还在用;某个数据是从外部拿来的,谁拿的、多久更新一次,没人说得清。
三个卡点没有一个是技术问题。都是当年没人记一笔留下的。
这些卡点,工具能补掉一部分。
天枢·数把指标的叫法固定在系统里,同一个"达成率"只有一条定义、一套计算规则,不用再靠口头解释;血缘关系把上面这条追查的路铺成一张图,一个数字往上能追到源表,往下能看到牵动哪些报表;再加上第五关说过的资产看板,和一条"数值跳出正常区间就先喊一声"的预警线,数据在被谁用、该更新而没更新,系统里都有记录。
这几样东西都不生产判断,它们只做一件事,把人定下来的规矩,变成系统每天自动跑一遍的动作。
不用全量检查,三个数就够。它的意义不在于查出了多少错,在于让"这本账是要被查的"这件事成立。
一年四次,每次半天。几乎没有企业做,但做过一次就知道,卡住的地方往往不是技术问题,是某一年某个人的一个临时决定。
回到开头那张“身份证”。
产权登记、数据入表、资产国标,这些制度解决的是同一类问题,数据走出企业之后,怎么被认可、被计价、被交易。
它们都很重要,但都发生在下游。
上游那件事要朴素得多,先有一本账。
科目、入账、盘点、核销、审计,五道关没有一道是新概念,全部来自一套运行了几百年的老办法。难的从来不是知道,是没人认领,也没人坚持。
发证之前,得先点一次名。盘点,就是给数据点名。
明天上班可以做一件事。挑一个业务域,问一句,这个域里正在产生哪些数据。
把答案写下来。
那就是台账的第一行。
—END—
内容看完有收获
点个“推荐”吧