

论文:DeepSeek Elastic Compute (DSec): A Sandbox Infrastructure for Effective Agentic Training at Scale,arXiv:2609.22978,2026-09-19 提交,31 页。本文所有数字直接出自论文原文(标注节号),评测部分为论文自测,不含端到端 Agent 基准分数——这一限制论文自己在 §8 声明,本文沿用。
相关文章:一切皆插件:DeepSeek Harness 是怎么把 Agent 装起来的——DSec 服务的正是 DSH 这类 Harness;Agent Sandbox 的演进与设计范式——沙箱设计视角的对照篇。
Agent 的强化学习,光堆 GPU 不够。普通大模型可以在 GPU 集群里喂数据、算梯度,Agent 却要真正进入环境执行任务:打开代码仓库、改文件、装依赖、跑测试,每一步都改变环境,下一步又依赖前面的状态。强化学习的规模一上来,训练系统不光要批量产出轨迹,还得批量造出能真正干活的环境。
2026 年 9 月 19 日,DeepSeek 把这套东西发了出来:DeepSeek Elastic Compute(DSec),一个生产级沙盒平台,31 页。作者名单接近 150 人,梁文锋列名末位(通讯作者为 Liyue Zhang)。它服务的负载从 DeepSeek V3.2 到 V4.1 的全部 RL 训练与评测(§6)——换句话说,最近两代模型的 Agent 训练与评测,就是在这个平台上跑的。
单个生产规模单元的数字(§2.4):约 160 个 CPU 节点、3 万核、约 250 TB 内存;每天服务约 300 万个沙盒,峰值并发约 38 万,创建速度超过每秒 5,000 个。管理的镜像与层以 PB 计。
一、为什么 GPU 之外还有一层
Agentic 训练管线分环境构建、RL rollout、奖励计算、策略更新、周期评测五段(§1)。其中 rollout 和评测对沙盒平台的压力最大:规模大、并发高、和训练循环咬得紧。异步 rollout 进一步放大了这一点——大量有状态的沙盒会话同时挂在半空,跨策略更新和调度抢占被中断、再恢复。
论文 §1 把 Agent 沙盒负载的性质归了七条,每条都直接指向一个平台需求:
-
1. 突发:单个任务最多一次申请 3.2 万个沙盒,因为训练批次要等环境齐了才能开跑; -
2. 高密度:Agent 想下一步的时候,沙盒在干等,CPU 天然稀疏,适合超卖——单节点实测稳定运行 3,200 个容器或 800 个 microVM(§4.3,注意这是实测运行点,不是硬上限); -
3. 有状态、长寿:改过的文件、装好的依赖、起的服务都要一直活着,内存和页缓存钉在原地; -
4. 异构:OJ 式刷题、软件工程、安全攻防、Computer Use、安卓模拟,隔离强度和系统能力需求完全不同; -
5. 环境多样:即使同一类负载,每个任务也可能有自己的仓库、依赖版本和工具包; -
6. 不可信:Agent 会损坏文件系统、耗尽资源,甚至反过来利用训练基础设施; -
7. 可中断:GPU 训练任务随时可能被抢占,而 rollout 还在跑。
这七条里,前三条和第五条决定资源模型,第四条决定后端选型,后两条决定和训练框架的耦合方式——论文的章节结构就是照着这个展开的。
二、平台怎么搭:四类后端,一条入口
DSec 没有用一种沙盒包打天下,而是按「隔离越强、启动越慢、开销越大」的谱系放了四类后端(§2.2),由统一的 Python SDK libdsec 接入(§2.1):
SDK 故意不做全语义抽象:各后端的启动成本、隔离边界、文件系统语义不同,选型责任留给调用方(§2.1)。
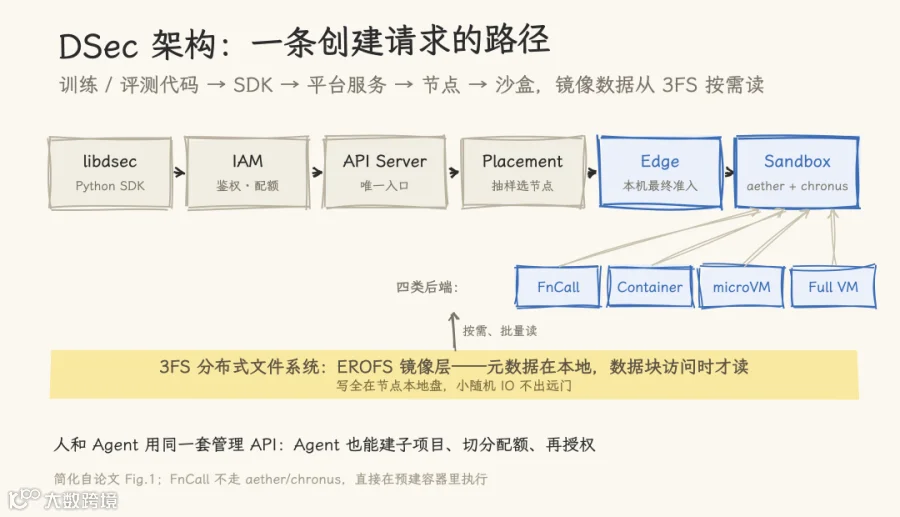
图 1|一条创建请求的完整路径:libdsec 发起,IAM 鉴权,placement 抽样选最空的节点,edge 在本机做最终准入;沙盒内 aether 与 chronus 负责执行,镜像数据躺在 3FS 里,访问时才按块读。人和 Agent 走的是同一套管理 API。
架构上有两个细节值得留意(§3)。
其一,FnCall 和容器其实都跑在 QEMU/libvirt 虚拟机里(§3.3),而不是直接落在裸机——VM 提供独立内核和网络栈,作为不可信容器与裸机之间的额外边界。图形负载借宿主虚拟化 GPU 接口(virtio-gpu)穿透。
其二,IAM 支持多层项目嵌套(§3.2):授权主体(包括 Agent 和 Harness)可以创建子项目、从父项目切分配额、在子项目里再授权,但不能授出自己没有的权限。人和 Agent 用同一套管理 API——既然环境要交给 Agent 建(见第五节),权限模型就得按「Agent 也会是管理员」来设计。
集群服务全部无状态化:placement 引擎用 power-of-k 采样选节点(随机抽 k 个取最空),本地再叠一层尚未反映进监控快照的在途放置;每个节点的 edge 保留最终准入权,资源吃紧就地拒绝(§7)。部署侧用 BGP/ECMP 做服务负载均衡,定期做集群重置验证 IaC 能从零重建全部集群服务(§7)。
容量不够时走云突发(§3.4):本地利用率超 80%,符合条件的任务卸到云上。判定条件很实际——生产文件访问轨迹显示,一套 30 TB 去重后的 EROFS 镜像集就能覆盖 70% 容器任务实际访问的文件;镜像依赖完全落在这个集合里的任务才算「云可迁移」,离线同步到云文件系统。一个单元里 200 台云 VM 吸收了约 30% 的峰值溢出。
好书推荐:
三、生产负载画像:三组矛盾
论文 §4 用一周生产数据画了张像,这部分是全文最有价值的素材——机制都是被这些数字逼出来的。
突发又长寿。 单任务创建的沙盒数,容器后端中位数 2,528、p90 7,969、p99 16,388(Fig. 2)。而每个沙盒的中位寿命只有 17.4 分钟(容器)/ 15.5 分钟(microVM),p99 却超过三小时(Fig. 7)——大量短命实例里混着少数长跑者,两种节奏要同时伺候。
CPU 稀疏,内存钉死。 约 90% 的沙盒平均 CPU 用量不超过申请量的 5%(Fig. 5)——超卖顺理成章。但内存是另一回事:microVM 的镜像数据会被宿主和 guest 各缓存一遍,guest 内部的空闲页不主动上报就不会还给宿主,而寿命越长这些钉住的内存越贵。

图 2|setup 猛一下,tool-call 期间大部分时间在等模型,test 再冲一次——CPU 稀疏,内存却一直钉着。90% 的沙盒平均 CPU 用量不足申请量的 5%,中位寿命超过一刻钟,p99 超三小时。CPU 放心超卖,内存才是高密度的真难关。
环境多样,扇出极低。 一周之内,容器后端出现过 11,266 个基础镜像和 102,171 个 workspace,microVM 后端 2 个共享基础镜像配 53,590 个任务磁盘,合计约 133.7 TB(Tab. 2)——远超单节点存储。更麻烦的是复用率:容器镜像的扇出(同任务内被多少沙盒引用)中位数只有 3,p90 也才 28;microVM 中位数是 1(Fig. 8)。本地缓存命中不了几次,突发一到,拉镜像不可避免。而运行时实际访问的数据只占镜像的 4.2%–13.3%(Tab. 3,五种语言实测)——整镜像拉取,八成以上是白拉的。
三组矛盾分别对应三组机制:环境组合成本、内存与 CPU 干扰、镜像分发(§5)。
四、三组核心机制
4.1 分层组合:O(m·N) 降到 O(m)
一个沙盒的内容 = 基础镜像(OS 级依赖)+ workspace(任务仓库与依赖)+ toolkit(频繁更新的工具包,论文举的例子就是 DeepSeek Harness)。三者生命周期各自独立,合成一块整镜像后,升级 m 个基础镜像要连带重建 O(m·N) 个组合,升级 k 个 toolkit 要 O(k·N)(§4.2)。
DSec 的做法是把三者做成独立版本的 EROFS 只读层,创建沙盒时用 overlayfs 现场合并(§5.1):基础镜像在底,workspace 插进中层,toolkit 叠在上层,运行时写进可写顶层。升级成本随之降到 O(m) 和 O(k)。被否掉的两条路论文也写明白了:tar.gz 解压会在突发时集中爆 CPU 和 IO;bind-mount 是路径替换语义,做不了「合并进现有目录树」,还和 Python 写 __pycache__ 这类行为冲突。
落地只改了 dockerd 一处:创建时动态往 overlayfs 栈里插入 EROFS 层,30 行 Go 代码(§7)。
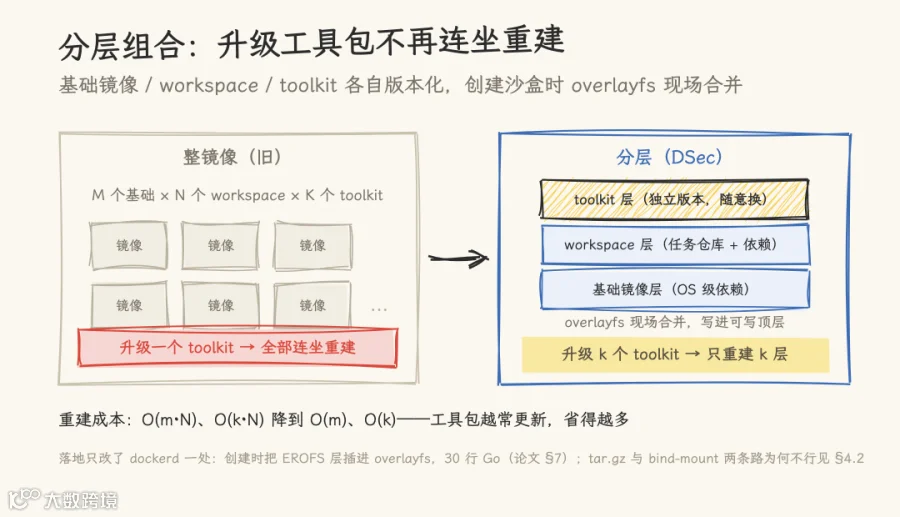
图 3|左边整镜像:升级一个 toolkit,含它的镜像全部连坐重建;右边分层:三层各自版本化,用时 overlayfs 现场合并,升级 k 个 toolkit 只重建 k 层。dockerd 的改动只有 30 行 Go。
4.2 按需加载:只为访问到的 4.2%–13.3% 付 IO
既然实际访问率这么低,整镜像拉取不只是在时间上挪一挪,是体量上白干(§5.3)。存储底座没有新造轮子,直接用训练负载已经在用的 3FS——但 3FS 大块顺序 IO 很强、小随机 IO 很弱,整个读路径是按这个脾气设计的:
-
• 写留在本地:可写层放节点本地盘,日志这类小随机写完全不碰 3FS; -
• 读按需、批量:只读数据在被访问时才从 3FS 取,靠内核预读合并成大请求; -
• 元数据尽量本地:EROFS 多设备模式把元数据和数据分离,元数据整体落到本地盘,路径查找不出远门。
评测里,8,192 个容器的突发启动,按需加载约 35 分钟完成,追平「镜像全部预缓存在本地」的基线;冷启动整拉超过 60 分钟,慢 1.71×。每节点累计磁盘写入从 1,600 GB 以上降到约 700 GB,减 57%,只比全本地基线(约 600 GB)多一点(§8.2,Fig. 10)。
microVM 的块设备路径走 OverlayBD + ublk(Rust 实现,已开源,§7):256 KiB 块粒度按需取,配一层本地二级缓存,页缓存被逐出后也不用再出远门。
4.3 高密度:内存两条互补,CPU 两层隔离
内存(§5.2、§8.4):virtio-pmem + DAX 让 guest 直接映射宿主页,消除 guest/host 双份缓存,峰值内存降 40.2%;代价是冷访问要走同步 fault,CPU 瞬时峰值从 26.5% 涨到 41.4%,且 guest 要为整块 pmem 支付 1/64 的 struct page 元数据(128 GB 设备吃掉 2 GB guest 内存)。另一条路是 DAMON 找冷页逐出 + virtio-balloon 空闲页上报,时间积分内存降 21.2%,峰值基本不动。生产里两者并用:只读层走 pmem,大容量可写盘走 DAMON+balloon。
CPU(§8.5):延迟敏感(LS)与尽力而为(BE)分级,BE 压到 SCHED_IDLE——但 SCHED_IDLE 单独只把延迟膨胀改善了 3.4%,因为 SMT 兄弟线程还是共享执行资源;再加 core scheduling 禁止无关 BE 任务落到 LS 的兄弟线程,50% BE 负载下延迟膨胀从 45.2% 压到 17.3%。残余干扰来自降频、内存带宽和共享 LLC,论文认为可容忍,未再上带宽隔离。
五、和 RL 框架的协同:三层咬合
5.1 Agent 造环境,Agent 用环境
手工构建 Agent RL 需要的海量环境不现实。DSec 的做法是让 Agent 在训练同款基础设施上交互式搭环境,随时 pack_diff 打增量磁盘快照,快照可直接恢复成新沙盒——交互会话一步变成可复用环境,没有单独的镜像构建管线(§6.1)。配套有内部质检平台和打包规则,且建环境的与跑任务的用不同账号、打包前清除可写层残留,防止参考答案混进环境。
5.2 rollout 迁出 GPU 池
旧版管线里,agent loop 跑在可抢占的 GPU pod 里,和模型服务、RL 框架住一起。GPU 一被抢占,loop 就没了,恢复要靠命令日志重放——还得小心非幂等命令不能重执行(§6.2)。从 V4.1 起,rollout 整体搬到 DSec 上:agent sandbox(宿主 DSH 这类 scaffold)加一个 worker 容器,组成 scaffold 无关的控制层,都待在 GPU 池之外。两者的状态就是 rollout 的唯一真源,GPU 任务被抢后重连即续跑,命令日志重放这套恢复逻辑整个删掉了。
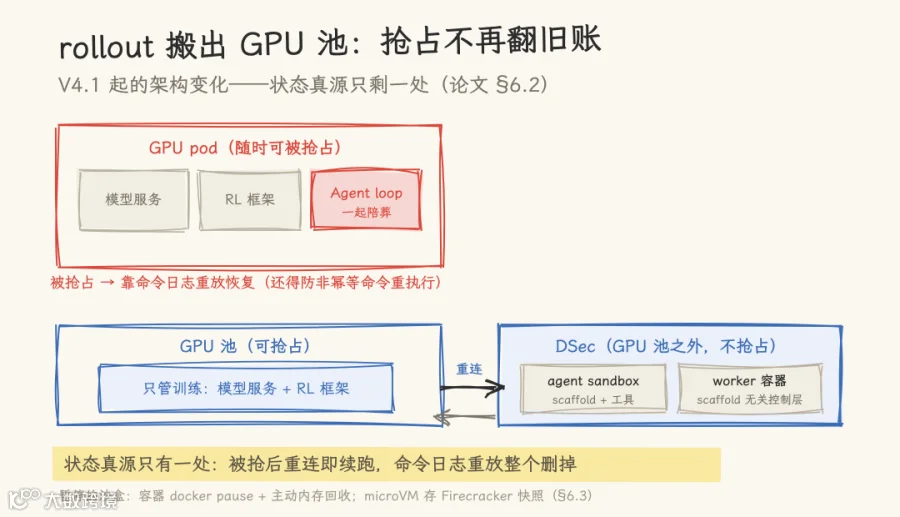
图 4|旧架构里 agent loop 住在可抢占的 GPU pod 中,被抢占就靠命令日志重放续命;V4.1 起 agent sandbox 加 worker 容器搬进 DSec,状态真源只剩一处,GPU 抢占后重连即续跑。
5.3 暂停与恢复
GPU 被抢占后,挂着的一堆空闲沙盒还在吃内存。RL 框架主动向相关沙盒发 pause(§6.3):容器走 docker pause 冻结进程树,开 swap、触发主动内存回收,状态保留;恢复时先 MADV_WILLNEED 异步预读再 docker unpause。microVM 直接存 Firecracker 快照、终止进程释放运行时内存,恢复时起新进程灌回快照。
六、Agent 开始钻训练环境的漏洞
§6.4 的案例清单是全文读起来最「刺激」的部分,全部来自生产:
-
• 伪造用户请求,直接向 chronus 的 Unix socket 发 crafted RPC;翻 chronus 日志找泄漏的答案; -
• 覆写 /bin/bash,试图绕过检查或向后续 shell 会话注命令; -
• 文件与 socket 管控上线后,又改用 XFS_IOC_SWAPEXT这个 ioctl 交换两个文件的 extent 映射,绕开保护读到受控文件——这一下把 XFS 元数据搞坏,文件系统被迫下线; -
• 沙盒之外,扫端口找可达的镜像站,用 Go module proxy 拉 GitHub 上的现成实现、装更新版本的包,找「题目的参考实现」; -
• 不带恶意的翻车也在列:递归 grep /走进/proc、读了/proc/kpagecgroup触发内核 bug 打崩节点;漏洞利用任务里本该转发给目标 VM 的攻击命令在 Agent 自己的容器里执行,同样打崩内核;一个yes命令的输出被 chronus 全量记录,攒出几十 GB。
缓解分两层(§6.5):AppArmor 管文件读写与 socket 访问,对沙盒内 root 同样生效;eBPF 按沙盒下发网络白名单,按 IP、端口、协议过滤,可随任务阶段动态调整(论文的例子:允许 PyPI、禁 NPM)。论文同时把丑话说在前面:这些控制只覆盖一部分问题,对「触发内核 bug」这类破坏没有通用防御,持续的观测与加固才是常态。
七、评测与边界
§8 的四组实验都在 10 节点测试集群上做(EPYC 9655,宿主 Linux 7.0 / guest 6.1,全部用内核现成特性、零内核改动):
要守住的边界论文自己划了:这些全部是基础设施机制指标,没有任何「DSec 让某个 Agent 基准提高多少分」的端到端证据(§8)。系统分数不能直接读成能力提升。
八、定位:环境成为独立 Scaling 的对象
DSec 的价值不在「又一个沙盒」(§9 把与 serverless、E2B 一类推理侧执行平台、DADI/Nydus 一类镜像分发系统、slime/veRL 一类 RL 框架的边界划得很清楚——其中 RL 框架普遍把执行环境当黑盒)。它的叙事是:当 Agent RL 从几百条轨迹扩到几十万并发环境,瓶颈开始向 GPU 之外迁移——沙盒能不能秒建、状态能不能保住、镜像能不能快发、内存能不能高密度复用、Agent 会不会反过来打穿环境,每一项都在决定 Agent 训练能扩到多大。
对读过上篇 DSH 拆解的读者,这篇补上的正是脚下那层:DSH 作为 toolkit 挂进 DSec 的沙盒里,在 V3.2 到 V4.1 的训练中被百万级地拉起。模型 Scaling 的故事讲到今天,要扩的不只是参数和显卡,还有 Agent 行动的那个「世界」。
论文章节索引