|
|
摘要:四大核心发现
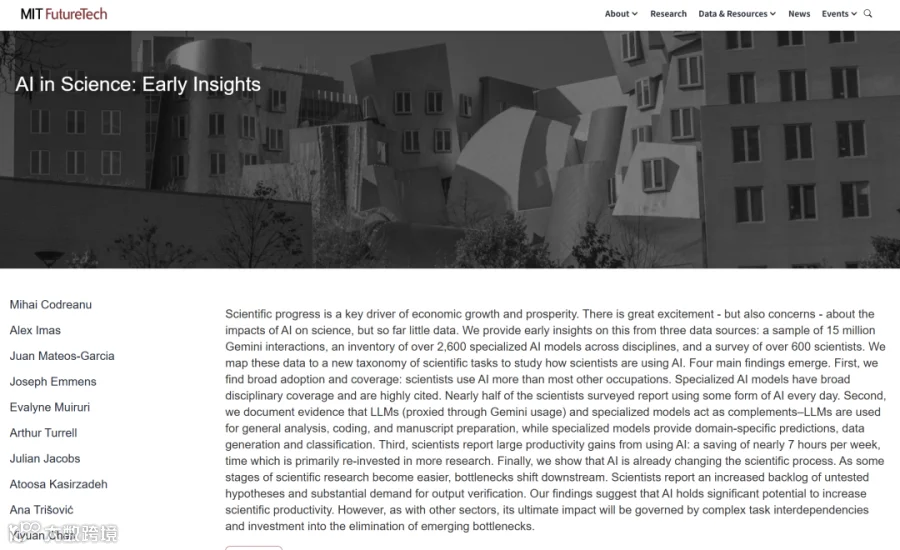
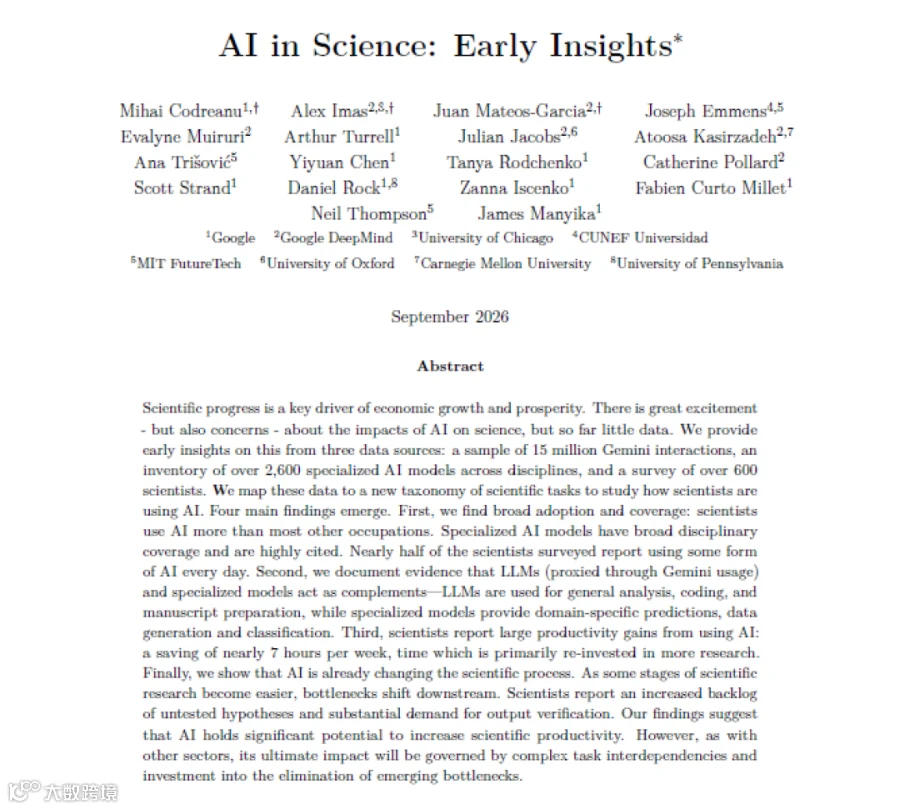
论文基于三类新数据源:
1500万条 Gemini 交互样本;
2600多个跨学科科学专用 AI 模型清单;
600多名科学家调查。
并将它们映射到 MIT FutureTech 的科学任务分类法,形成任务层面的分析。
四个主要发现:
采用广泛、覆盖广:科学家使用 AI 的比例高于多数职业;专用 AI 模型覆盖多个学科且被高度引用;近一半受访科学家每天使用某种 AI。
LLM 与专用模型互补:LLM 主要用于通用分析、编码、论文准备;专用模型用于领域预测、数据生成、分类和模拟。二者任务重叠有限。
生产率收益显著:科学家报告平均每周节省近 7 小时,且主要再投资于研究。
科研流程正在改变:部分环节变容易后,瓶颈向下游转移,出现未测试假说积压、验证需求大增等问题。
总体判断:AI 有潜力显著提高科学生产率,但最终影响取决于复杂的任务相互依赖,以及能否投资消除新出现的瓶颈。
1. 引言:乐观与担忧并存,但缺乏实证
科学发现是长期经济增长的核心动力,但近年出现“研究生产率下降”“想法越来越难找”的担忧。
AI 被视为可能扭转趋势的“发明方法的发明”(IMI),如 AlphaFold 已被视为诺奖级突破,通用 LLM 也在快速扩散。
但担忧同样存在:AI 生成内容、幻觉、“理解错觉”会冲击同行评审和验证;模型可能引导研究者走向增量、安全课题;算力和资本要求可能扩大富实验室与资源不足机构之间的差距;还可能加速低质量研究。
既有研究多依赖论文、引用、专利等滞后数据;前沿 AI 实验室虽有实时使用遥测,但多聚焦劳动力市场,较少聚焦科学。
本文用实时日志、专用模型清单和科学家调查,首次系统描绘 AI 在科学中的采用、分工与影响。
2. 数据与测量
2.1 科学定义与分类工具
采用广义科学定义:学术、产业、非营利、政府中的研究活动;包括应用、计算和理论研究。
使用 OCTO 分类引擎,将非结构化文本映射到 OpenAlex 学科分类和 MIT FutureTech 科学任务分类法。
MIT FutureTech 任务分类法基于约 380 万条科研招聘广告,包含 12 个一级领域、114 个二级领域、2433 个三级任务组,覆盖 217 个科学子领域。
2.2 三类数据源
Gemini 交互日志(Google ATLAS 1.0):约 1500 万条匿名交互,来自 Gemini App、AI Mode 和 API。经三阶段过滤:排除非工作交互;限制在六类研究密集型 SOC 职业;再用科学分类器识别科研工作流。最终得到约 36 万条科学交互。
科学专用 AI 模型清单:共 2690 个 2012 年后发布、且有代码仓库的模型。覆盖 26 个 OpenAlex 领域、83% 子领域。提取出 4475 个任务。
科学家调查:2026 年 7 月 27 日至 8 月 11 日,由 More in Common 在线执行,调查 637 名 美英活跃研究者,涵盖物理、生命、健康、社会科学,以及学术与产业界。样本为非概率筛选样本,未加权。
3. LLM 在科学中的使用
3.1 采用程度:科学家是 AI 高使用群体
六类研究密集型职业的 Gemini 交互量约为其美国就业份额的 1.8 倍。
核心科学职业 SOC 19(生命、物理、社会科学)使用 AI 的可能性约为就业基线的 2.7 倍。
科学交互比普通工作交互更复杂:多模态高约 7%,token 使用高约 19%,对话轮次高约 11%,领域专长得分高约 26%。
在 217 个最细科学子领域中,LLM 使用覆盖 195 个。
3.2 学科分布
物理科学(含计算机科学)占科学 LLM 交互的 55.3%,社会科学 21.4%,健康科学 14.1%,生命科学 9.2%。
字段层面:计算机科学约 28.3%,工程 14.1%,政治学/社会学/人类学 11.3%,医学 9.6%,农业与生物科学 5.4%。
按 OpenAlex 作者数归一化后,某领域研究者份额每增加 1 个百分点,其科学 Gemini 交互份额约增加 0.7 个百分点,解释力接近 30%。物理和社会科学相对过度代表,生命和健康科学相对不足。
3.3 任务分布
LLM 被用于整个科研流程,但集中于:
“分析和建模定量研究数据”:约 42.5%;
“传播研究成果与利益相关者信息”:14.0%;
“开发产品、原型和工艺技术”:11.4%;
“开展实验和样品处理操作”:9.8%;
教学培训 6.4%,项目管理 3.9%,概念化研究 3.0%,临床研究协调 2.8% 等。
不同学科任务异质性明显:计算机科学更多用于软件排错和定量分析;健康科学更多用于临床研究协调、质量合规;生命科学更多用于实验和样品处理;社会科学更多用于数据收集、教学和项目管理。
3.4 地理分布
一国研究者份额每增加 1 个百分点,其科学 LLM 交互份额约增加 0.9 个百分点,可解释约四分之三的跨国方差。
4. 科学专用 AI 模型
4.1 领域覆盖
专用模型在物理科学/计算机科学中占比最高,为 54.1%;生命科学 20.4%,健康科学 15.5%,社会科学 10.2%。
与 LLM 使用相比,专用模型在生命和健康科学中占比更高:二者合计约 36%,而 LLM 使用中约 23%。
Top 字段:计算机科学 31.8%,医学 13.3%,生物化学/遗传学/分子生物学 10.1%,工程 7.7%,地球与行星科学 4.4% 等。
4.2 任务特征
专用模型主要用于 预测、生成、分类,以及分割、检测、分析、估计、求解等。
映射到 MIT 任务分类法后:
“分析和建模定量研究数据”占 68.4%;
“开发产品、原型和工艺技术” 10.8%;
“开发与排错研究测定和软件” 5.2%;
实验操作 4.9%,沟通 4.5%,数据收集 2.5%,概念化 1.1%。
专用模型覆盖 MIT 三级任务的 17.6%;排除运营和教学任务后,覆盖 24.3%,即约四分之一实质性科研任务已有 AI 能力覆盖。但论文强调,这不等同于 AI 在这些任务上有效。
4.3 与 LLM 的分工:互补而非替代
在最高层任务分类上,LLM 与专用模型都集中在“数据分析和建模”,看似相似。
但任务越细化,重叠越低:log-log 弹性从一级任务的约 0.6,降到二级的 0.5,再到三级任务的 0.2;若纳入至少一方有正份额的任务,三级弹性甚至略为负。
结论:LLM 更像通用工具,用于写作、编码、文献综述、统计分析和操作支持;专用模型更像领域资本,用于预测疾病结果、设计分子构造、运行复杂模拟。二者当前更多是互补关系。
4.4 引用与知识流动
专用模型被高度引用:2012 年以来累计超过 130 万次引用,2020 年以来近 50 万次;近一半模型论文在其领域内进入前 1% 引用,83% 进入前 10%。
超过四分之一引用链接跨越学科边界。
健康科学模型近一半引用来自物理科学(主要是计算机科学),10% 来自生命科学;社会科学模型超过七成引用流向物理科学;物理科学模型较封闭,85% 引用来自物理科学内部。
可能解释包括:领域技术被计算机科学吸收、基础与应用领域知识扩散、领域数据用于基准测试等。
4.5 地理集中
专用模型开发高度集中:前 10 个国家/地区占 84%,主要是美国、中国、英国、欧盟、韩国、加拿大。
中国约占专用模型引用量的 40%。
许多中低收入国家开发能力弱,但引用较活跃,说明开放模型可以在缺乏开发能力的地区扩散使用。
5. 科学家调查:采用、时间、瓶颈与影响
5.1 使用频率与时间分配
47% 受访科学家每天使用某种 AI,31% 每周使用。
使用 AI 的时间中,约 70% 用于通用 LLM:其中通用聊天与文档 LLM 占 41%,编码代理和代码助手占其余部分;专用模型约占 30%。
科学家平均每周时间分配:数据分析和解释约 7 小时;数据收集和实验近 8 小时;写作与传播约 5 小时;方法与设计约 5 小时;知识获取约 5 小时;概念化及基金/行政等运营任务合计约 9 小时。
5.2 生产率收益
近四分之三受访者报告 AI 净节省时间,仅 6% 报告净损失时间。
平均每周节省 6.9 小时。
节省时间再投资于:增加研究量和产出约 30%;物理实验和数据收集约 21%;攻克更难、更雄心问题约 19%;改善工作生活平衡/减少工时约 18%;教学、指导、行政约 12%。
过去三年,84% 科学家报告其实验室或专业产出净增加,47% 报告产出增加 10% 以上。
未来三年,约 90% 预期产出增加;预期增长 25% 以上 的比例从约 7% 升至 18%。
5.3 瓶颈、验证与科研问题选择
当前最大瓶颈:物理实验和数据收集 24%(物理科学与工程中达 30%),数据分析和解释约 21%,写作与传播约 14%。
过去两年,44% 受访者表示主要瓶颈向下游转移,14% 表示向上游转移,42% 表示未变。
41% 科学家报告未测试假说积压增加,25% 报告减少。AI 加快了假说生成和计算预测,但实验验证能力跟不上。
在节省时间的人中,89% 会用超过十分之一的节省时间检查 AI 输出,46% 会用超过四分之一的时间验证、调试或事实核查 AI 输出。生命科学中“验证税”尤其高。
对科研问题的影响:
68% 认为 AI 增加了跨学科洞察获取;
67% 认为 AI 提高了所研究问题的雄心;
65% 认为研究议程广度增加;
40% 认为低质量论文增加,35% 认为减少;
45% 认为每篇论文所需努力增加,31% 认为减少;
49% 表示 AI 促使他们转向更安全、增量的课题,28% 表示转向更高风险课题。
论文将此称为可能的“街灯效应”:AI 更容易降低数据丰富、可基准测试、可计算问题的成本,而高风险、数据稀缺、验证昂贵的问题可能被挤出。
6. 讨论与下一步
AI 在科学中的采用不是简单的劳动力替代或自动发现爆炸,而是更复杂的图景。
科学家 AI 使用过度代表,但采用与各国科研人力规模大致成比例;专用模型开发集中在少数发达经济体,可能加剧全球科研能力差距。
LLM 与专用模型存在分工:专用模型生成合成数据、预测分子性质、执行模拟;通用 LLM 承担编码、文献综合、写作和运营。
AI 带来真实的时间节省,但瓶颈向下游转移,任务捆绑和组织互补性限制了宏观发现率的提升。
高“验证税”说明 AI 输出并非即插即用;科学中正确性至关重要,验证和人类判断的边际价值上升。
未来可能形态:LLM 作为 orchestrator,规划实验、调用 AlphaFold 或材料模型等专用模型、交叉检查输出,科学家负责选择问题、设定证据标准、决定什么值得做物理实验。
政策含义:需要投资物理实验和验证能力、验证工具、数据与基准,并缓解全球科研能力差距。
7. 局限
论文明确列出多项限制:
Gemini 日志仅来自 Google ATLAS,排除企业数据;Gemini 用户可能不代表其他模型用户,健康等受监管领域可能更多使用企业账户或专用方案。
专用模型清单偏向“知名”、易检索、有代码仓库的模型,遗漏定制模型、商业模型和私有模型;引用分析存在滞后。
科学家调查可能存在选择偏差,热衷 AI 的科学家更可能回应,可能高估采用率和节省时间。
MIT 任务分类法源自招聘广告,科学与更广 STEM 经济边界存在误分类。
分类流程可能误判、单标签映射,忽略一个模型对应多任务、一次对话包含多任务等情况。
论文是 2026 年早中期的快照,LLM 与专用模型的分工可能变化。
结果主要是关联而非因果,未来需因果识别。
总体认识
这篇论文的核心判断是:AI 已经广泛进入科研工作流,并带来显著的时间节省和任务重组,但目前更像“局部加速器”而非“自动发现机器”。 通用 LLM 与专用模型形成互补分工;瓶颈正从分析、编码、写作向下游实验、临床验证和数据收集转移;验证成本、未测试假说积压和向增量课题倾斜,是 AI 提升科学生产率的主要制约。最终影响不取决于单一模型能力,而取决于任务依赖、组织互补性、验证能力和对下游瓶颈的投资。
来源:https://futuretech.mit.edu(英文)
AI编译 / 智强咨询 编辑(中文)