随着智能体应用的普及,Agentic RL成为提升大模型复杂任务能力的关键技术。针对传统RL框架在Agentic RL任务中存在的智能体接入复杂、长程任务性能受限、沙箱可用性不足等难题,昇腾联合verl社区孵化Uni-Agent框架。Uni-Agent基于架构解耦和组件化设计,支持智能体框架零修改接入Agentic RL后训练,通过智能体感知调度与高可用沙箱技术,可提升昇腾AI基础软硬件平台SWE-Bench代码智能体RL训练性能20%+。
2025年以来,OpenCode、OpenClaw等AI智能体在软件编程、个人办公等应用领域取得显著进展。随着智能体系统及其任务复杂度的跃升,传统的大模型后训练逐渐触及能力边界,开始向智能体强化学习(Agentic RL)演进:将大模型置于智能体框架中,使其与操作系统、浏览器、模拟沙箱等外部环境持续交互,通过采集环境状态变化与奖励信号,利用强化学习算法优化大模型的长程规划与任务决策能力。
Agentic RL通过海量试错自动合成高质量轨迹数据,可实现大模型与智能体框架的深度磨合,被认为是实现RSI (Recursive Self-Improvement)的关键路径之一。然而,Agentic RL工程落地面临三大挑战:
智能体接入与维护复杂:以verl为例,开发者需在AgentLoop接口中实现智能体的交互循环与工具调用,以及轨迹数据的采集处理,随后将轨迹数据注入RL工作流。这种“白盒”接入模式灵活性较强,但却导致智能体框架与RL框架深度耦合,定制适配与持续维护成本高昂。
长程任务训练瓶颈:长程Agentic RL训练中,智能体轨迹数据的上下文持续累积,模型训练的序列长度可达数万乃至百万Token,且长度分布离散,对数据采样(Rollout)系统造成了极大的性能压力。传统的Rollout调度策略,易引发前缀缓存(Prefix Cache)重复计算、推理实例负载不均等问题,拉低RL系统吞吐性能。
沙箱可用性与性能不足:Agentic RL训练需模拟软件开发、GUI操作等行为,对安全隔离等级诉求多样,且沙箱实例具有“即用即销毁”的短生命周期特征。沙箱交互的高时延或沙箱实例的失败重启,会阻塞RL计算流水线,严重浪费算力资源。因此,Agentic RL迫切需要配套高并发、高可用的沙箱系统。

针对上述挑战,昇腾联合verl社区孵化开源了Uni-Agent框架。Uni-Agent主要面向大规模长程Agentic RL训练,通过架构解耦实现“模型训练”与“智能体运行”的流程分离。区别于“白盒”接入模式,Uni-Agent 引入了新的组件抽象,支撑主流智能体框架“黑盒”接入verl:
AgentFramework(任务中枢):接收和分发智能体任务,整合处理轨迹数据并注入verl RL训练流程。
AgentRunner(智能体驱动器):控制智能体初始化、执行、暂停,驱动其在本地或沙箱环境执行任务;
Gateway(透明网关):桥接Rollout系统与智能体,向上为智能体提供OpenAI/Anthropic 等标准协议API,向下调用Rollout系统处理模型服务请求,并采集Token级轨迹数据;
Load Balancer(负载调度器):综合考量推理实例的前缀缓存驻留情况、算力/显存负载,为模型服务请求分配合适的推理实例。
Uni-Agent通过标准协议API连接智能体框架与RL框架,确保二者可以独立维护演进:智能体开发者无需了解RL训练流程,RL开发者也无需了解智能体Harness原理。针对 Agentic RL 实际痛点,Uni-Agent 提供了轨迹采集、算力调度和环境基建等关键技术支撑。
Uni-Agent接入新的智能体仅需在AgentRunner中配置映射启动命令和环境变量,将智能体视为普通进程,控制其在本地或沙箱环境内运行。
Gateway在Agentic RL训练中拦截智能体提交的模型服务请求,自动采集和拼装轨迹数据,实现从“推理语义”向“训练语义”转换。为解决轨迹数据采集的工程隐患,Gateway提供了以下特性:
Token-in-Token-out:传统轨迹数据采集模式将Rollout系统输出的Token解码存储为文本,在训练前重新分词(Tokenize)为Token。由于BPE等分词算法的非单射特性,重新分词极易生成与原始输出不同的Token ID,导致训练不稳定。Gateway采用Token-in-Token-out模式和增量编码技术,直接拼装Rollout系统输入与输出的 Token,避免了重新分词,确保Token序列前后一致。
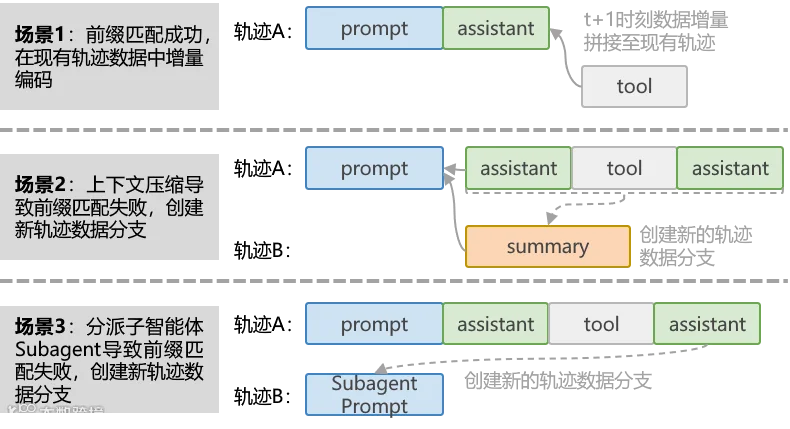
多链机制:智能体截断/压缩对话历史、分派子智能体(Subagent)执行子任务等场景下,采用单条轨迹累积记录,无法反映该场景的上下文跳跃情况。Gateway 支持基于前缀匹配的多链轨迹,检测到上下文跳跃时自动分裂新轨迹数据分支,灵活适配智能体多链并发任务。
信息回滚:智能体沙箱交互过程中,常因工具报错等问题重试执行,或调整工具参数。其将引发轨迹数据快速分裂,并导致废弃的交互步骤混入训练数据。Gateway 支持可控的信息回滚,当智能体修改最后一轮交互步骤时,允许轨迹回退至该步骤生成前,以过滤废弃/低质量数据,避免干扰奖励计算和增大通信计算压力。
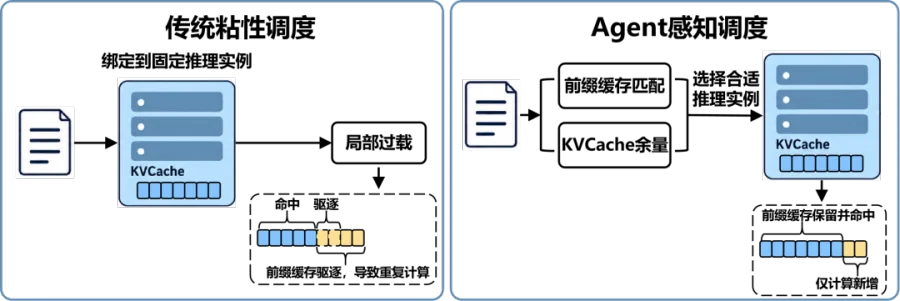
随着智能体交互轮次增加,持续累积膨胀且长短不一的上下文使得Rollout成为Agentic RL性能瓶颈。Uni-Agent将前缀缓存、显存负载等信息引入调度策略,围绕“减冗余,降空转”两个方向提升Rollout系统吞吐。
提高前缀缓存命中率,减少冗余计算:verl默认的粘性调度(Sticky-Session)将同一轨迹数据分发至固定的推理实例处理,而未确认前缀缓存是否存在。这可能导致长程任务汇集至同一推理实例,引发局部过载和前缀缓存驱逐。Uni-Agent在线跟踪推理实例状态,显存余量充足时,优先选择持有可复用前缀缓存的推理实例;显存余量低于阈值时,解除与固定推理实例的绑定,从而兼顾前缀缓存复用与显存负载均衡,减少前缀缓存重复计算。
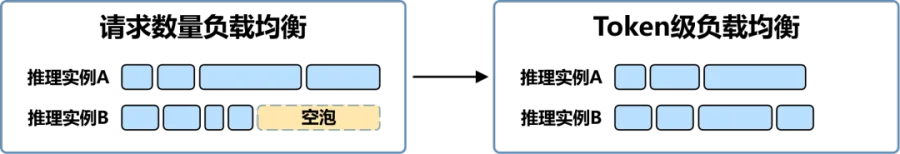
Token级负载均衡,降低硬件空转:已有的负载均衡策略根据模型服务请求数量衡量负载,可能导致少数长上下文请求集中分发至部分推理实例,而其它推理实例空闲等待,最终拉长整个批次的Rollout耗时。Uni-Agent定义了Token级显存负载,结合前缀缓存命中情况和KVCache余量,评估新请求的计算与显存需求,分配合适的推理实例,从而缩小实例间的计算量差异,缓解长尾等待和硬件空转。
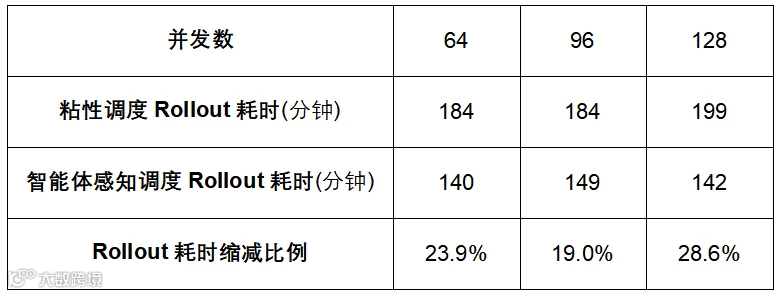
Uni-Agent平衡了前缀缓存复用与负载均衡,在SWE-Bench数据集32k上下文的高负载测试中,显著提升了Rollout吞吐:
Agentic RL依赖基于沙箱的海量试错,为兼顾高并发吞吐、安全隔离与易用性,Uni-Agent 深度适配了蚂蚁与华为联合开源的AKernel以及openYuanrong高性能沙箱基座,提供了以下核心能力:
单机级的命令式开发:提供命令式 SDK,开发者能够以类似操作单机的方式直观编程,控制沙箱内的计算、网络及存储资源;并提供开箱即用的可观测能力,让复杂的智能体多步执行轨迹有迹可循。
安全隔离与弹性并发:为隔离执行Agentic RL训练中模型生成的不可信代码,支持多种强虚拟化技术,为各智能体分配独立内核运行环境以防逃逸。配合分布式负载感知与智能抢占调度机制,支持1分钟内弹性并发拉起上万个沙箱实例。
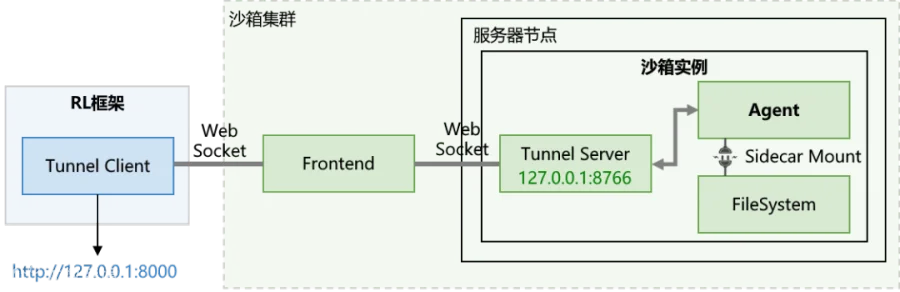
反向隧道(Reverse Tunnel)通信与挂载:针对私有训练集群无法对外暴露端口的场景,引入反向隧道技术,沙箱通过网关安全回连客户端并穿透网络访问外部接口。同时,支持高性能只读挂载,可将智能体、工具链 Sidecar 镜像映射至沙箱指定路径,实现基础沙箱与定制工具镜像动态组合。
应用案例1——
verl×Uni-Agent 增训 Mini-SWE-Agent
本案例基于verl与Uni-Agent框架,搭建了通用的Agentic RL训练系统,实现Mini-SWE-Agent的“黑盒”接入和面向SWE任务的基座模型增训。

本案例采用独立Sidecar工具镜像封装智能体运行环境并自动挂载到官方数据集镜像环境中。代码执行与奖励计算均在隔离沙箱中完成,通过阻止模型窥探git历史提交等手段降低Reward Hacking风险。同时,训练流水线搭载精细化样本管控机制,自动剔除全0/1等无区分度的无效样本,结合损失掩码与信息回滚策略,仅保留有效补丁样本参与迭代,有效提升模型收敛效率。完整的部署操作流程可参考相关文档:
https://github.com/verl-project/uni-agent/blob/release/v0.1.0/examples/mini_swe_agent/README.md。
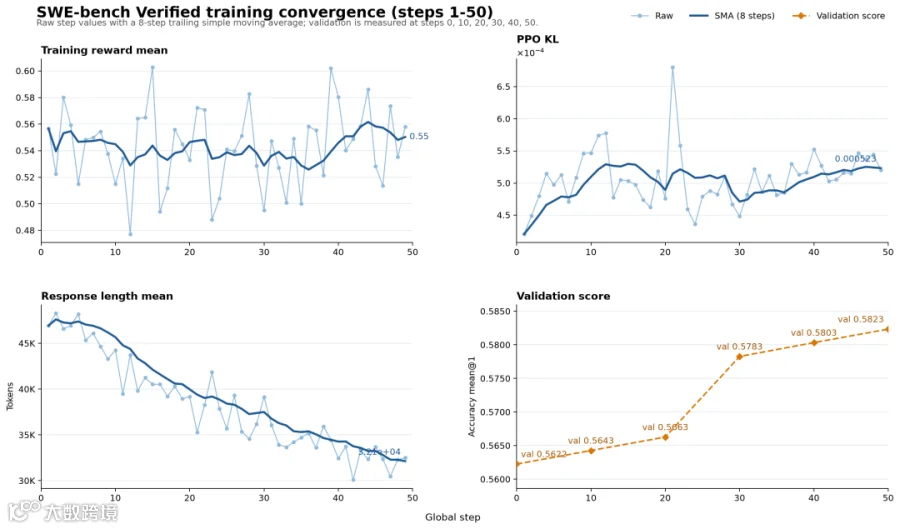
本案例基于Atlas 800T A2集群,使用GRPO算法和SWE-reBench数据集,在Separate Async模式下增训Mini-SWE-Agent的Qwen3.5-9B基座模型,在SWE-Bench-Verified数据集上进行验证。实验约束Agent最大交互轮次100轮,轨迹长度上限128K,最终训练和评测结果如下:
训推一致性:对训练与推理采样的差异进行评估,实测皮尔森相关系数(Pearson Correlation)达 0.999,策略概率差异均值仅为 0.0037,充分验证该方案在训练与推理阶段的行为高度对齐,保障了训练的稳定性。
模型收敛表现:Training Reward在正常采样区间波动,响应平均长度逐步下降并趋于平稳,说明模型逐步学会精简输出,不再生成冗余长文本,是策略优化的典型正向信号。验证集Validation Score持续提升至 0.5823,证明了经过长程训练,模型修复复杂代码的能力得到了实质性的持续提升。
应用案例2——
verl×Uni-Agent训练
Ascend Triton算子生成 Agent
本案例基于verl与Uni-Agent框架,面向Ascend Triton算子生成Agent,搭建了从轨迹采样、受控验证到算子优化的Agentic RL链路:Agent在独立沙箱中读取任务、编写并持续迭代Triton代码,通过NPU上的正确性验证和性能测试获得反馈,并将多轮交互轨迹用于模型后训练。
本案例选取Qwen3.6-35B-A3B基座模型和GRPO算法,通过综合评估AST检查、编译状态、用例通过率与加速比计算奖励。训练过程中记录最佳实现并回溯其对应轨迹前缀,同时通过受保护的统一验证入口、测试基线保护和NPU互斥调度等机制,提升奖励与轨迹数据的可靠性。本案例的部署操作流程可参考相关文档:
https://github.com/verl-project/uni-agent/blob/release/v0.1.0/examples/claude_code_kernel_task/README.md。

轨迹分布:随着训练推进,Assistant 交互轮次明显增加,但单轨迹消耗的 Token 总量显著下降,Tool Result 占比同步提升,交互逐渐呈现“多轮、短生成、强工具反馈”的特征。与此同时,以 max_turns 结束的轨迹由 6 条增至 28 条,说明固定轮数预算正逐渐成为交互约束,可结合任务难度采用更灵活的轮数和时间预算。
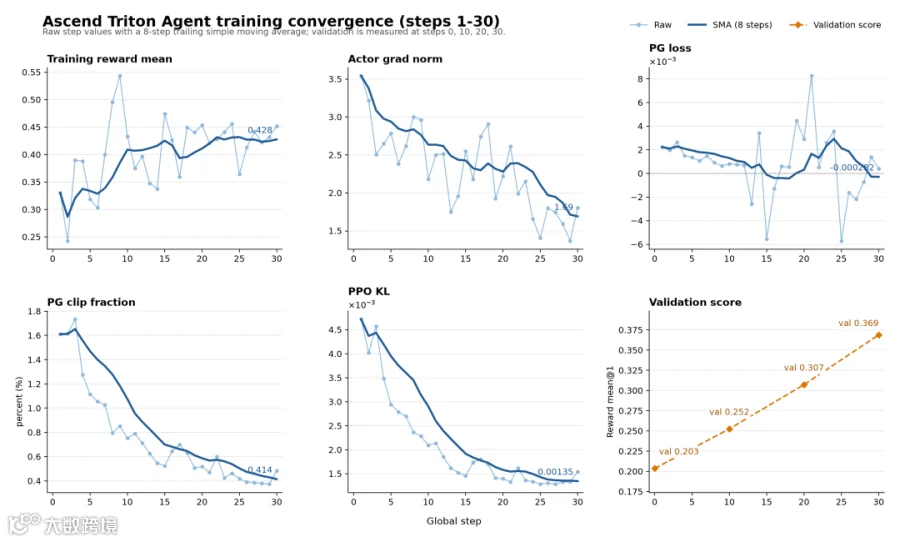
模型收敛表现:经历30个训练step,Training Reward由0.330提升至0.452,Validation Score由0.203提升至0.369;同时梯度范数、PG clipping ratio和 PPO KL整体下降,表明算子生成策略持续改善、训练逐步趋稳。
上述实验结果表明,Ascend Triton算子生成Agent能够从编译、验证与性能反馈构成的多轮交互轨迹中学习更有效的算子生成与修复策略,为Agentic RL在算子生成场景中的落地提供了可借鉴的技术实践。
Agentic RL是提升大模型复杂任务处理能力并迈向智能体RSI的关键路径。Uni-Agent通过架构解耦、智能体感知调度、高可用沙箱等核心设计,有效化解了智能体接入复杂、长程任务性能受限、沙箱可用性不足等应用难题,为构建高效的大规模 Agentic RL 系统提供了软件基础。
诚邀广大大模型和智能体开发者下载试用,并在社区中提出宝贵意见或参与联合共建,共同推动Agentic RL技术的发展演进。
🔗 GitHub 仓库:
https://github.com/verl-project/uni-agent
📖 文档与教程:
https://uni-agent.readthedocs.io/en/latest/
🖂 飞书交流群
(会话ID oc_a9ecca09aaf6e02d01097c2245ffd734)