

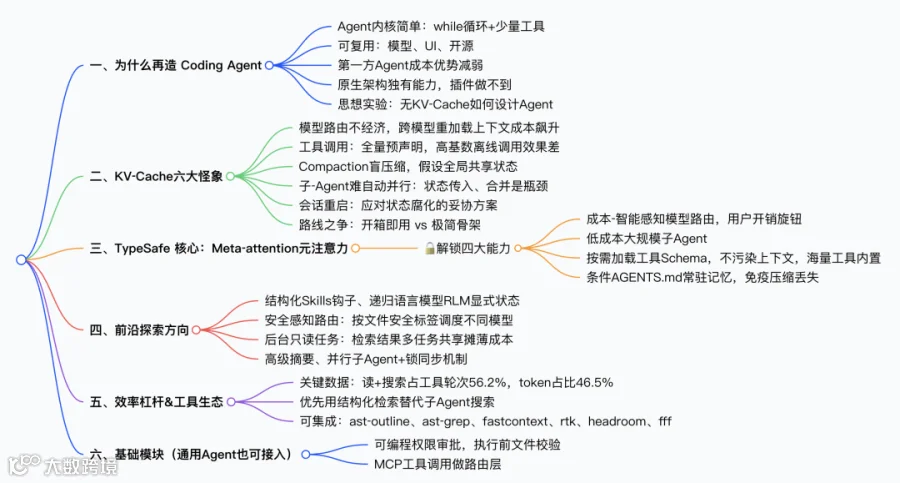
编者摘要:Diogo(TypeSafe CEO)认为现有代码 Agent 大多只是while 循环 + 工具,创新集中在状态、上下文、成本管控等非 Agent 内核;大模型、UI、开源均可复用,大厂第一方 Agent 成本优势正在衰减,部分能力必须原生架构实现。核心思想实验:假如没有 KV‑Cache,如何设计 coding agent,以此区分真正设计与 KV 缓存催生的补丁。
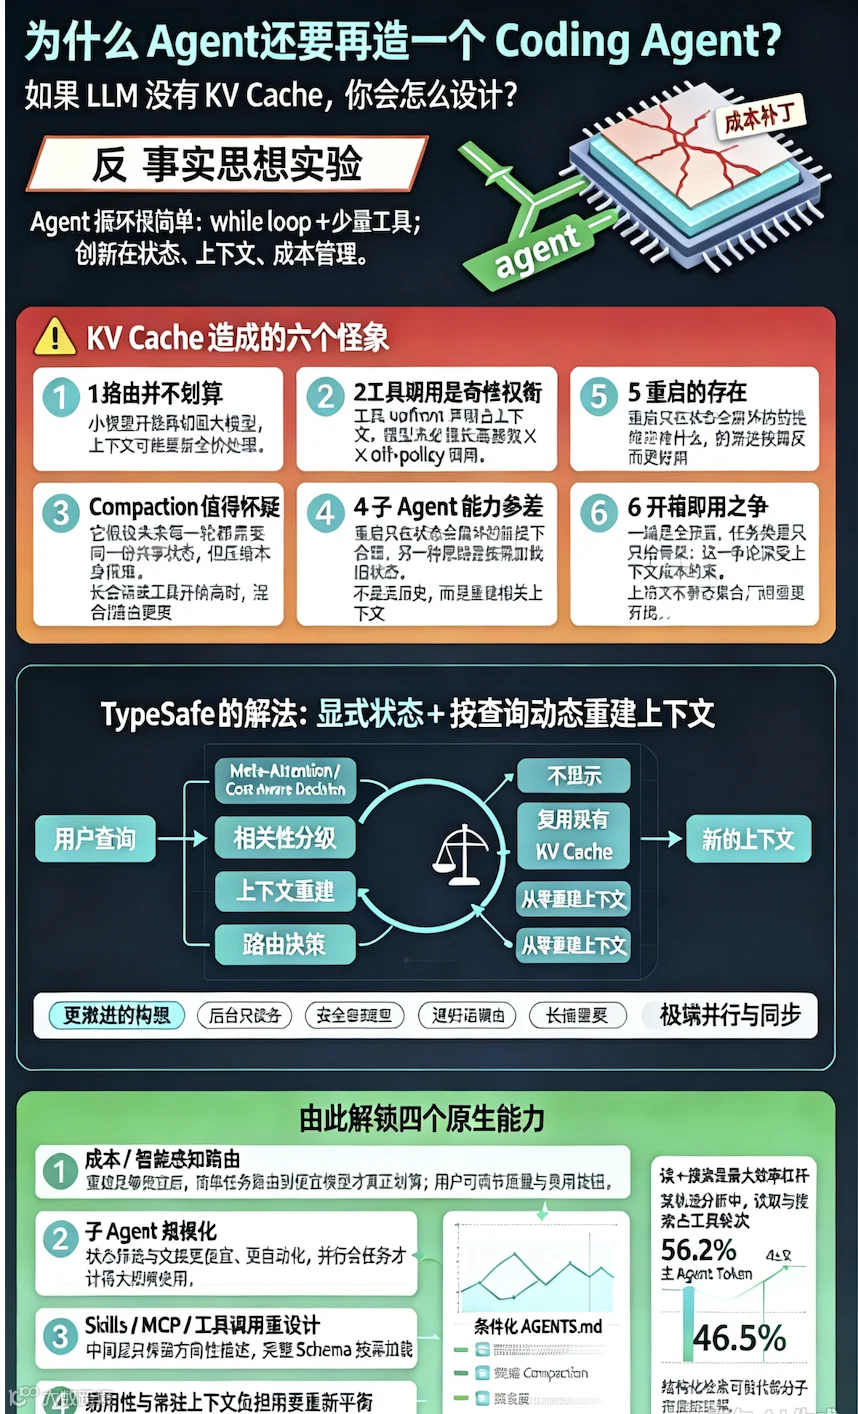
KV‑Cache 带来六大问题:①跨模型路由并不经济,小模型中转再切回大模型,重新加载上下文反而成本更高;②工具调用前置全量声明,高基数 + 离线策略调用模型表现差;③上下文压缩 compaction 默认假设未来共用一套状态,盲压缩远不如查询感知压缩;④子 Agent 并行受限,痛点是状态传递与结果合并;⑤会话重启是状态腐化的妥协,替代方案是按需加载历史状态;⑥“是否预装全套工具” 存在路线对立。
TypeSafe 核心方案:元注意力 Meta‑attention,抛弃静态上下文,每轮查询动态重建上下文,做成本感知决策(复用 KV Cache / 重建),上下文片段分级(隐藏 / 短摘要 / 长摘要 / 全文)。 解锁能力:成本感知模型路由、大规模子 Agent、按需加载工具 Schema 不污染上下文、条件化AGENTS.md常驻记忆。
前沿构想:结构化 Skills、递归语言模型 RLM、安全感知路由、后台只读任务(检索结果多任务共享摊薄成本)。实测数据:代码 Agent 读取 + 搜索占工具轮次 56.2%、主 Agent Token46.5%,结构化检索是最大效率杠杆,可集成 ast‑outline、ast‑grep、fastcontext 等工具。
10 个关键问题问与答
- Q:为什么要重新开发代码 Agent,现有 Agent 不够用吗?
A:现有 Agent 大量特性是适配 KV‑Cache 的补丁;内核简单,但状态、上下文、成本管理创新不足,部分能力只有原生架构可以实现,插件模式无法做到。 - Q:KV‑Cache 带来最大的现实痛点是什么?
A:跨模型切换需要重新完整加载上下文,带来额外 token 成本,让 “小模型预处理 + 大模型收尾” 的路由策略经常得不偿失。 - Q:模型路由为什么很多场景不省钱?
A:KV‑Cache 按模型隔离。切回大模型时,全部上下文、中间工具输出要重新输入计费;长会话或者工具调用量大时总成本反高于全程大模型。 - Q:上下文压缩 (compaction) 的根本缺陷?
A:它默认未来所有轮次共用同一套状态;盲压缩不知道后续查询目标,效果远弱于 “知道查询目标” 的查询感知压缩,还容易丢失关键信息。 - Q:现在子 Agent 很难大规模自动并行的瓶颈在哪?
A:不是单纯推理算力,是状态管理:传给子 Agent 哪些上下文、子 Agent 返回哪些信息合并回主 Agent,状态搬运成本高。 - Q:Meta‑attention 元注意力核心是什么?
A:不再把上下文当作静态固定集合;每收到用户查询,评估旧上下文价值,成本感知选择复用 KV 缓存或完全重建,上下文片段做四级粒度控制。 - Q:Meta‑attention 能解决哪些过去很难的事?
A:真正经济可行的模型路由;大规模子 Agent;近乎零成本内置数百工具;条件化常驻记忆 AGENTS.md,不会被压缩吃掉。 - Q:Skills/MCP 工具调用如何做第一性原理改进?
A:不在系统提示词塞满全部 schema;只保留简短动作提示,需要时动态加载完整 schema,避免污染常驻上下文,实现海量工具低成本预装。 - Q:代码 Agent 最大的效率瓶颈是什么?
A:观测轨迹显示:读取 + 搜索占全部工具调用轮次 56.2%,主 Agent token 消耗 46.5%;用 ast‑outline 这类结构化检索替代子 Agent 搜索是最高杠杆。 - Q:什么是安全感知路由与后台只读任务?
A:安全路由:按任务触碰文件的安全等级,分配不同安全等级 / 成本的模型;后台只读任务:一次代码检索结果被多个后台任务复用,分摊开销,实现跨模型评审等能力。
Diogo(TypeSafe CEO):聚焦大模型代码智能体架构研究。他以 “如果 LLM 没有 KV‑Cache” 反事实思想实验切入,指出当下多数 Agent 特性只是 KV 缓存催生的工程补丁,主张以显式状态、Meta‑attention 元注意力、动态重建上下文重构 coding agent,探索子 Agent 规模化、成本‑安全感知路由等下一代智能体设计方向。
我有几条核心假设:
-
代码智能体本身出奇的简单 -
尤其是智能体循环那部分 -
本质就是 while循环,搭配少量工具 -
在非智能体内核模块上,真正有价值的创新寥寥无几 -
我们可以复用现有代码智能体的优秀成果 -
大模型底座当然可以复用 —— 通过 API 调用市面上所有顶尖模型 -
甚至交互界面组件也可以借鉴 -
有大量开源项目可供参考(不过 MCP 这类组件的鉴权复杂度尚不明朗) -
大厂第一方智能体的成本优势或许正在减弱 -
(推测)智能体的使用模式越来越偏向按使用量付费的 API 模式 -
存在一些能力,只有原生自研架构才能实现 -
也就是说,不能做成现有智能体的插件 -
我经常向业内同行抛出一个问题:如果大模型完全没有 KV 缓存,你会如何设计代码智能体? -
这一思想实验可以引导我们走向以 TypeSafe 为核心的设计路线 -
同时帮我们看清现有方案的局限,理解很多直觉上本该可行的方案为什么实际行不通
KV 缓存的 “桎梏” 催生了哪些怪异现象
现象一:模型路由策略实际并不划算
测算示例:
-
Opus:输入 5 / 输出 25 -
Sonnet:输入 3 / 输出 15
对比两套方案:
-
全程只用 Opus -
先用 Opus,切到 Sonnet,再切回 Opus
变量定义:
-
X:上下文 token(百万) -
Y:输出 token(百万) -
Z:输出中额外生成的 token,例如执行命令、读取文件产生的 token
方案一(全程 Opus)成本:
-
Opus 生成内容: 25 * Y -
Opus 读取内容: 5 * Z -
总成本: 25Y + 5Z
方案二(Opus→Sonnet→Opus)成本:
-
Sonnet 加载上下文: 3 * X -
Sonnet 生成输出: 15 * Y -
Sonnet 读取内容: 3 * Z -
Opus 重新加载全部上下文: 5 * (Y + Z) -
总成本: 3X + 20Y + 8Z
在给定一组实际业务比例后测算,全程使用 Opus 的成本仅为这套路由方案的三分之二。
小结:先调用小模型处理,再切回大模型,成本反而更高;根源是切回大模型时,全部上下文需要重新走一遍计费处理。
现象二:工具调用是一种很别扭的权衡
工具必须在系统提示词中预先全部声明, 但并不是每一轮会话都会用到全部工具; 并且调用工具时还必须完整写明全部参数。
由此带来的问题:
-
会大量消耗上下文 token; -
模型实际执行效果并不理想。
我的推测:模型并不擅长处理高基数 + 离线策略叠加的工具调用场景。 (这一点尚存争议,这也是 Skills 具备优势的原因,但 Skills 和普通工具、MCP 又有本质区别)
现象三:上下文压缩(compaction)的出现
上下文压缩成立的前提假设:智能体后续每一轮交互,都需要同一份共享状态。 但我们凭什么默认这个假设成立?
压缩要解决的难题本身有两大痛点:
-
实现难度极高; -
效果大概率不如查询感知式压缩:如果你提前明确检索目标,压缩工作会简单得多。
现象四:子智能体体验差强人意
这一点我还没有十足定论,但让我意外的是,模型很难做到自动并行执行任务。 我怀疑瓶颈在于状态处理难题:
-
哪些上下文片段要传给子智能体? -
子智能体执行完毕后,哪些上下文信息需要合并回主智能体?
现象五:会话重启功能
只有当智能体是有状态的,并且状态会慢慢劣化损坏时,重启功能才有意义。 但还存在另一种思路:当需要的时候,再即时加载全部相关历史状态。
现象六:“是否内置全套工具能力” 的行业争议
业内对于智能体是否应该预装全套工具能力一直争论不休。 参考推文:https://x.com/sudoingx/status/2061073944611029393
两边的取舍权衡:
-
追求开箱即用:OpenClaw 是这一派的典型代表; -
面向高阶用户:代表为 Claude Code、Codex。
TypeSafe + 代码智能体
下面把可以实现的能力划分成不同类别介绍。
基础能力 —— 任意智能体都可以集成
权限与审批机制
-
是否允许执行外部命令,对标 Claude 的自动模式; -
理想状态支持可编程规则,定义哪些行为允许、哪些禁止。 -
更细粒度的权限管控: -
例如执行 Python、Bash 脚本前,预先读取脚本内容做安全校验。
MCP / 工具调用
-
我们可以充当工具调用的路由中间层; -
输入一段高层自然语言描述任务目标,通过多次 TypeSafe 调用,筛选出最合适的工具,或者 Top N 候选工具。
高级能力 —— TypeSafe 原生独有特性
“元注意力 Meta‑attention”:智能上下文与相关性过滤
彻底抛弃「上下文是静态固定集合」的固有认知。 针对每一次用户查询,重新计算两件事:
-
原有历史上下文还有多大利用价值 -
复用现存 KV 缓存本身是合理自然的;我们需要做成本感知决策:判断是复用现有缓存,还是直接从零重建上下文。 -
重新构建一份只包含全部相关信息的新上下文。
最简单的实现思路:给每一块上下文片段打标记,片段来源包括:
-
工具的输入 -
工具的输出 -
模型内部推理过程 -
甚至用户之间的对话交互
未来版本可以为每一个上下文片段设置分级标签:
-
完全不展示 -
展示简短摘要 -
展示详细摘要 -
展示完整原文
模型路由 + “子智能体”
拥有原生动态上下文能力之后,就可以把简单任务路由到更廉价、速度更快的模型。 整套调度逻辑必须同时兼顾成本与模型能力。
我的猜想:子智能体的大部分开销,来源于判断要传入哪些上下文。如果这一环节变得廉价、自动化,子智能体就能大规模落地使用。 同时还可以向用户开放调节选项:是多花钱换取更好更快的结果,还是保守控制开销。
基于第一性原理重构 Skills / MCP / 工具调用
我认为中间层应该存在一种新范式: 只保留简短的描述片段,告知模型有哪些动作可以调用。
如果模型完全不知道某类动作的存在,就不可能主动建议调用它,这点和 Skills 的设计思路类似。
但是不需要把全部信息塞进系统提示词,可以在需要的时候动态加载:
-
真正要调用动作时,再加载动作的完整 Schema,类似工具检索能力; -
该机制不会污染常驻上下文。
这是前所未有的特性: 如果这套方案可行,我们几乎可以零成本内置海量工具。 近乎零成本地预装能力,既是产品杀手锏,也可以用作联合营销。 试想:内置数百个工具,数千份参考文档。
脑洞构想 —— 尚在构思,抛出来探讨
完善的内置工具生态
很多开源项目宣称可以赋能智能体,但实际落地效果很差。 举例:https://github.com/rtk-ai/rtk,一款上下文压缩工具。
我的推测:大模型本身并不能原生理解这类外部工具。 我们可以配套专属提示词,包装成原生子智能体或者 Skill,保证调用逻辑正确。 我们干净可控的上下文环境,可以动态加载这些工具,同时不会被乱七八糟的自定义逻辑污染。
持续集成当下热门项目,也可以帮助产品获取行业关注度。
补充想法:做一个开源项目作为造势载体,可以持续跟进领域最新热点。
条件化系统提示词 / AGENTS.md
根据不同运行条件,动态加载 AGENTS.md 的不同片段。 举例:
-
当前任务是前端开发 → 自动加载前端代码风格指南; -
进入某个子代码目录 → 自动加载该目录踩坑避坑文档(说实话每个子目录都应该有一份踩坑文档)。
它和 Skills 有一定相似,但核心区别:Skills 偏向立刻执行某个动作;而这套机制是把信息常驻在记忆中。 另外,常驻记忆需要免疫上下文压缩过滤:普通 Skill 加载后,经过压缩轮次很容易被摘要丢失。
顺带一提,我非常希望聊天机器人也拥有这套能力:
-
需要输出摘要?按 Org‑Markdown 格式输出; -
需要模仿我的写作风格?加载写作样例和禁忌要求; -
编写代码?不要生成大量断言,同时加载代码风格指南。
结构化 Skills
想法还不成熟。如果我们把运行执行框架做得高度可编程,Skills 就可以大幅度改变智能体行为。 对标 Claude Skill Hooks:https://code.claude.com/docs/en/hooks#hooks-in-skills-and-agents,但能力更强。 据我所知,现有的钩子一旦启用,会永久作用于整个会话。
递归语言模型 RLM
参考文章:https://alexzhang13.github.io/blog/2025/rlm/ 核心概括:引入更多变量,使用显式状态。 把状态处理为显式变量,整套架构会变得干净很多。
高级摘要能力
一个构想:为 grep 命令输出做相关性热力图,按需动态裁剪输出内容,视觉效果也很好。
大规模子智能体 + 任务并行
具体落地方式还不确定。依托上面的架构,批量启动大量任务会变得简单;但要处理很多棘手但必要的机制:同步原语、任务间通信。 例如多个子任务共享状态,通过锁机制解决写冲突。
安全感知路由
部分国产模型价格极低,但存在数据泄露风险(例如 DeepSeek V4 成本极低)。
设想方案:
-
评估子任务、子智能体会访问哪几类文件; -
针对不同文件类型设置不同安全策略; -
低敏感任务路由到低成本模型。
进一步拓展:路由的判断依据不只有任务难度、成本。 举例:做大模型相关研究任务就不调用 Anthropic;安全敏感任务不使用 OpenAI、Anthropic。
附录
可集成、可优化的工具示例
- headroom
https://github.com/chopratejas/headroom 上下文压缩工具 想法:增加分类器,校验压缩结果是否保留关键信息。 - rtk‑ai/rtk
https://github.com/rtk‑ai/rtk 工具输出内容压缩工具。 - ast‑grep
https://github.com/ast‑grep/ast‑grep 结构化检索工具 想法:遇到陌生工具时,可以临时加载工具手册,生成多条检索查询,再交由模型筛选查询的相关性。 - ast‑outline
https://ast‑outline.github.io/ 另一款结构化代码解析工具 猜想:可以用于分层函数调用,让模型自主选择要探查的代码子树。 - fastcontext
https://github.com/microsoft/fastcontext 用于代码库探索的子智能体 观测结论:在对 GPT‑5.4 运行轨迹分析中,读取与搜索占全部工具调用轮次的 56.2%,占主智能体总 token 消耗的 46.5%。 如果该结论具备普适性,优化这一块就能带来巨大效率提升。 两个优化方向:智能调度子智能体;使用结构化检索直接替代子智能体的搜索逻辑。 - fff
https://github.com/dmtrKovalenko/fff 抗拼写错误的路径与内容检索、按访问频率排序文件、后台监听、轻量内存索引。在多次检索的长会话场景,速度远超 ripgrep、fzf 这类命令行工具。
其他想法:优化/goal目标机制,做显式的子目标去重。不确定会不会出现重复任务;但可以在启动子任务之前,把新子目标和历史子目标做去重校验。
SLOP:代码智能体子任务拆解清单从输入 token 占比视角来看:
-
搜索任务:输出噪音大,有效信号少; -
堆栈信息、测试日志内容冗长;执行失败的规划记录。
如果需要针对不同子任务定制特殊逻辑,这份拆解清单可以作为很好的起点。
附录 2:后台处理 — 一种潜在的智能体工作范式
观察到近期一批热门智能体工作流:
-
https://x.com/xpasky/status/2073298979203211628:并行构建、更新 HTML 页面 -
https://x.com/geoffreylitt/status/2072522251300409556:“理解才是新的性能瓶颈” -
https://x.com/samhogan/status/2071608749429858:后台生成评估用例 -
https://x.com/trq212/status/2090884854590382515:ELI5 通俗解释 Skill
它们的共性:
-
全部是后台运行; -
作为普通编码工作流的后台扩展; -
大多是基于当前代码库状态的只读操作。
还有一类现成的模式也符合该范式:跨模型代码评审。 例如让 Codex 审查 Claude 产出的代码。
TypeSafe 在这里的定位
以 TypeSafe 为中心的代码智能体,核心前提:状态必须显式管理,全部纳入上下文体系。 借助精细化的状态管理,模型路由、子智能体等能力的效率会大幅提升。
这套架构和只读后台任务具备极高协同效应。 查找一次代码变更对应的相关信息本身开销不小; 如果这份检索结果可以被多个后台任务共享、分摊成本,就可以经济地大规模运行后台任务。
我认为显式区分状态的读、写权限,最终会释放巨大的能力