

编者摘要:这篇谷歌云技术文章聚焦编码 Agent 运行框架的 Token 成本痛点,介绍 Gemini 企业平台的服务端上下文缓存技术。原生实现每轮都完整上传全部静态上下文,带来 Token 暴涨、网络开销、重复 Token 化计算三大问题。缓存生效的硬性前提是提示词前缀字节完全一致,可变内容只能放在末尾;一旦前缀混入动态元数据就会缓存失效。
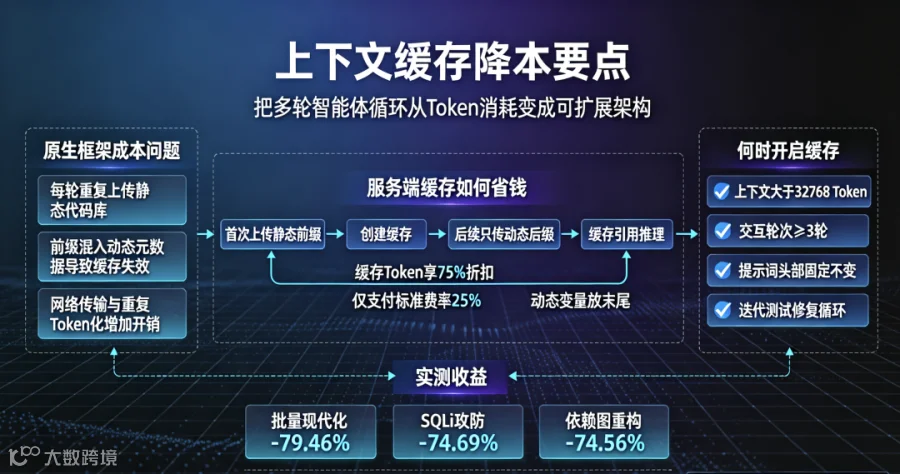
缓存具备双重价值:降低网络传输量,同时缓存 Token 享受 75% 价格折扣,仅支付原费用的 25%。工程实现依靠两大模块:一是隔离静态前缀与动态后缀,保证前缀不变;二是缓存管理器,完成哈希复用、TTL 管理、缓存推理请求调度。
三组实测业务场景,Token 传输量下降 74%‑80%。同时给出落地判断标准:上下文大于 32768 Token、交互≥3 轮、提示词头部固定不变,才适合开启缓存;小上下文、少轮次、前缀频繁变动场景不要使用,避免管理开销大于收益。代码迭代修复类循环是缓存最佳场景。整套方案基于 Google ADK2.0,全部测试代码开源,可直接复现实验并集成进自有 Agent 框架,解决多轮编码智能体 Token 成本失控问题。
Q&A
Q1:为什么不能随便把动态字段放在提示词开头?A:上下文缓存依赖从第 0 位开始的精确 Token 序列匹配。前缀一旦改变,哈希改变直接缓存未命中,完全丧失缓存成本优势。动态内容必须后置。
Q2:缓存一定会省钱吗,什么场景不适合?A:不是。上下文过小、轮次少于 3 轮、静态头部频繁变动,缓存创建和维护开销无法摊薄收益,不建议开启。
Q3:缓存模式下,我还需要传完整代码库吗?A:仅第一次创建缓存时上传完整静态代码库;后续每轮只传少量动态后缀,带上缓存 ID 引用即可。
Q4:缓存 Token 的计费规则是什么?A:缓存创建按正常费率;后续读取缓存内容打 2.5 折(收取原价 25%);动态后缀依旧标准计费。
附录:如何在智能体运行框架中利用上下文缓存大幅降低 Token 成本
来源:Google Cloud Tech 文章,作者:BalajiBuilds(谷歌云开发者关系工程师)
编码智能体会执行繁重的工程任务。智能体运行框架(agent harness)负责管理运行时状态、沙箱执行以及提示词组装。如果每一轮交互都重复传入静态上下文,会造成多轮迭代的扩容瓶颈,消耗大量 Token,推高使用成本。
有多种方案可以解决该问题,其中之一就是Gemini Enterprise Agent Platform,它能够消除这类 Token 浪费。将静态代码库保存在服务端缓存中,后续轮次仅传输动态更新内容,运行框架就可以大幅减少输入数据传输量。
本文先说明原生运行框架实现产生额外成本的根源,再讲解如何基于 Google ADK 2.0 与 Gemini 企业级智能体平台,搭建生产可用的上下文缓存流水线,规避相关问题。
原生智能体框架产生高额成本的根源
Token 累积问题
大语言模型本身是无状态的:接收一串 Token 输入,输出生成文本。而智能体运行框架维护对话记忆,每一次调用模型都要序列化完整上下文窗口。
举一个典型多轮编码工作的计算示例:静态参考代码共 37500 Token,每一轮追加 300 Token 的错误回溯信息。5 轮执行场景下:第 1 轮输入 37800 Token,第 2 轮依旧传输 37800 Token,以此类推。5 轮结束,计费提示 Token 达到 189000。针对大型代码库做 10 轮重构任务,会消耗接近 40 万提示 Token。网络反复上传完全相同的文件,服务端也要重复做 Token 化计算。
框架设计中的「前缀破坏陷阱」
上下文缓存要求:从提示词第 0 号 Token 开始,字节级完全精确匹配。 如果运行框架把可变运行时元数据放在静态文本的前面或者中间,提示词哈希值就会改变。服务端无法命中已有缓存,触发缓存未命中,依旧按照完整提示词标准费率计费。
核心原则:动态变量必须放在提示词末尾,绝对不能放在开头。
服务端上下文缓存底层原理
智能体平台内部存在完整的上下文缓存生命周期。 上下文完成缓存之后,运行框架只需要传入动态后缀(例如单元测试回溯、编译器报错),同时带上缓存引用标识即可。
双重收益模型:带宽节省 + 成本节省
上下文缓存带来两类收益:
- 网络带宽节省
减少实际网络传输的数据量 - 费用折扣
在 Agent 平台中,读取缓存内容享受75% 折扣,缓存 Token 仅收取标准提示词费率的 0.25 倍。
搭建可靠上下文缓存流水线
一套可用的上下文缓存架构,核心两点:确定的负载结构、集中式缓存生命周期管理。下面拆解核心组件实现。
在运行框架中保证前缀不变性
为避免前缀被破坏,框架需要严格把不可变提示词头部,和动态执行后缀隔离开。参考开源代码 cache_manager.py中对应实现。
在智能体框架中实现缓存管理器
缓存管理器负责 Agent Platform 上缓存资源全生命周期:
-
计算内容哈希,复用已经激活的缓存 -
根据需要更新缓存 TTL 生存时间 -
发起使用缓存的推理请求
端到端实例:多目标代码现代化改造
模拟真实业务场景:批量升级 5 个 Python2.7 模块,整体静态代码约 37000 Token,以此验证缓存效果。完整用例、沙箱运行框架见项目 multi_target_suite.py。
在 Google Cloud Run 的 Python3.11 沙箱环境,对 3 种不同多智能体拓扑做实测:
场景 1:多目标批量现代化改造(5 轮)
基于 37659 Token 单体仓库静态前缀,改造 5 个独立遗留 Python 文件
-
无缓存基线:190139 输入 Token -
缓存模式实际传输 Token:39503(37659 缓存写入 + 1844 动态后缀) -
传输量下降:79.46%,减少 150636 Token
场景 2:SQL 注入红蓝攻防辩论(4 轮)
红队攻击智能体、蓝队修复智能体开展 4 轮安全辩论,静态上下文为 38367 Token OWASP 安全规范
-
无缓存基线:154008 输入 Token -
缓存模式实际传输 Token:38907 -
传输量下降:74.69%,减少 115101 Token
场景 3:多文件依赖图现代化重构(4 轮)
4 层相互依赖微服务,基于 38441 Token ORM 数据库 SDK 上下文做链式重构
-
无缓存基线:154479 输入 Token -
缓存模式实际传输 Token:39156 -
传输量下降:74.56%,减少 115323 Token
上下文缓存决策树(落地判断准则)
上下文缓存收益巨大,但需要结合业务场景选择性启用:
- 上下文小于 32768 Token:不启用缓存
。低于该阈值,提示词传输成本很低,缓存管理开销得不偿失。 - 交互轮次小于 3 轮:不启用缓存
。1‑2 轮调用无法摊平缓存创建的成本。 - 每轮提示词头部都会变化:不启用缓存
。先重构提示词逻辑,隔离静态内容,再考虑缓存。 - 针对大型代码库做迭代测试‑修复循环:务必开启缓存
。框架强制保证前缀不变,通过缓存管理器调度请求。
复现实验与快速上手
全部可复现实验代码开源,访问项目仓库 context‑caching目录。
总结:上下文缓存可以把多轮智能体循环从高额 Token 消耗源,转变为稳定可扩容的架构。核心逻辑很简单:当你需要在 3 轮及以上轮次反复传入大型静态代码库时,将动态上下文后置,绑定服务端缓存,让模型复用缓存内容。直接使用仓库内代码与测试套件即可开始实践。