
9月23日,AI赛道迎来了一场罕见的"撞档"发布。
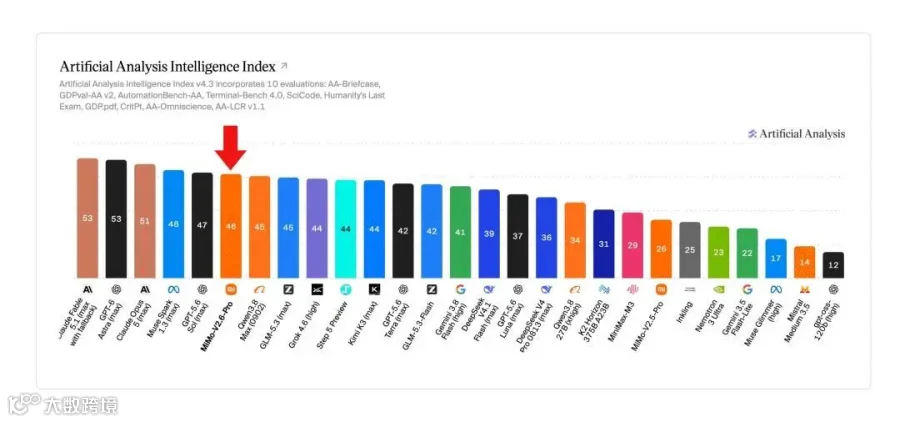
马斯克预告了近两个月的Grok 4.7正式亮相,小米MiMo团队则在同一天宣布V2.6系列全面开源。两款模型分属闭源与开源阵营,却在Artificial Analysis综合智能指数上拿到了一模一样的46分。
相同的成绩单,截然不同的价签——两者任务成本相差近29倍。
这场"同分不同价"的对决,迅速在开发者社区引爆讨论。
一、46分背后的账单:207美元 vs 4967美元
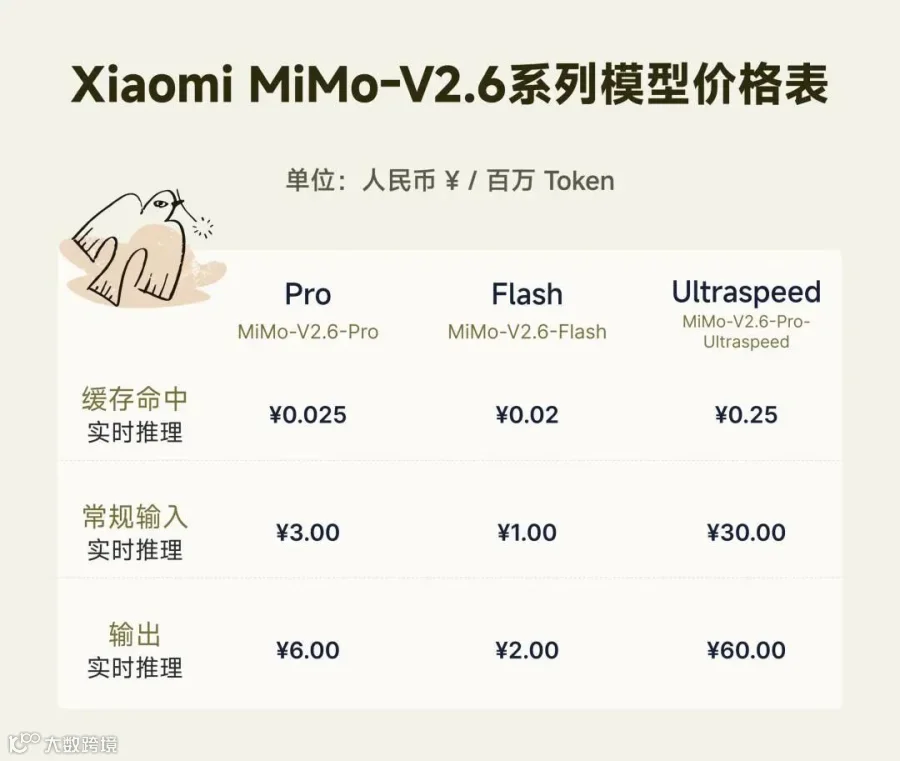
先看两组定价逻辑。Grok 4.7延续了上一代4.6的API价格体系,MiMo-V2.6也沿用了V2.5系列的收费标准。乍看双方都"维持原价",但同样的智能水平下,实际使用成本天差地别。
Artificial Analysis的统计极其直观:
- MiMo-V2.6-Pro:完成每项Intelligence Index任务仅需0.13美元,整套评估跑下来花费约207美元;
- Grok 4.7(xhigh档):单项任务成本高达3.74美元,完整评估总花费逼近5000美元。
29倍的成本鸿沟,根源在于Grok 4.7"话多且慢"。
在整个评测过程中,Grok 4.7累计吐出了2.4亿个Token,而中位数水平仅为9400万——这意味着它在回答同样的问题时,输出了远超必要的内容量。与此同时,其处理速度仅39 Token/s,面对长提示时输出速率也仅约188 Token/s。冗长的输出叠加偏慢的推理速度,直接将成本推向了天花板。
讽刺的是,马斯克本人在X上高调宣称Grok 4.7"集智能、速度和低成本于一身",SpaceXAI官方更是标榜"两倍速度、半价价格"。然而数据摆上台面后,这些宣传语几乎句句落空。
有开发者一针见血地指出:"既然已经有一款能力同级、价格却低一个数量级的国产开源SOTA,继续用Grok的意义在哪里?"
二、方向不同:一个聚焦深水区,一个铺开全场景
如果仅看跑分,这似乎是一场平局。但深入对比能力布局,两款模型的路线其实截然不同。
Grok 4.7:押注长程编程与知识处理
SpaceXAI给Grok 4.7画了一条清晰的能力主线:面向需要数小时才能完成的复杂编程和知识工作。
官方表示,新模型采用了更大规模的基础底座,经过更长周期的强化学习训练,任务组合复杂度显著提升。它在自我验证、长上下文处理和结果审查方面均有改进,并原生兼容Grok Bot框架。
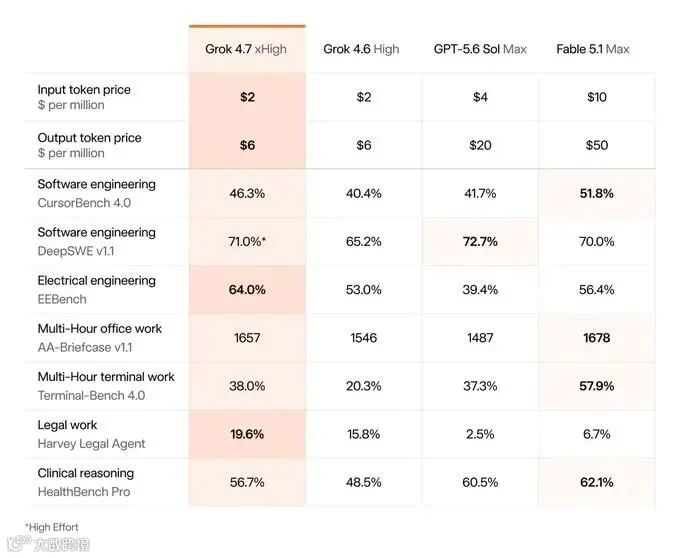
基准成绩确实展现了进步:
| 测试项目 | Grok 4.6 | Grok 4.7 | 提升幅度 |
|---|---|---|---|
| AA-Briefcase v1.1(长流程知识工作) | — | 1657 Elo | +111分 |
| GDPval-AA(真实工作场景实用性) | — | 1695 Elo | +90分 |
| CursorBench 4.0(长时间编码) | 40.4% | 46.3% | +5.9pp |
| TerminalBench 4.0(终端操作) | 20.3% | 38.0% | +17.7pp |
但短板同样明显。TerminalBench 4.0的38.0%仅与DeepSeek V4.1 Flash持平,未及GLM 5.3 Flash,距离GPT-6和Fable 5.1差距更大。上下文窗口虽从256K扩至500K,仍未触及国产模型普遍标配的1M门槛。
MiMo-V2.6:从编程工具到"Vibe World"构建者
小米的能力版图铺得更宽。MiMo-V2.6将3D空间推理、多模态感知与计算机操作(CUA)融为一体,把传统的"自然语言编程"升级为面向交互世界构建的"Vibe World"。
官方演示场景横跨多智能体游戏开发、Blender 3D建模、机械臂闭环控制、端到端视频创作、音乐作曲及前端设计。在Computer Use方面,模型能够理解复杂GUI界面,操作办公与生产力工具完成检索、编辑和数据处理,并根据视觉反馈自主排查问题、调整行动策略。
实测数据同样亮眼:
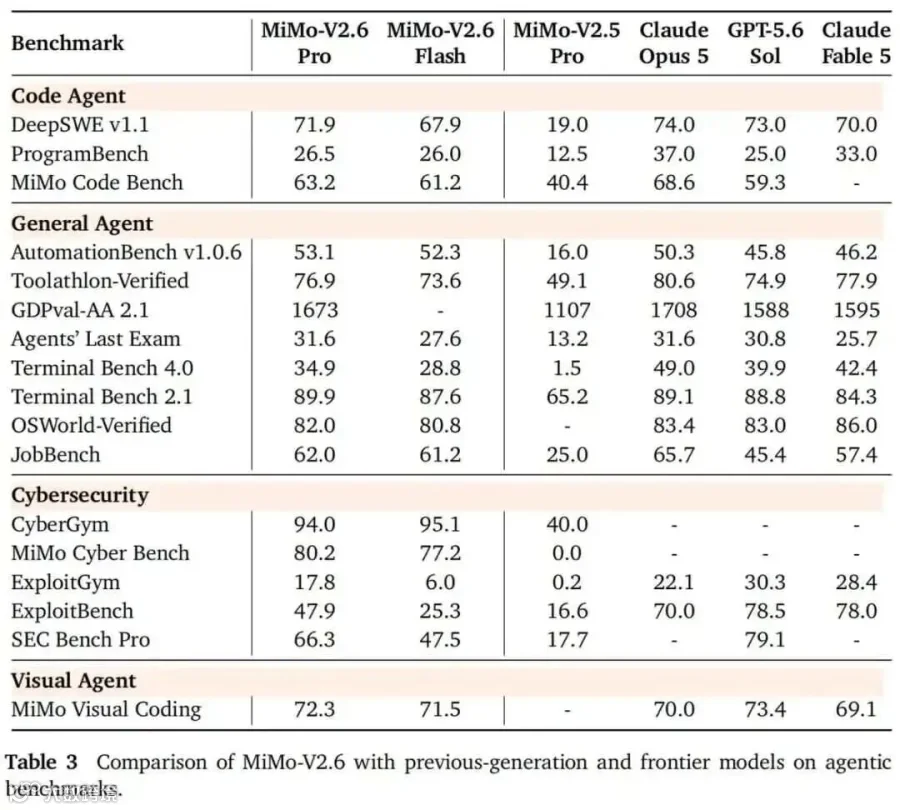
- Terminal Bench 2.1(终端真实交互):Pro 89.9 / Flash 87.6
- AutomationBench v1.0.6(通用智能体):Pro 53.1分,超越Claude Opus 5、GPT-5.6 Sol和Claude Fable 5
- OSWorld-Verified:Pro 82 / Flash 80.8
- Design Arena(设计评测):Pro与Claude Opus 5、GPT-5.6 Sol比肩
MiMo-V2.6-Flash在保持与Pro接近的能力水平的同时,更强调效率与成本的均衡,适合对响应速度敏感的场景。 此外,MiMo Desktop同步上线了Pro版的UltraSpeed超高速模式,提供最高20倍输出加速。
三、同一张考卷:交付能力的真实差距
当两款模型被放进同一个测试场,结果颇为微妙。
在专门衡量长程软件工程能力的DeepSWE v1.1中,MiMo-V2.6-Pro拿到71.9分,Grok 4.7为71分——差距不大,但MiMo领先。 值得注意的是,MiMo-V2.5-Pro上一代在这个项目上仅得19分,V2.6实现了从19到71.9的跨越式飞跃。
开发者社区的实测更具冲击力。有人给两款模型下发了同一个Three.js单文件提示词:
- MiMo-V2.6:交付了一个完整的发射场场景——发射塔、储罐、地面一应俱全;
- Grok 4.7:磨蹭许久后输出了一团烟雾加一个扭曲的雕塑,发射塔、储罐、地面全部缺席。
在3D墨水画渲染对比中,MiMo-V2.6的成品同样更为生动精致。有开发者直言:"Grok 4.7在这个对比里存在的意义,就是更好地衬托MiMo-V2.6 Pro有多惊艳。"
Grok 4.7在自己的优势Benchmark中确实完成了显著升级,但在实际生成任务面前,MiMo-V2.6以更低的价格展现了更强的"交付感"。
四、小米的底牌:史上最大规模开源RL训练 + RSI路线
MiMo-V2.6能以极低成本追平闭源旗舰,背后的方法论并非黑箱——小米在发布前就进行了全程训练直播,这在国产大模型发布中极为罕见。
MiMo团队负责人罗福莉透露了三层训练架构:
- MixRL(混合强化学习):在中等难度可验证任务(代码及智能体任务)上运行,模型泛化效果出色;
- 独立训练:将难以验证、极长程或过于困难的任务单独训练,避免拖累整体rollout效率或引入陈旧性问题;
- MOPD合并:将两类训练成果融合,游戏、3D任务和带主观评估信号的任务均归入此类。
按算力规模衡量,这很可能是开源模型团队迄今最大规模的单次RL训练。
训练数据同样公开透明:
- 不到六天,Flash和Pro各完成30个RL步骤,合计约75万条轨迹;
- 两轮RL累计训练150.5万个样本、1564亿Token;
- 总成本约347万美元(Flash约85万,Pro约262万)。
罗福莉以曾参与DeepSeek R1部分工作的视角评价:"这轮训练涉及的研究创新和工程挑战,已经超过R1。"
更值得关注的是,小米首次明确提出了RSI(递归自我改进)路线,将MiMo-V2.6定义为"探索RSI路径的关键一步"。 罗福莉表示:"在一个智能易于复制的时代,我们仍选择通往自我改进和AGI的艰难道路。在算力极度稀缺的时代,让一支数十人的团队长期专注于扩大RL规模——这需要的不仅是研究信念,更需要对AGI的愿景、对未知的敬畏,以及直面最难问题的勇气。"
五、下一局:2.5万亿参数新架构 vs RSI渐进迭代
当国产开源模型以海外闭源旗舰数十分之一的成本,交出同级甚至更优的智能表现时,竞争的紧迫感已不只是停留在跑分层面。
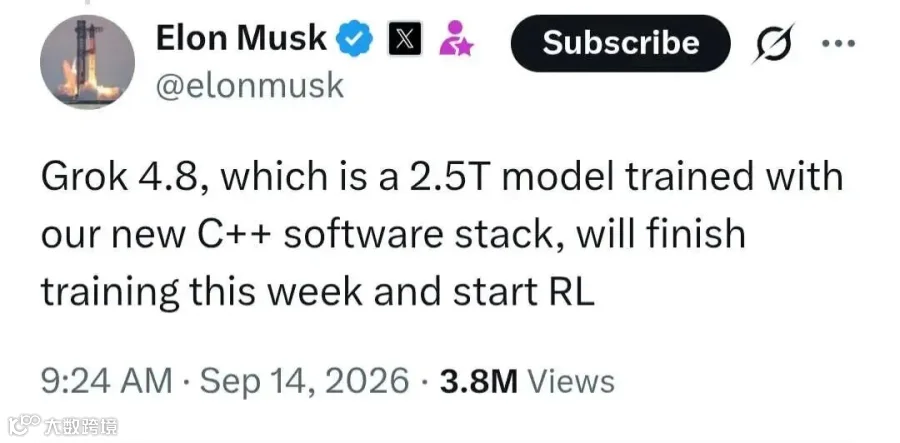
大洋彼岸,马斯克已在为下一轮押注蓄力。据他公开透露,Grok 4.8本周即将完成预训练并进入RL阶段,参数规模约2.5万亿,并将采用一套全新的C++软件栈进行训练——这是一次押注架构跃迁的重磅筹码。
而罗福莉选择的路径,是沿着RSI一步步迭代,在每一轮模型中积累可复用的自我改进能力。
一边是赌参数规模和训练架构的质变,一边是在工程和方法论上稳扎稳打。 两条路线的下次碰撞,也许才是这场对决真正的高潮。
但无论下一局结果如何,MiMo-V2.6已经证明了一件不可逆的事实:开源世界正在以远低于闭源的成本,持续缩小智能差距。 而这,可能比任何一次跑分的胜负都更具深远意义。

关注抖音【靓哥聊创业】
抖音号|54707203975
保存二维码打开抖音扫一扫