大数跨境

VST 研究详解丨VST:给AI量化多智能体装上可验证的结构化传输总线

VST 研究详解丨VST:给AI量化多智能体装上可验证的结构化传输总线 PandaAI个人量化超级助手
2026-09-24
5
导读:过去几年,AI 量化的研究边界正在从单智能体自动化挖掘,走向多智能体协同的完整研究流程。

过去几年,AI 量化的研究边界正在从单智能体自动化挖掘,走向多智能体协同的完整研究流程。从公式搜索到代码生成,再到挖掘—评估双环耦合的自进化系统,智能体的分工越来越细,能够处理的研究复杂度也越来越高。
这是继双循环自进化 Alpha 发现系统之后,PandaAI 在多智能体量化投研方向上的又一项研究工作。但协同能力的增强,并不意味着系统效率会随之线性提升。
多数多智能体框架仍以自由文本交互为核心。智能体之间可以传递信息、完成单轮协作,却缺乏对交互状态、因果链路和事务边界的系统定义。结果是,系统跑了成百上千轮循环,积累了大量因子和报告,却没有一条可精确复现的交互轨迹;每一轮反馈仍要等待全链路串行执行,周期成本随着循环数线性累积。
这正是 VST 试图解决的问题。与其继续强化单个智能体的生成能力,VST 关注的是多智能体之间的通信层本身:能否把自由形态的智能体交互,重构为一套结构化、可寻址、可验证的传输协议,让交互轨迹成为可预测、可跳跃、可审计的稳定资产。
从这个意义上说,VST 关注的不只是让多智能体跑得更快,而是推动自动化投研从「功能可用」,走向「过程可治理」。
arXiv:2609.07065v1

arXiv:2609.07065v1

01 / 当多智能体成为主流,通信层成了新的瓶颈
回顾近年来自动化 Alpha 发现的演进,其技术路线大致经历了两个阶段。
第一阶段主要围绕单智能体搜索展开。遗传规划、强化学习以及大模型代码生成,不断拓展因子的表达空间与搜索效率。但单智能体的局限也很明显:它只能在既定的目标和规则下执行搜索,无法同时完成挖掘、评估、优化的多重分工,也难以实现研究能力的自进化。
第二阶段则从单智能体搜索转向多智能体协同。双循环架构的出现,让 Alpha 挖掘与评估优化两个环节各自形成闭环,又通过报告智能体耦合在一起,系统能够自主迭代因子库、评估体系和研究技能。协同能力的提升,也进一步拓展了自动化研究的边界:机器不再只是生成候选因子,而开始能够自主完成从假设到验证的完整研究循环。
然而,协同规模的提升并未自动带来系统效率的提升。系统可以调度更多智能体执行任务,但如果智能体之间的交互依然是自由文本的「黑箱对话」,其本质仍是更快的单轮拼接,而非可管理的系统工程。
相比之下,人类研究团队的协作从来不是自由聊天。每一份报告、每一次反馈、每一轮版本更新,都有明确的格式、编号、状态和归属;每一条结论都能追溯到对应的实验、数据和决策节点。协作的价值,不只来自单次任务的完成,更来自整个过程的可追溯、可复现、可优化。
因此,VST 的问题定义从一开始就不是「怎么让智能体更快交互」,而是:一个多智能体研究系统,怎样才算拥有可靠的通信基础设施。
02 / 结构化传输的四层能力:契约、预测、验证、隔离
把一个多智能体 Alpha 发现系统的通信压到最本质,可以概括为四个核心需求。
每一条消息要有确定的接收者与格式契约,不能模糊歧义;每一次交互要有明确的因果链路,能够精确重放;每一段未来轨迹要有可预测性,能够安全地跳过冗余周期;每一方的进化要保持独立,不能因为协同而失去公正性。
现有多智能体系统往往只做到了第一层的内容传递:消息能发出去、能被读懂,但格式、状态、因果、边界都没有明确契约。前端的「确定性」和后端的「可验证性」长期缺失。
VST 的架构正是围绕这四层需求构建:三层结构化协议(C1)负责建立传输契约,多视野轨迹预测器(C2)负责预测未来交互,事务级验证跳跃控制器(C3)负责验证与提交,分离式技能进化机制(C4)负责保证独立性。不同模块之间流动的不只是文本消息,而是一套持续更新的、带状态的交互轨迹。
下面按顺序讲这条传输链上最核心的三层设计。
03 / 结构化契约:把自由对话变成可回放的因果轨迹
让多智能体传递信息,最直接的方法是用自然语言把指令、结果、反馈写成一段话发给对方。但这种方式本质上只是「信息送达」,而不是「契约传输」。
智能体交互中通常包含多层信息:发送者与接收者身份、当前轮次与状态、业务负载内容、事务状态与归属。如果缺少结构化的封装与校验,模型虽然「收到」了消息,却无法从系统层面验证其合法性、追溯其来源,也无法保证不同轮次之间的因果一致性。
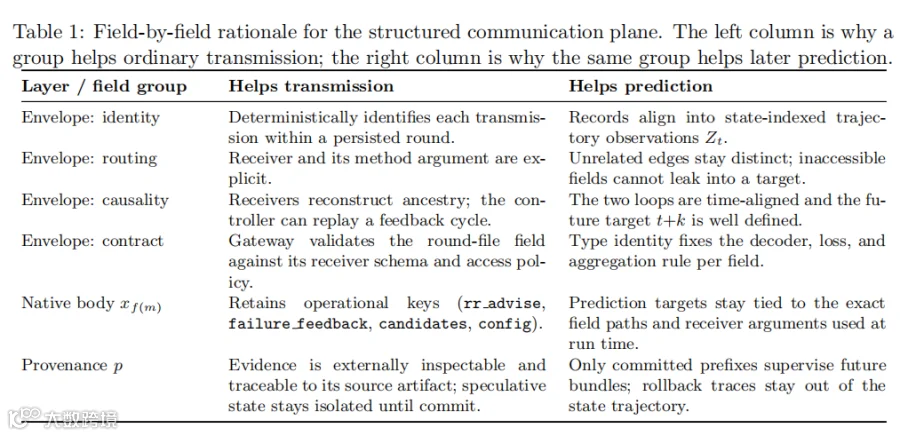
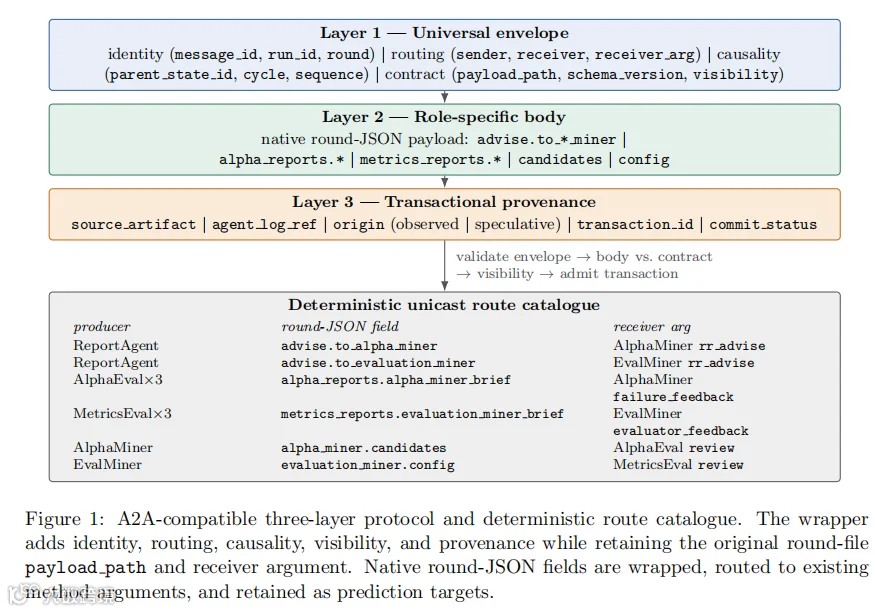
VST 通过三层结构化数据包(A2A Packet),将每一次智能体交互转化为带契约的可追溯记录,这一结构主要包含三个层级。
信封层(Envelope)负责路由与因果。它包含消息 ID、运行 ID、轮次号等身份信息,发送者、接收者、调用参数等路由信息,父状态 ID、周期序号等因果链路,以及负载路径、Schema 版本、可见性等级等契约信息。
这一层相当于给每一条消息盖上了「身份证 + 邮戳 + 权限章」,因此网关可以在不解析内容的情况下完成校验与路由。
负载层(Body)负责原生业务承载:保留原有系统的全部业务字段,比如给矿工的指导建议、给评估器的候选因子、返回的分析报告等。结构化改造不改变任何智能体的业务接口,只是在原有数据外加上标准信封,保证向下兼容。
溯源层(Provenance)负责事务状态:记录消息来自哪一轮文件、哪个智能体日志,标记是「已确认」还是「推测中」状态,以及对应的事务 ID 和提交状态。这一层让每一条消息都有明确的事务归属,是提交还是回滚的依据。
Figure 1

Figure 1

这三层封装完成,智能体之间传递的就不再是一段段孤立的文本,而是一条可校验、可寻址、可重放的因果轨迹。消息从「交互内容」变成了「系统状态的一部分」。
Table 1

Table 1

04 / 预测与跳跃:先看见未来,再验证落地
多智能体系统的问题不是不会加速,而是直接跳过验证去加速。拿到预测就直接替换执行,看起来效率很高,实际上是在赌预测的正确率。真正的系统级加速并不是从省略验证开始,而是从明确事务边界开始。
这也是 VST 设计多视野轨迹预测器的原因。预测器负责读取已确认的交互轨迹,预测未来 k 个周期两个矿工将收到的累积指导,形成候选的未来状态。它输出的不只是一段文本,而是符合结构化契约的完整状态包,同时附带置信度与不确定性估计。
当候选未来状态生成之后,系统并不会直接用它替换真实执行,而是启动一次推测性跳跃执行。
但跳跃本身也并非简单的「猜对就用」。推测执行最大的风险,并不是结果不对,而是错误的预测悄悄污染系统状态,导致后续全部偏离。
因此,VST 通过四层验证门对推测结果进行校验:L1校验格式合法性,L2校验双环交叉一致性,L3校验盲态评估风险,L4校验实证质量。只有四层全部通过,才会原子性地提交整个事务。任何一层不通过,系统都会精确回滚到跳跃前的确认状态,就像这次推测从未发生过。
换句话说,VST 并不是让预测替代真实的智能体执行,而是让结构化传输给推测加上了「安全护栏」——对了就前进多步,错了就原路退回,永远不破坏系统的确认状态。
05 / 分离式进化:成功与失败,都不污染评估标准
对于多智能体系统而言,预测成功通常意味着奖励强化,预测失败则意味着丢弃。但如果预测器和评估器共享一套进化机制,就会出现一个隐蔽的风险:预测器会逐渐「教会」评估器迎合自己的判断,让评估失去独立性,最终整个系统自欺欺人。
但对于真正的研究过程而言,评估的独立性比预测的准确性更重要。一个成熟的研究系统不会为了短期效率牺牲评价标准,而是让预测能力和评估能力沿着各自的路径进化。
VST 中,分离式技能进化机制负责从结构上保证这种独立性。可见性规则从传输层就规定:预测结果只能发送给矿工,绝对不能到达评估器;评估器看到的永远是真实执行的结果,永远不知道预测过什么。在此基础上,预测器的技能库和评估器的规则库完全分离,各自独立更新:
预测器从事务的提交/回滚结果中学习,优化预测精度与视野选择,成功的轨迹强化策略,失败的回滚作为负样本;评估器只基于真实的因子与配置结果进化规则库,不受预测结果的任何影响。
在这里,失败的推测不再只是被丢弃的结果,而成为预测器进化的重要反馈;同时,无论预测多么「正确」,都无法渗透到评估体系中。系统每跑一轮,多出来的不只是一次成功的跳跃,而是一段可审计的进化历史。
Figure 4

Figure 4

06 / 从精度中立到审计安全,VST 验证了什么
在 CSI 1000 指数、样本外验证的设定下,VST 在八项对比方法中取得了唯一的因子层面正收益。
最能说明差异的是因子层面的中位数表现:VST 的年化收益中位数为+5.9%,夏普比率中位数为+0.346,是所有方法中唯一同时为正的;而此前主流的方法全部落入负收益区间,包括 AlphaGen、AlphaMCTS 等代表性方案。
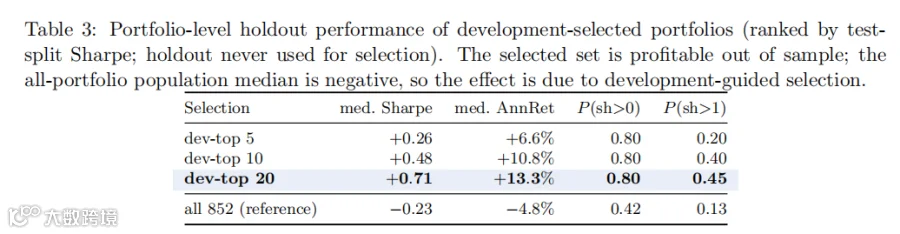
组合层面,经开发集筛选的前 20 个组合,样本外夏普中位数达到0.71,费前年化收益中位数13.3%。上述数值均为单次运行、费前结果,尚未计入交易成本、滑点与换手约束。
Table 2

Table 2

Table 3

Table 3

但比「收益领先」更值得看的,是两个关于「为什么价值不在精度」的证据。
第一个是精度中立性。
对照消融实验显示,结构化传输通道与自由文本通道的预测命中率几乎完全一致(0.9749 vs 0.9754),平均跳跃视野也相差无几。换句话说,结构化本身并没有提升预测的准确率——它带来的价值不在精度,而在正确性。自由文本通道即便预测得一样准,也无法做 Schema 校验、无法精确重放轨迹、无法从结构上保证预测不泄露给评估器。这些审计与隔离属性,才是结构化传输的核心价值;论文将其表述为由架构构造建立的能力,而非经过压力测试的安全保证。
Table 7

Table 7

第二个是验证有效性。
在全部回滚事件中,没有任何一次失败发生在格式或路由层面,所有回滚都触发自语义层面的评估风险与实证质量门。论文记录到 33 次回滚:L3 盲态评估风险拦下 6 次,L4 开发集实证质量拦下 27 次,L1 与 L2 均未拦截。这说明四层验证门不是在做形式主义的格式检查,而是真正在过滤质量不合格的推测结果;跳跃机制的安全边界,是建立在真实的质量校验之上,而非纸面规则。论文同时说明,这是 33 次回滚样本内的观察,并未据此推断被拒绝的状态一定会在样本外造成损失。
从这个角度看,VST 交出的不是一份「更高收益」的成绩单,而是一份「不牺牲预测精度、审计能力由架构建立」的基础设施答卷。
Table 8

Table 8

Table 9

Table 9

07 / 当 AI 量化走向合规,结构化传输会成为基础设施吗
如果用一句话总结 VST:它不是让多智能体更快地挖掘因子,而是让多智能体系统开始拥有可审计、可治理的通信底座。
过去阶段,自动化投研竞争的核心是搜索能力:谁能探索更多公式、生成更多候选、完成更多实验。但随着大模型和多智能体技术的普及,生成能力正在快速同质化。未来真正形成差异的,可能不只是系统能找到多少 Alpha,而是能否保证研究过程可追溯、可验证、可审计,能否在规模化运行的同时守住合规与安全边界。
VST 所探索的方向,正是建立这样一套持续进化的通信基础设施:发出去的消息有契约,跑过的轨迹可重放,推测的跳跃可验证,进化的路径相隔离。
当 AI 投研系统开始拥有自己的「结构化交互历史」——知道每一步交互的来龙去脉、每一次跳跃的验证过程、每一轮进化的边界约束——它与传统「脚本式自动化工具」之间的区别也会逐渐显现。
未来的 AI 投研系统,不只是一个更强大的搜索器,更是一种能够持续治理、可审计验证的研究基础设施。

本文基于 PandaAI 团队论文《VST: Verifiable Structured Transport for Auditable Agent-to-Agent Alpha Discovery》整理,不构成任何投资建议。
arXiv:https://arxiv.org/abs/2609.07065

【声明】内容源于网络
0
0
PandaAI个人量化超级助手
打破代码与数据壁垒,以 AI 驱动零门槛量化体验!无需代码即可轻松搭建多因子策略的量化智能体。
内容 90
粉丝 0
PandaAI个人量化超级助手 打破代码与数据壁垒,以 AI 驱动零门槛量化体验!无需代码即可轻松搭建多因子策略的量化智能体。
总阅读3.3k
粉丝0
内容90