

MoE 大模型规模越来越大以后,训练瓶颈已经不只是 GPU 算力。
一个 token 被 Router 分配给不同专家之后,需要在不同设备之间完成数据分发。专家并行规模越大,这部分 All-to-All 通信就越容易进入训练的关键路径。
更麻烦的是,现在的大规模 AI 集群本身就不是一张完全均匀的网络。
同一节点或者同一个高速互联域内部,GPU 之间通信很快。一旦跨出这个范围,带宽和通信成本可能明显变化。
这就带来了一个很直接的问题。
如果跨区域通信更慢,能不能只在慢链路上传一份数据,再利用高速区域内部的网络完成第二次分发。
两跳通信的思路并不复杂,真正困难的是判断它什么时候值得做。
因为多走一步同样意味着新的通信调用、数据重排和额外处理开销。网络层级不够明显时,两跳甚至可能比传统方案更慢。
最近,来自鹏城实验室、北京大学等机构的研究者提出了 TerraceMoE,并开源了配套的 TerraceMoE Simulator,其中包括北京大学博雅特聘教授、IEEE Fellow 田永鸿。
TerraceMoE 专门用来判断一台真实机器到底值不值得做层级两跳 MoE 通信,开源项目同时提供了 T-Route 路由约束、T-A2A 两跳 All-to-All 路径以及配套的通信成本模型。

更特别的是,TerraceMoE 还会验证自己的预测能力。
哪一级验证不过,对应层级的性能结论就直接停在那里,不再继续向更完整的训练性能外推。
01
不是所有MoE都该做两跳通信
TerraceMoE 首先解决的不是怎么把两跳通信做出来,而是什么情况下值得这样做。
传统 MoE 在进行专家分发时,如果一个 token 同时命中了目标区域中的多个专家,就可能需要通过较慢的链路发送多份数据。
T-A2A 改变了这条路径。
它先把跨区域发送的数据进行去重,只向目标区域发送一份,再利用区域内部更快的互联把数据分发给真正负责计算的专家。
核心思路就是少走慢链路,多走快链路。
这种设计看起来很自然,但它存在一个重要前提。
目标集群必须真的存在足够明显的网络层级。
如果区域内部和区域之间的通信速度几乎一样,两跳带来的额外调用和处理反而会成为新的负担。
TerraceMoE 因此没有直接宣称两跳通信更快,而是把快慢链路差距、通信调用开销、实际消息大小以及数据抵达后的处理成本都纳入判断。
换句话说,它想回答的是一件更实际的事情。
给定一台真实机器,两跳通信到底能不能赚回额外增加的那一步。

为了配合这种层级通信,项目还提供了 T-Route。
普通 Top-k 路由主要决定一个 token 应该进入哪些专家,T-Route 进一步约束这些专家分布在哪些通信区域中,同时控制每个选中区域承担的专家数量。
这样做以后,单个 token 跨区域访问的范围会被限制下来,通信模式也变得更容易预测。
不过限制 Router 的自由度也可能伤害模型质量。
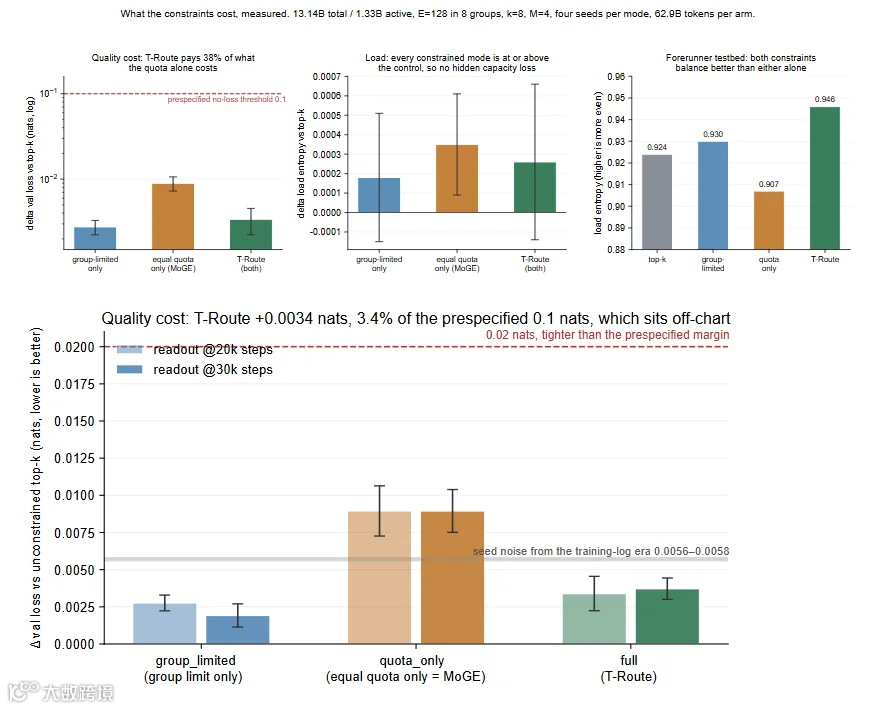
团队因此单独进行了训练实验,在 13.14B 总参数、1.33B 激活参数的模型实验中,T-Route 相比不受约束的 Top-k 路由,验证损失增加约 0.0034 nats。
这个差异并不是测不出来,而是作者在实验中确认它存在,但幅度较小。
这也是 TerraceMoE 比较克制的一点。
它没有把微小损失描述成完全无损,而是把通信收益和模型质量成本分开测量。
02
验证失败后,TerraceMoE直接
不让自己继续预测
TerraceMoE 最有意思的部分,其实不是成本模型本身。
而是它给这个模型增加了一套 validation gate。
简单来说,模型每向前预测一级,都必须先证明自己在这一层足够可靠。
项目先验证能不能预测一次通信调用的耗时,再尝试判断能不能进一步推到整个训练 step。
结果并没有全部通过,在通信调用层面,多组验证结果通过了项目预先设置的检查,因此 TerraceMoE 可以继续用于这一层的分析。
但进一步扩展到完整训练 step 后,验证失败。
于是项目采取了一个非常直接的处理方式。
step-level extrapolation 被锁住。
也就是说,即使某个通信实验看起来提升很大,TerraceMoE 也不会继续把它换算成整个模型的训练吞吐提升。
这和很多性能模型的做法不太一样。
通常模型在部分实验上失效后,论文可能只会增加一段局限性讨论。
TerraceMoE 则把边界直接做进项目,验证不过,就撤回对应能力。

项目甚至保留了自己的负结果,在一个网络结构接近平坦的 supernode 内部,团队进行了 7 组端到端对比。
结果显示,随着 token 数增加,两跳方案反而越来越慢。
这正好验证了项目最开始的判断。
没有明显网络层级的机器,本来就不应该强行使用层级两跳通信。
这组失败实验并没有被删掉,反而成为判断 TerraceMoE 适用范围的重要证据。

03
跨Supernode实测后,两跳通信
最高达到2.23倍
真正发生变化的是团队把测试范围扩展到 supernode 之间以后。
此前的实验主要发生在一个 supernode 内部,这里的网络几乎是平坦的,实测快慢链路差距只有约 1.03 倍。
这种环境本身就没有多少慢链路可以被优化。
后来团队继续测量不同 supernode 之间的网络边界。
两组跨 supernode 测试得到的层级差距分别达到 5.10 倍和 7.51 倍。
这一次,两跳通信终于进入了它真正针对的环境。
团队随后直接比较传统 one-hop 与 T-A2A two-hop。
在 128 ranks、跨两个 supernode 的测试中,现有实现下四组配置全部由两跳方案胜出。
其中最低为 1.43 倍,最高达到 2.23 倍。
不同配置下另外两组结果分别达到 1.77 倍和1.65 倍。
这也是 TerraceMoE 项目目前第一次在真正具有明显层级结构的网络上,测到两跳方案全面胜过 one-hop。

不过这里有一个非常重要的边界,这些数字对应的是通信调用层面的 one-hop 与 two-hop 对比。
它们不能写成 MoE 训练速度最高提升 2.23 倍。
原因很简单,前面的 step-level validation gate 还没有通过。
所以即使拿到了更漂亮的数字,项目依然没有越过自己设定的验证边界。
这也让 TerraceMoE 的定位变得更加清楚。
它并不是一个声称可以让所有 MoE 训练更快的通信框架。
它更像是一套部署前的筛选工具,先判断你的集群有没有必要做层级通信,再告诉你现有证据最多能够支持到哪一步。
对 AI Infra 来说,这一点可能比单纯再做一个更快的 All-to-All 更实际。
真正修改 MoE 通信栈之前,团队往往需要投入大量工程资源。
如果能提前知道目标机器的网络层级根本不够明显,那最好的优化可能不是继续写 Kernel,而是什么都不要改。
而当网络真的存在明显层级时,TerraceMoE 又给出了目前最高 2.23 倍通信调用性能优势的实测结果。
更重要的是,它同时保留了失败实验、错误修正记录和仍然没有通过的 validation gate。
一个性能模型不需要永远正确,但它至少应该知道自己什么时候不能继续下结论。
这或许才是 TerraceMoE 最值得关注的地方。
END
关注+星标,获取AI前沿进展与开源一线动态