

2022年末,ChatGPT引爆大模型热潮。此后三年,业界焦点始终在于能力上限。然而步入2026年,大模型的评价体系正发生深刻转变。
Google密集迭代Flash,OpenAI为GPT-5.6划分多个档位并大幅降价,Anthropic发布的Claude Opus 5.5也将“效率”置于核心,成本下降40%、速度提升30%。这意味着,全球大模型竞争已从单纯追逐能力上限,全面转向“效率竞赛”。
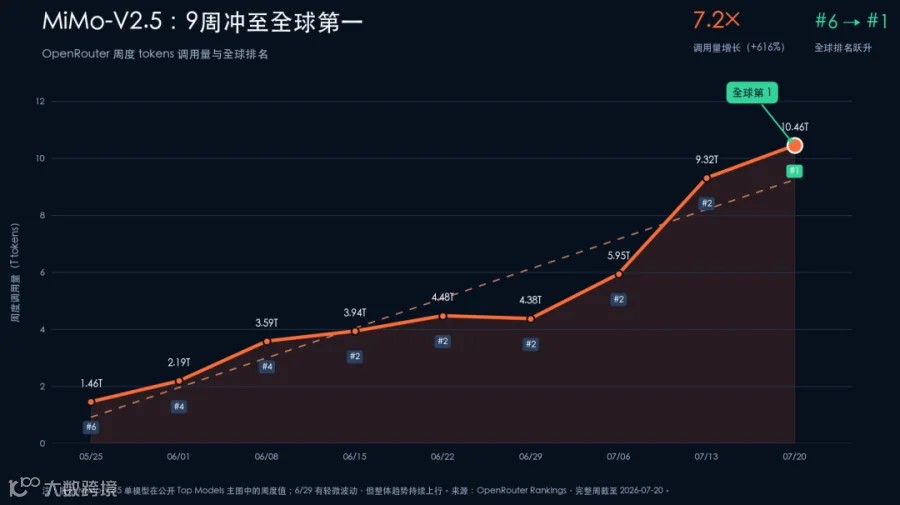
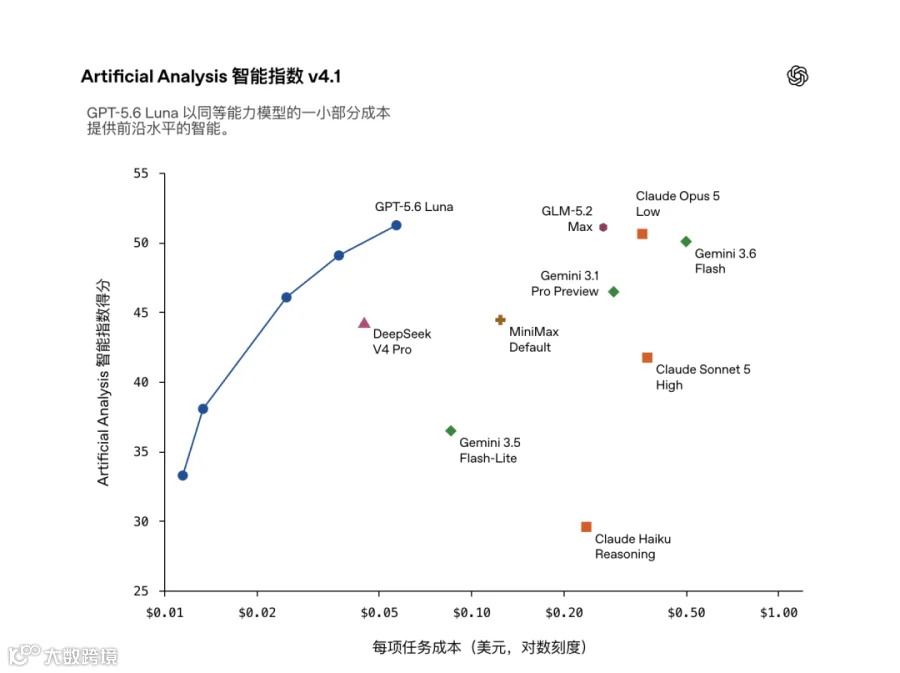
行业开始用“智能—成本”帕累托前沿(Pareto frontier)来衡量这一变化:在能力相当的情况下,成本更低、速度更快的模型将占据主导,无法兼顾效率的模型将跌入“斩杀线”以下。真实数据印证了这一点:2026年6月,中国模型在OpenRouter的调用量已超越美国模型,其中MiMo-V2.5发布两个月后调用量暴增约616%,一度登上周榜和月榜第一。
如今,这一路线推进至MiMo V2.6。9月22日,小米正式发布并开源MiMo-V2.6-Pro和MiMo-V2.6-Flash,并提供高速模式,精准覆盖高频Agent、复杂专业任务及低延迟实时场景。在Artificial Analysis Intelligence Index评测中,MiMo-V2.6-Pro以46分位列国产及全球开源模型第一,与GPT-5.6 Sol仅差1分。
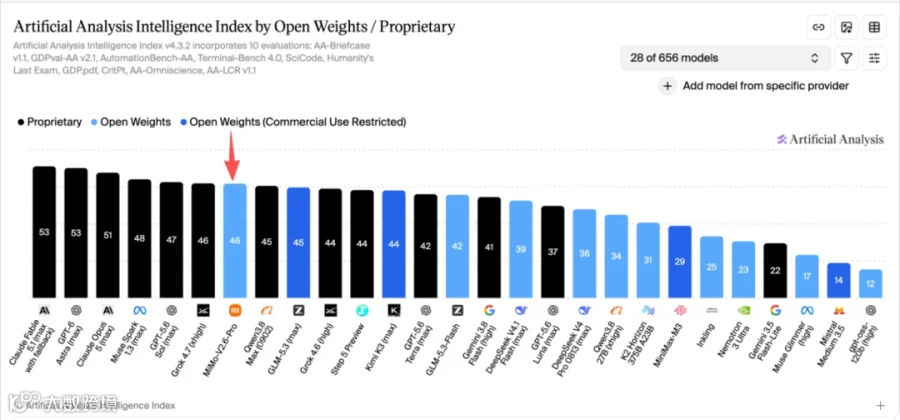
相比之下,同期发布的Grok 4.7在同等智能水平下,单任务成本高达2.73至3.74美元,是MiMo-V2.6-Pro(约0.13美元)的21至29倍。在“智能—成本”维度,MiMo V2.6展现出压倒性的效率优势。

从军备竞赛到效率竞赛
当大模型接入生产环境,成本敏感度成为首要考量。随着模型深入Coding、Agent、企业软件等场景,调用从偶发行为转为持续的基础设施成本。“单位智能成本”由此成为竞争核心。
MiMo V2.6延续了精细化分层策略:
- Flash:主打高频调用,重点服务Agent和Coding;
- Pro:承担复杂Coding、长程Agent及多模态理解等高价值任务;
- Ultraspeed:面向实时交互,最高输出速度达1000 TPS。
该系列支持全模态输入,能力聚焦Coding、Agent、Design、Research及Cyber安全。从数据来看,MiMo-V2.6-Pro的Intelligence Index从上代的26分跃升至46分,提升约77%,且单任务成本仅0.13美元,约为海外同等模型的1/20至1/60。

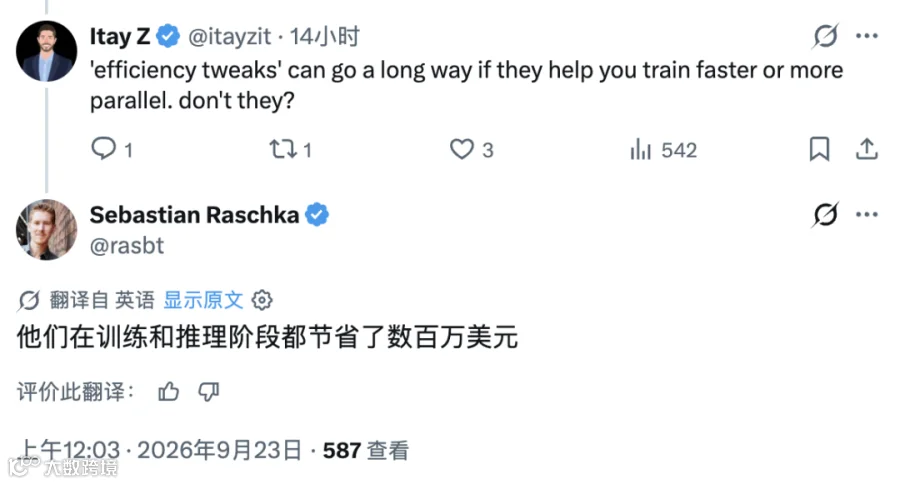
这种极致的效率并非仅靠降价实现。机器学习专家Sebastian Raschka评价称,MiMo V2.6在训练和推理阶段的工程优化,“能省下数百万美元”。
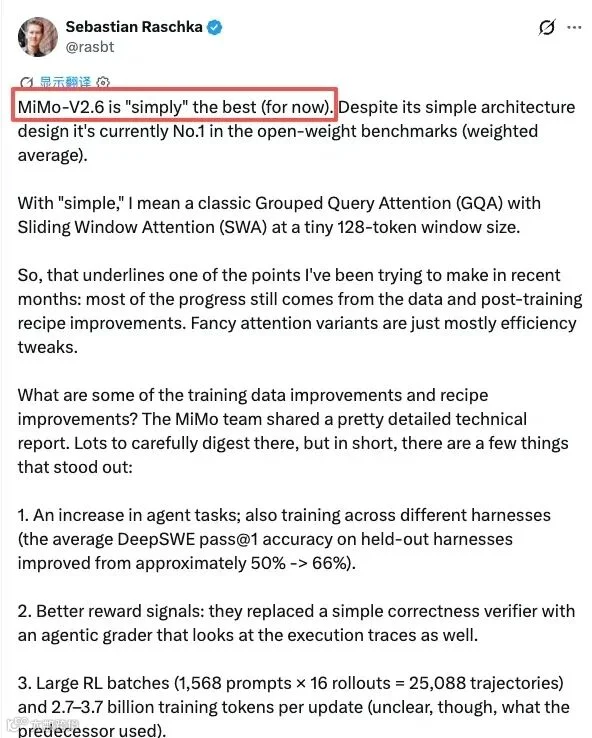
MiMo V2.6的技术核心在于Agentic Reinforcement Learning(代理强化学习)的规模化。模型通过多轮尝试与反馈,在代码库、浏览器等真实环境中提升任务完成度。团队引入了GRS和GAR等创新评分机制,将实现质量、行为质量及防欺骗检测纳入训练信号,使模型输出更贴近工程实践。
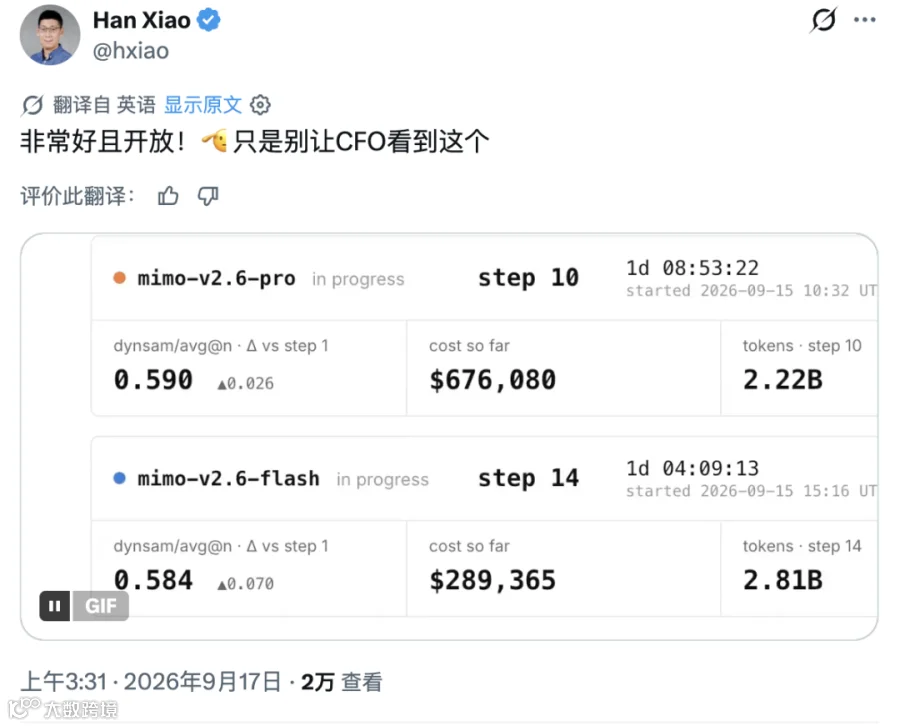
单位智能成本的下降,源于模型架构、训练环境、评分机制和推理系统的全面优化。9月中旬,MiMo团队公开了实时训练看板,将token消耗、累计成本与能力指标透明化,让“效率”从抽象概念转化为清晰的投入产出表。
对于小米而言,技术上的效率优势正加速转化为商业规模。MiMo-V2.5调用量激增616%证明,极具竞争力的“智能—成本”组合,已成功推动真实工作负载向MiMo迁移。
聪明只是起点,完成任务才产生价值
在真实生产环境中,商业结果比token用量更关键。成功完成一项任务的总成本,才是与商业价值最贴近的指标。
MiMo最新的Token Plan已直接量化任务产出:Pro套餐对应约1400个中高复杂任务。这种以“任务”为核心的评估方式,正成为行业新共识。模型价值 ≈ 任务成功率 × 速度与稳定性 ÷ 完成任务的总成本。
这对长程Agent尤为重要。单次推理的价格差,在几十上百轮的任务执行中会被成倍放大。当成本降至临界点以下,大量低价值、高频工作将被纳入自动化范畴,从而扩大增量市场。

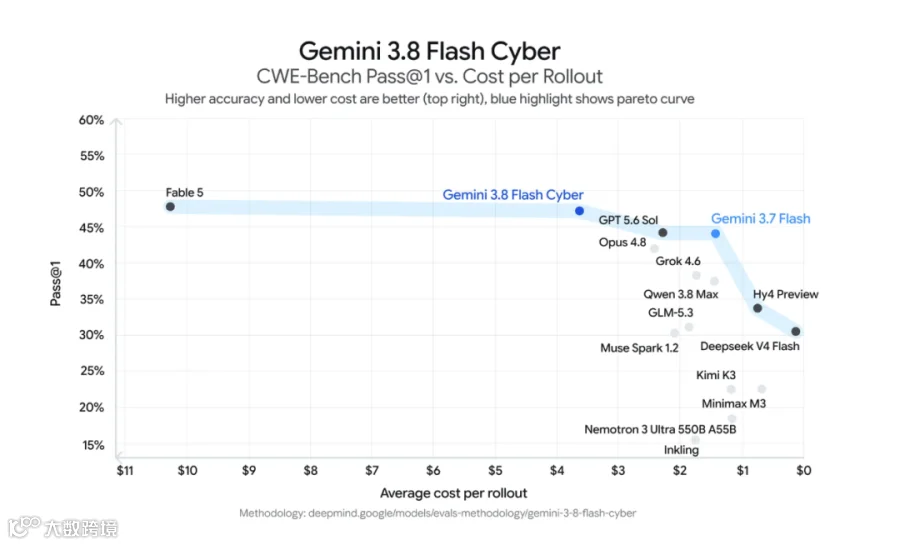
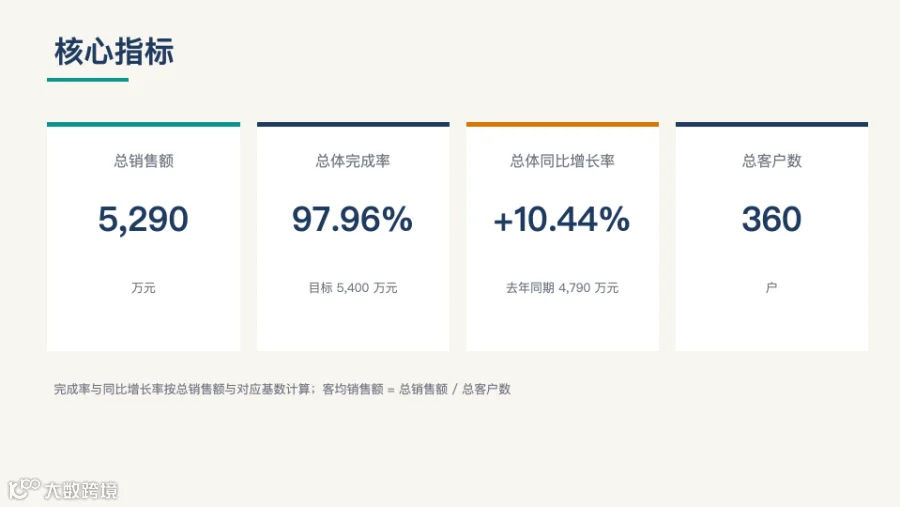
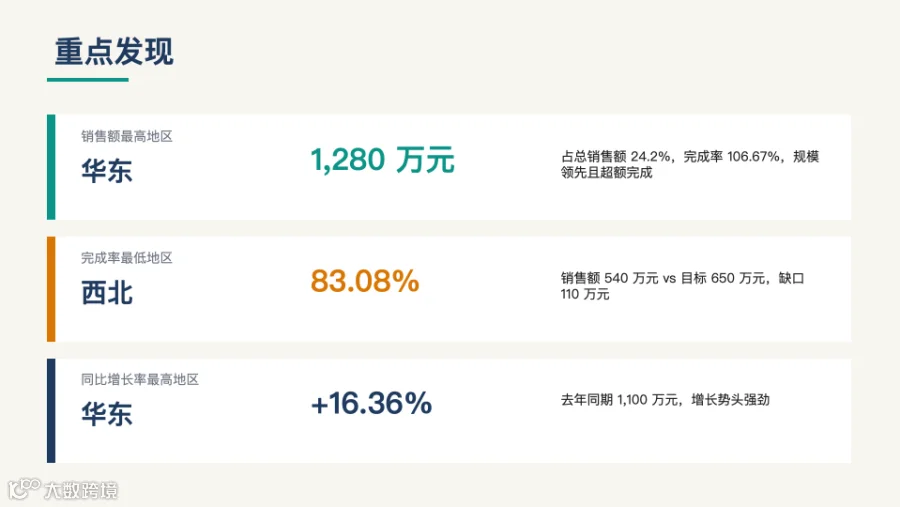
底层模型之上,小米的产品矩阵正致力于“把一件工作做完”。MiMo Desktop在CUA(Computer Use Agent)任务实测中表现出色:不仅能准确生成Excel、PPT和PDF,还能独立推算出“同比增长率最高地区”。在复杂的股票估值任务中,成功打通了财务建模、汇报制作与PDF交付的全流程。


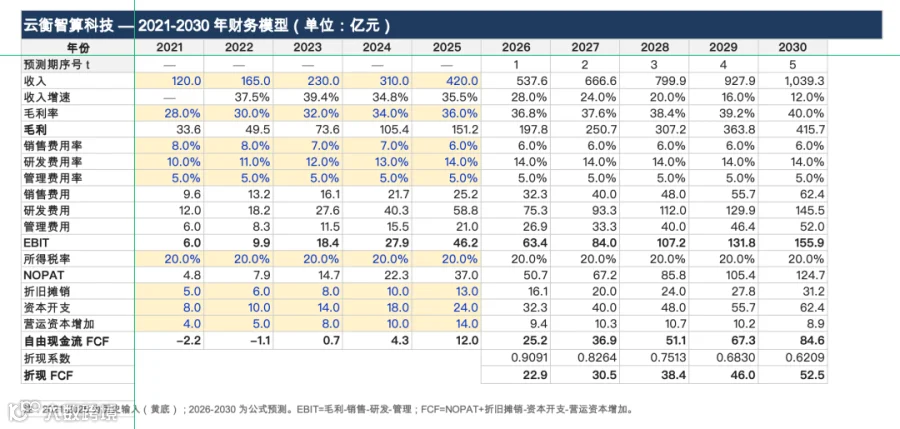
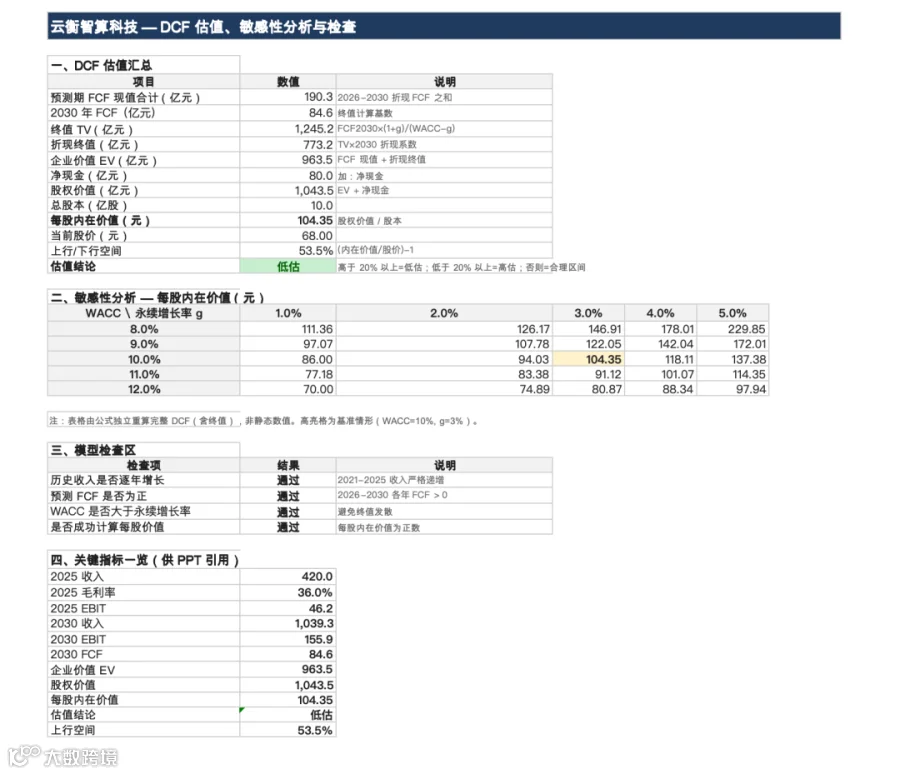

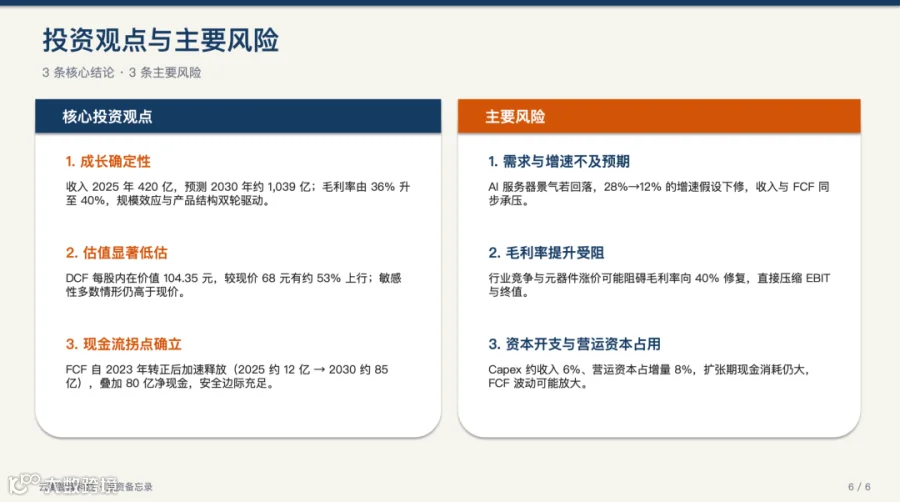
在更开放的交互环境中,MiMo利用Three.js生成了高完成度的3D夜间游乐园场景,涵盖城堡、摩天轮、灯光秀及多视角切换,验证了其在空间建模与前端实现上的综合能力。这些实测将“智能×成本”从抽象指标,转化为用户可直观体验的任务交付结果。
谁离最终结果更近,谁可能拿走更多价值
当竞争单位延伸至“完整工作”,价值分配逻辑将发生重塑。基础模型通过规模化调用获利,而掌握企业数据、客户关系和Workflow的产品,将离付费结果更近。
价值分配正沿着这条路径移动。对小米而言,MiMo V2.6提供底层智能,MiMo Code、Claw、Desktop在软件层吸收能力,最终触达手机、汽车及全屋智能设备。模型效率得以在小米的长价值链中传递。
这也赋予了“斩杀线即价值分配线”更实际的意义:MiMo凭借“智能—成本”前沿优势吸引调用,并随着调用深入Agent和工作流,将商业价值沉淀于自身的软件与终端生态中。
大模型公司的新价值锚
在商业化深水区,大模型公司的价值需通过多条曲线综合衡量:
一是单位智能成本下降的斜率。MiMo-V2.6在Intelligence Index达46分的同时,单任务成本控制在0.13美元。持续降低单位智能成本,意味着公司正不断扩大可商业化的任务边界。
二是需求曲线。MiMo-V2.5调用量暴增616%证明效率能影响开发者选型。未来的关键是将一次性尝鲜转化为长期的Task volume。
三是任务转化。随着Token volume沉淀为Task volume,模型公司的收入模式将从“卖算力”向“卖生产力”演进。
四是资本效率。小米公开训练看板优化投入端,同时通过Miloco 2.0等产品将底层能力复用至全屋智能等终端。一笔基础模型研发投入,若能被更多任务和终端共同摊薄,其资本效率将呈指数级放大。

最强定义上限,效率决定规模
前沿模型将继续刷新智能天花板,但商业世界更迫切需要的是高性价比的生产力工具。真正能形成大规模调用的模型,必须同时跨过两条线:能力足够完成工作,成本又低到可以被高频消费。
MiMo V2.6将“智能—成本”前沿向外推进一步,并通过小米终端生态将智能注入真实任务。最强模型定义上限,而效率决定规模。“斩杀线”的商业意义正日益清晰,它将重新划分AI产业链最核心的收益归属。