

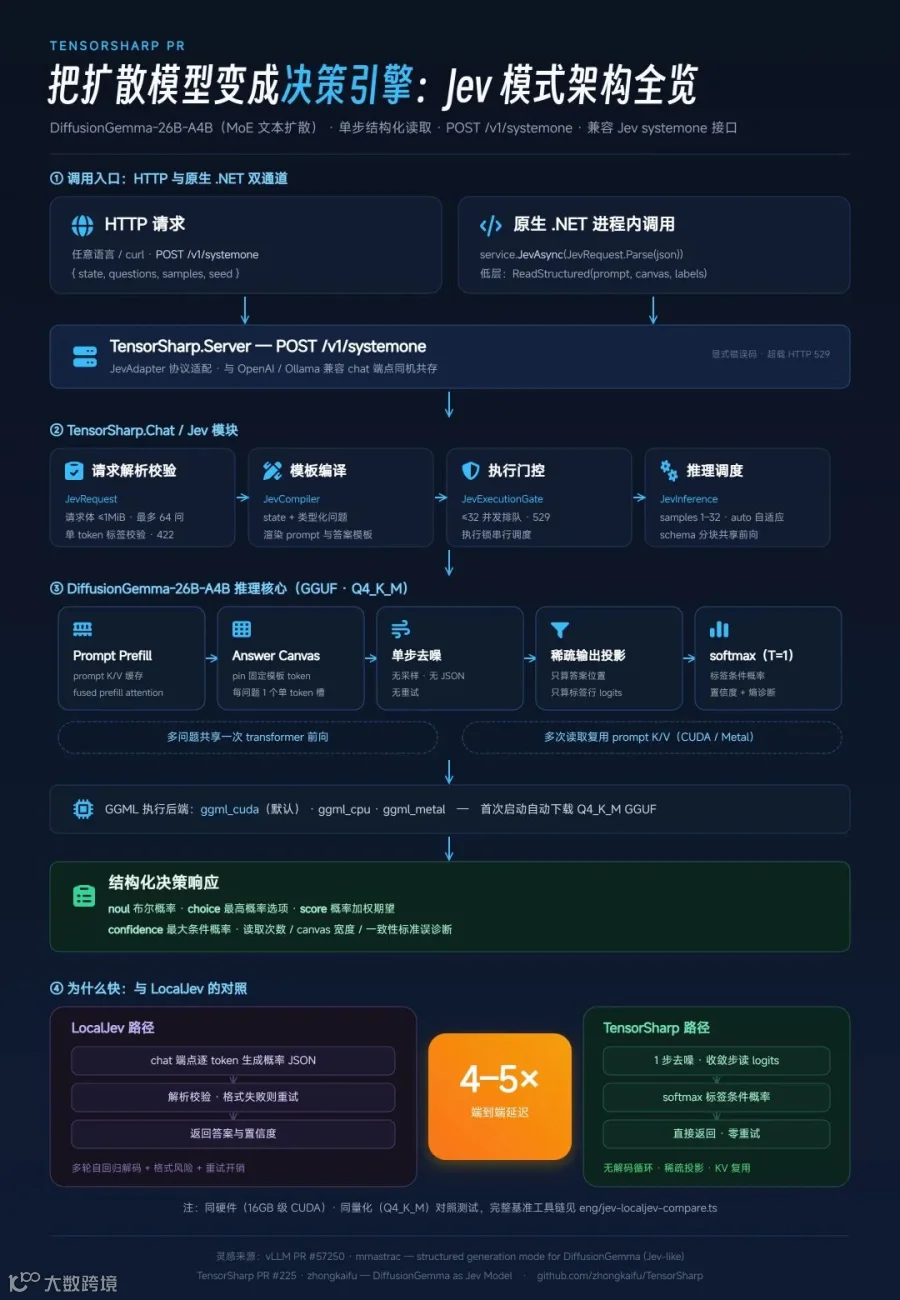
2026年9月22日 vLLM 合并了 PR #57250,给 DiffusionGemma 加了一种 Jev 风格的结构化读取模式。我们跟得很快,TensorSharp PR #225 今天也合并了:纯 .NET 原生推理引擎现在可以直接跑 Jev 模式,模型用的是 Google 的 DiffusionGemma-26B-A4B(26B 总参数、约 3.8B 激活的 MoE 文本扩散模型)。HTTP 和原生 .NET 代码都能调,接口兼容 Jev 的 systemone 协议,同硬件对比 LocalJev 快了 4–5 倍。
先说 Jev 是什么
Jev 是 Typesafe.ai 提的一条“决策模型”路线,不做开放式生成,只回答有边界的结构化问题:是/否(Jev 里叫 noul)、多选、评分。调用方给一段状态(state)加一组带类型的问题,模型返回每个答案的概率和置信度。
本地能跑的开源实现是 GitHub Next 的 LocalJev。它的做法是:让普通 chat 模型把概率值当 JSON 文本生成出来,然后校验、解析,格式不对就重试。能跑通,但为几个数字要扛下整条生成管线的开销——逐 token 自回归、JSON 语法风险、解析失败重试,延迟和不确定性都被放大了。
DiffusionGemma 这类文本扩散模型给了另一条路:它的输出本来就是一个可以预先固定住大部分 token 的 canvas。vLLM PR #57250 的思路很直接——把答案位置留成单 token 的槽位,只做一步去噪,从收敛步的 logits 里读出各候选标签的概率。不采样,不生成 JSON,不重试。PR 作者的原话是,DiffusionGemma 可以被当成一台“经过校准的选择题机器”。
TensorSharp 里是怎么落地的
PR #225 一次提交了 40 个文件、+4173 行,核心几块:
TensorSharp.Chat/Jev/:请求解析校验(JevRequest)、模板编译(JevCompiler)、并发门控(JevExecutionGate)、推理调度(JevInference); POST /v1/systemoneHTTP 端点:Jev 兼容协议适配器,和同一服务器上的普通 chat 端点共存; DiffusionGemmaModel.ReadStructured(...)低层 API:构造答案 canvas,单步读取指定标签的 logits; -
稀疏输出投影:只算答案位置和请求词汇行的 logits,不再分配完整的 canvas×词表张量; -
一整套基准和对比工具( eng/jev-benchmark.py、eng/jev-localjev-compare.ts等),外加 293 行的文档docs/models/jev.md。
两点澄清:jev-latest / jev-preview 只是所加载 DiffusionGemma 模型的 API 别名,不是独立 checkpoint,更不是 Typesafe 的托管 Jev 模型;模板逻辑参考了 LocalJev(Apache-2.0,NOTICE 里已署名),但数值上和谁都不承诺对齐。
怎么调
HTTP
启动(Q4_K_M 量化 + CUDA 为例):
$env:TENSORSHARP_MODELS = 'C:/Works/models'
$env:DIFFUSION_VRAM_HEADROOM_MB = '4096'
$env:MAX_CONTEXT = '4096'
dotnet run --project TensorSharp.Server.Host -c Release -- --config config/jev-diffusiongemma-q4.json
一条 curl 就行:
curl  http://127.0.0.1:5000/v1/systemone \
-H 'Content-Type: application/json' \
  --data-binary @docs/examples/jev-ticket.json
最小请求:
{
  "model":"jev-latest",
  "state":"I was charged twice for the same subscription this month.",
  "questions":{
    "billing":{
      "type":"noul",
      "instructions":"Is this a billing issue?"
    }
  },
  "samples":1,
  "seed":42
}
返回里 answers.billing.noul 就是“是计费问题”的概率。
原生 .NET
引用 TensorSharp.Chat,进程内直接调,不过 HTTP:
using System.Text.Json;
using TensorSharp.Server;
using TensorSharp.Server.Jev;

using var service = new ModelService();
service.LoadModel("C:/Works/models/diffusiongemma-26B-A4B-it-Q4_K_M.gguf",
  mmProjPath:null, backendStr:"ggml_cuda");

using var json = JsonDocument.Parse(File.ReadAllText("docs/examples/jev-ticket.json"));
object response = await service.JevAsync(JevRequest.Parse(json.RootElement));
Console.WriteLine(JsonSerializer.Serialize(response));
想再底层一点,可以直接用 DiffusionGemmaModel.ReadStructured(promptTokens, seedCanvas, positions, tokenIds) 自己控制 canvas;服务层帮你处理分词、模板渲染、上下文检查、canvas 构造、序列化和生命周期安全,一般用不着下沉到这个层级。
接口能干什么
|
|
|
|---|---|
|
|
noul
choice(多选)、score(评分,返回概率加权期望)
|
|
|
|
|
|
samples
auto 模式下条件熵超阈值自动追加读取(上限 32)
|
|
|
chunk_rows 分块,多题共享一次 transformer 前向
|
|
|
|
错误处理比较工程化:schema 非法返回 422,未知模型 404,模型不可用 503,排队超限 529,请求体超限 413,不会出现挂着等超时的情况。
为什么快 4–5 倍
和 LocalJev 的对照测试里(相同 state、相同问题集,对比工具会把 LocalJev 的提示词构造、推理、JSON 校验和重试全部计入耗时),TensorSharp 快了大约 4–5 倍。这个差距是结构带来的,不是某个黑科技:
- 不做生成,只做读取。
LocalJev 让模型把概率 JSON "写"出来,TensorSharp 在一步去噪后从 logits 里直接"读"——数学上等价于从完整词表分布里取出相同标签再归一化,但整条解码循环省掉了。 - 稀疏输出投影。
输出头只算请求的标签行,显存和算力都花在刀刃上。 - 无解析、无重试。
LocalJev 要为格式错误的 JSON 付重试成本,这条路径上没有这个故障模式。 - prompt K/V 复用。
自适应多次读取共享同一份前缀缓存,追加读取的边际成本很低。
前提也要交代清楚:数字来自特定硬件(16GB 级 CUDA GPU、Q4_K_M 量化)和特定负载。官方文档专门提醒过,vLLM 原型在 DGX Spark 上公布的数据、LocalJev 在 M5 Max 上公布的数据,都不能直接拿来当同硬件对比。量化位数、问题措辞、答案顺序、读取次数都会影响结果。
哪些事它明确不做
- 只支持单 token 标签。
候选项必须映射到单 token("moderation_spam" → "A" 这种变换由编译器自动完成并校验);多 token 候选项、图片输入、问题间依赖链、多步去噪、think 模式一律显式拒绝。 - 置信度不是校准过的正确率。
返回的是条件概率和熵诊断,建议在自己的留出样本上评估后再定阈值。 - 可复现性以运行时为界。
seed 保证同一 .NET 运行时/后端下可重复,不承诺和 Python 噪声逐位一致。 - 普通 chat 端点不受影响。
Jev 请求和普通扩散 chat 共享模型执行锁串行调度,同机混部是安全的。
相关链接
-
TensorSharp PR:https://github.com/zhongkaifu/TensorSharp/pull/225 -
完整文档: docs/models/jev.md(请求字段表、概率语义、基准方法都在里面) -
模型 checkpoint: google/diffusiongemma-26B-A4B-it(Apache-2.0),社区 Q4_K_M GGUF 首次启动自动下载 -
灵感来源:vLLM PR #57250(https://github.com/vllm-project/vllm/pull/57250 )
从“让模型写 JSON”到“从 logits 里读答案”,Jev 模式做的事其实就一件:把决策问题还原成它本来的样子——有边界的概率读取。vLLM 开了头,TensorSharp 把这条路在 .NET 生态里走通了。本来就在用 C# 做本地推理的同学,现在一条 HTTP 请求或者一个 JevAsync 调用,就能在本地放一台毫秒级响应的决策引擎。