


一、先搞清楚:Jev到底是个什么东西?
如果你仍用 ChatGPT 的思维来理解 Jev,那从一开始就偏离了本质。
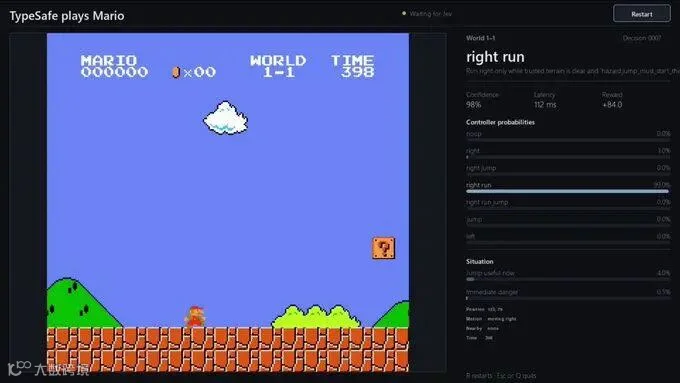
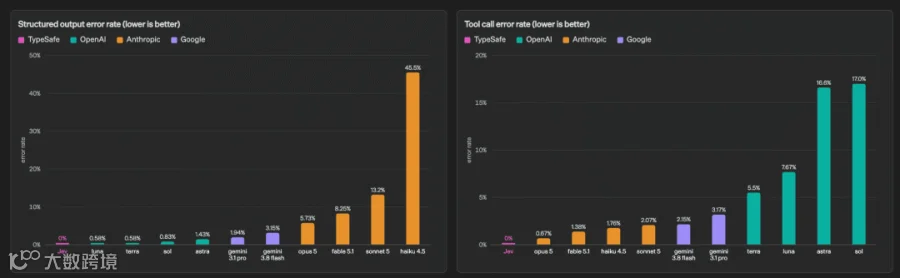
ChatGPT 是“会写文章的生成式AI”,而 Jev 是“只做选择题的判别式AI”。你无需与它对话或让它写方案,只需提供两样东西:当前状态(如游戏画面、客服工单、玩家行为数据)和一组预定义选项。它会秒回答案,并附带每个选项的概率,代码可直接调用结果。
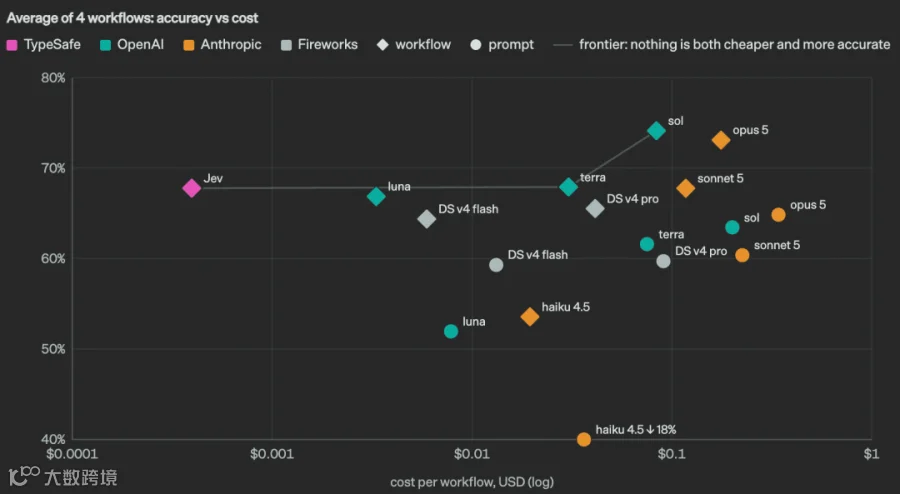
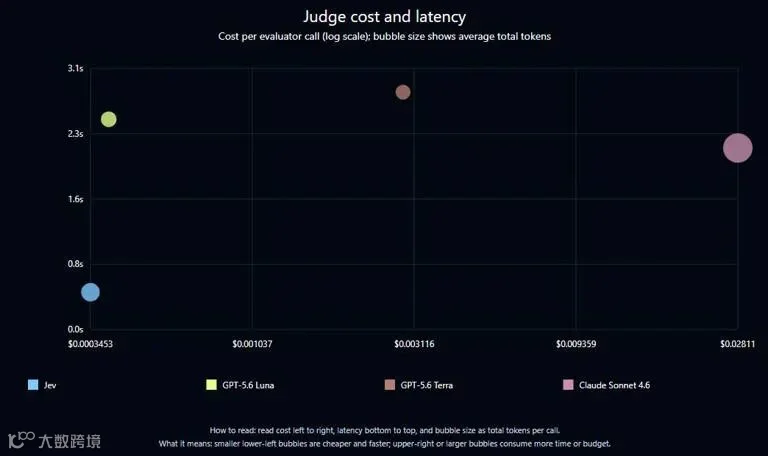
其延迟介于70至500毫秒,每百万输入Token仅需0.042美元,输出完全免费。单次决策成本约0.0004美元,比传统大模型便宜两到三个数量级。
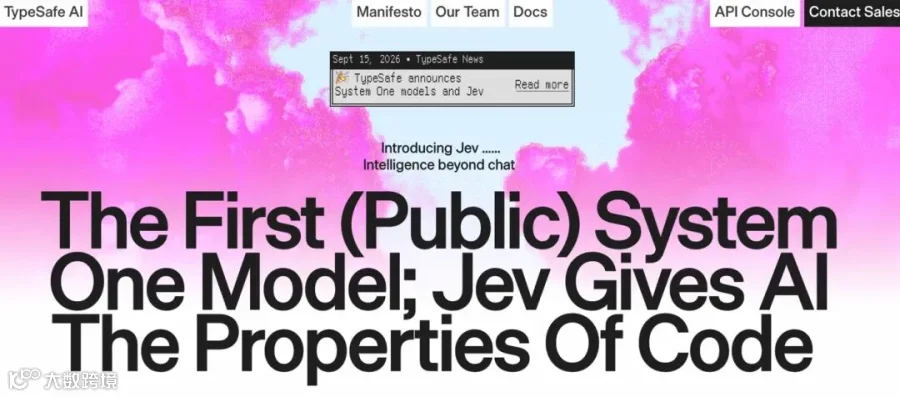
Jev 的创始人 Diogo Almeida 是前 OpenAI 研究员,也是 InstructGPT 和 RLHF 论文的主要作者(ChatGPT早期对齐技术的核心成员)。他离开 OpenAI 后思考了两年:大模型已如此聪明,为何大多数工作仍未被自动化?Jev 就是他的答案。
二、游戏圈已经玩疯了:这些案例和想象的不太一样
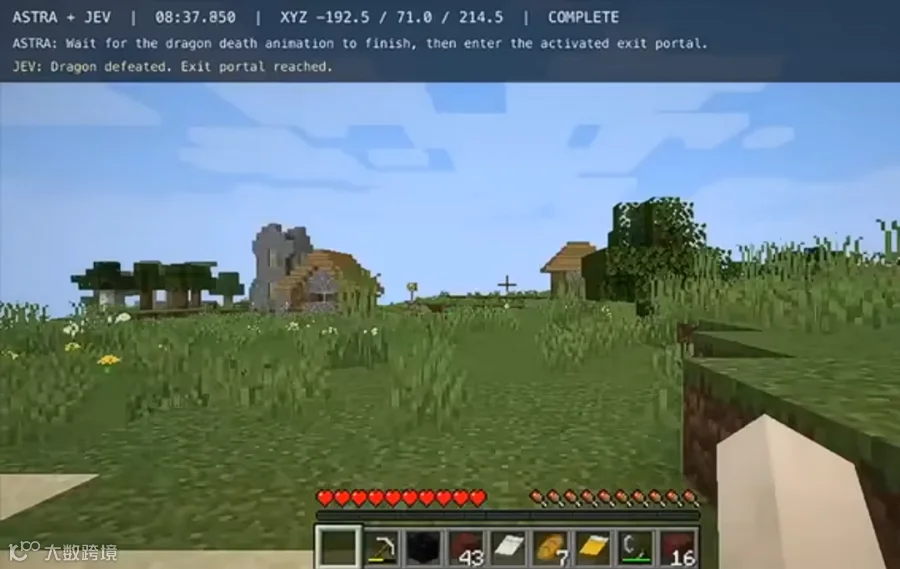
组队速通《我的世界》末影龙(8分43秒,成本不足1美元):开发者将 Jev 与 GPT-6 Astra 结合——Astra 负责宏观规划的“军师”,Jev 负责瞬时判断的“打手”。全程131次 Jev 决策加35次 Astra 调用,Jev 仅耗资0.01美元。两者在后台无缝协同,确保游戏全程流畅。
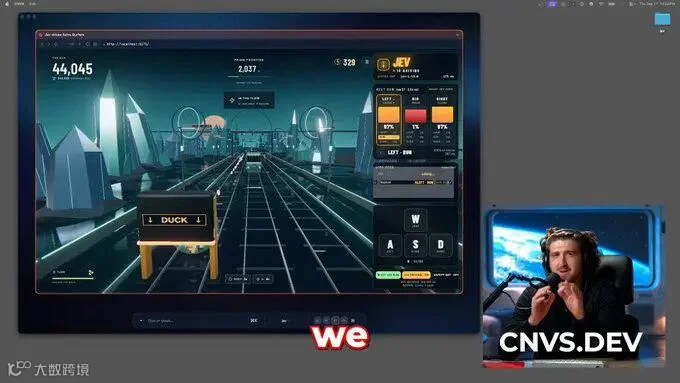
50局《地铁跑酷》并发,总花费不到1美分:Jev 同时操控50局游戏,处理换道、跳跃等高频小判断。速度从25米/秒飙升至48米/秒且全程无伤,50局总成本不足一分钱。
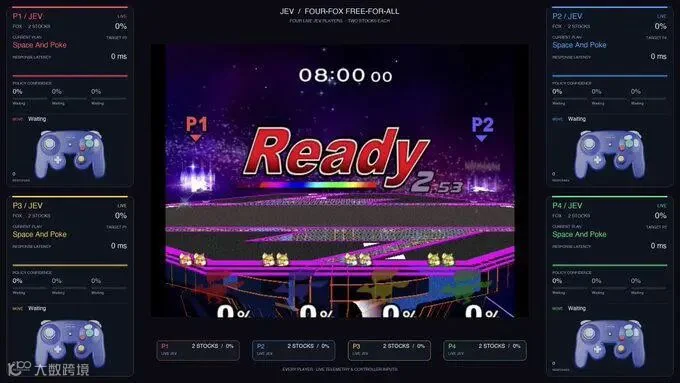
Jev 自我对战《任天堂明星大乱斗》:单模型同时控制4个角色并打出不同战术,单场消耗2200万 Token,仅需几美分。
《皇室战争》实时对战(单次决策135毫秒):通过ADB串流和OpenCV识别状态,Jev 每秒进行策略、手牌、落点三次独立判断。每场约150-200次请求,成本约0.004美元。(注:此为违反官方条款的研究项目,旨在观察决策模式)。
《星际争霸》原版战役(421次决策通关):通过独立 harness 控制1998年版星际,Jev 以421次决策完成“Strongarm”任务,中位延迟382.95毫秒。

《Brotato》清关(Jev管走位,Claude管策略):分层架构下,Jev 以7Hz频率处理移动,Claude 处理升级与购买决策。首次完整通关(20波)于2026年9月19日达成。
与 Claude Haiku 打俄罗斯方块(快4倍、便宜24倍):Jev 与 Haiku 4.5 准确率相近,但 Jev 平均19秒通关(Haiku需80秒),且成本仅为对方的 1/24。
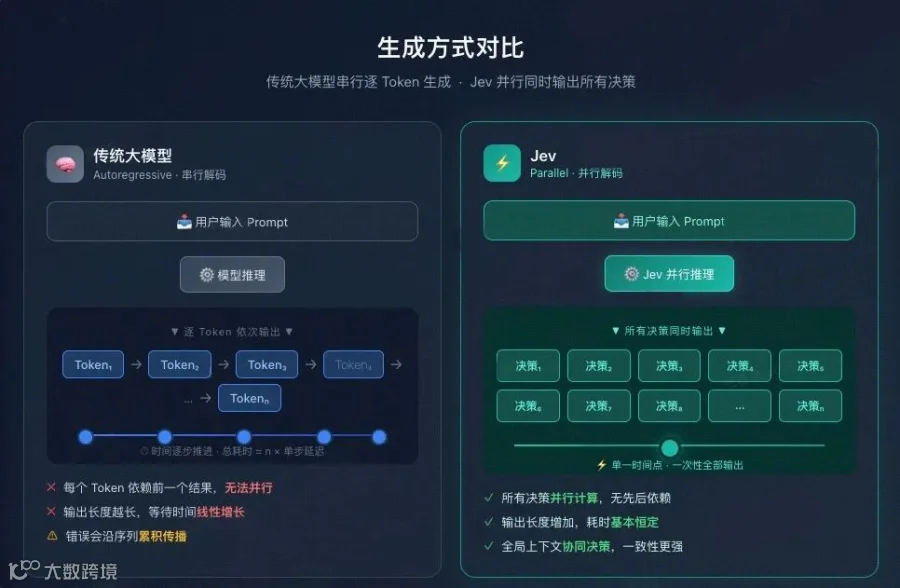
三、拆解:Jev 是怎么工作的
1. "系统一"不是一个比喻,是一个产品定义
- 选择题:从最多 255 个预定义选项里挑一个;
- 打分题:给一件事打 0-5 或 1-10 的分;
- 是非题:回答 Yes/No,并给出置信度。
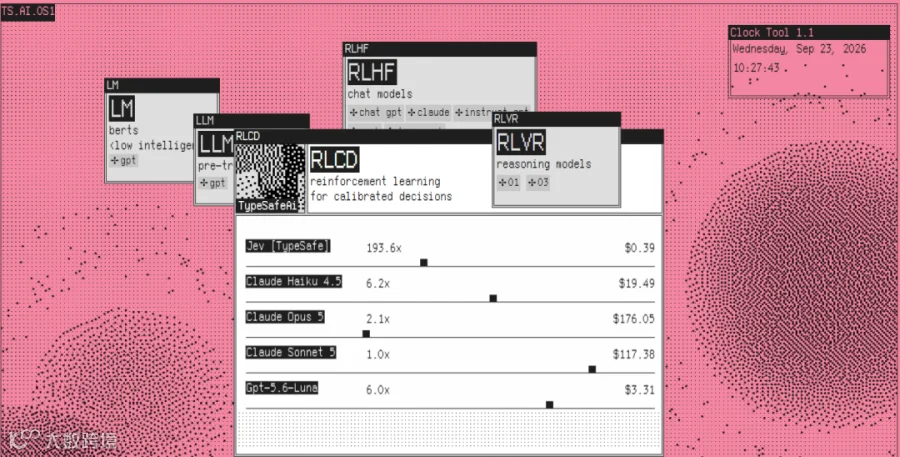
2. 为什么能做到毫秒级、输出免费

3. 核心亮点:输出的“概率”为何比答案更值钱
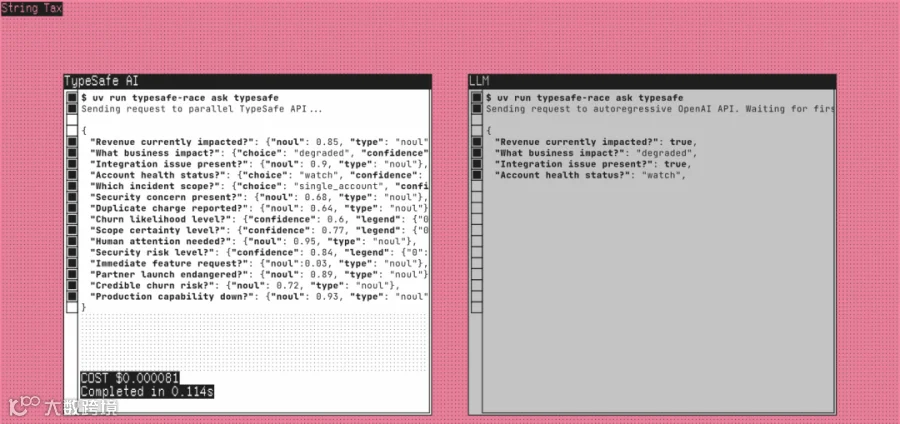
4. 什么任务值得交给它
高频:调用量大才能摊薄成本。
选项有限且可枚举:必须是“在候选中选一”的封闭式任务。
错误成本不对称且可控:误判成本低,漏判成本高(需机器初筛+人工兜底)。
有历史数据可回测:利用已处理数据跑测误分率与自动处理率,避免上线后拿用户当测试员。
只要此值明显低于人工处理成本,该环节即具备自动化价值。Jev 等模型改变的正是不等式本身。单次判断的期望损失 = 错误概率 × 错误造成的损失
四、游戏运营里,Jev能顶什么用?

1. 客服工单分流
现状:多依赖关键词正则+人工,正则对黑话和口语极度脆弱。
解法:将工单与玩家画像作为上下文,让模型在客服组列表中匹配。难点在于选项集设计:客服组名称及描述需清晰易懂,切忌使用无描述的内部黑话。
回测与指标:用历史工单对比匹配率。关注自动分流占比、误派率(需区分紧急/普通误派方向)、响应时长。

2. 高危客诉拦截
3. 评论与舆情结构化
4. 社区内容第一道闸门
5. 反作弊前置筛选
6. 运营活动的实时干预
7. 买量素材初筛
五、玩家体验侧:三个值得立项推演的技术方向
NPC 决策重新建模:传统行为树成本高。Jev 可实现“局面特征 → 策略库选择”架构。将玩家距离、血量等作为特征,模型实时选策略,成本极低且选项由策划掌控。
AI 模拟玩家测试:单局成本以美分计,测试量呈指数级增长。核心价值在于长尾覆盖:机器跑万局可摊平人类测试员难以遇到的边缘Bug分布。
UGC 内容预检:海量、高频的地图名/聊天短语审核,本质是分类问题。自动闸门成本趋近于零后,将大幅释放运营人力。

六、架构视角:为什么“决策前置”会变成行业标配
七、泼冷水:五个真正的坑
第一,分布外输入上的自信错误。校准性仅在训练分布内成立。遇新型客诉或黑话可能自信出错。需持续回收“无把握”样本并定期回测。
第二,选项集设计即产品决策。选项集遗漏或描述含混会导致随机选择。需将选项集视为需评审和版本管理的核心资产。
第三,领域适配非零成本。游戏黑话需上线前用小规模真实数据评测,必要时使用 few-shot 或微调进行领域校准。
第四,概率校准 ≠ 决策正确。置信度只能量化“已知的不确定”,无法弥补选项集遗漏正确选项的结构性错误。
第五,早期供应商风险。Jev 仍处早期阶段,API稳定性与价格存变数。务必进行“可替换设计”,避免系统架构与单一供应商深度绑定。
八、落地路线图:一个低风险的试点方法
- 第 1-2 周(筛场景):按四条件筛选,优先选有历史数据、错误成本低的场景(如工单分流)。
- 第 3-4 周(历史回测):利用数月历史数据跑测,获取误分率、自动化率及置信度分布。
- 第 5-8 周(小流灰度):设定保守阈值(如>90%自动处理),旁路运行+人工兜底,对比核心指标。
- 第 9 周起(持续调优):按周调整阈值与选项集,将“改阈值”作为严谨的工程动作。

阅读推荐
(点击文字即可跳转到文章)
月收入超6亿美元,下载1.44亿次!Casino五大“印钞机”品类:捕鱼、中东卡牌、扑克、Slots、Bingo,出海该押注谁?
Evolution年收$2.25亿净赚$1.15亿、Aristocrat年收$4.2亿净赚$1.01亿、Flutter年收$16.4亿倒亏$4亿——RMG的钱都被谁赚走了?
Calm年收$1.41亿、Finch年收$22.7M、Bible Chat月收暴涨5倍...千亿美金情绪价值赛道,16款头部产品深度拆解
6500万销量的《巫师3》白送!《最终幻想7》全平台同步!14款国产游戏亮相科隆——2026开幕夜太狠了
7月Casino/Bingo 11款头部产品深度分析:$51.82M月收、下载+10.9%、RPD-5.6%
2878亿美元的全球casino市场里,中国团队正悄悄拿走44-45%的移动收入