


最近2个月做 Meta 买量的人,大概率都碰过几件怪事:同一个广告组里5条素材,90%预算却集中到一条;CTR、CVR 都不错的素材,死活拿不到量;老爆款突然断量,换条看起来普通的素材反而续上。
很多投手的第一反应是:Meta 又TM改算法了!
这个判断对,但不够准。Meta 这两年改的不是某个小算法,而是整条广告分发逻辑。
真正变化的,是 Meta 判断“一条广告应该给谁看”的方式。这件事,最终会彻底改写「创意测试」。
现在要考虑的是,这条素材,到底给 Meta 提供了什么新的用户匹配可能?
Meta-新分发逻辑
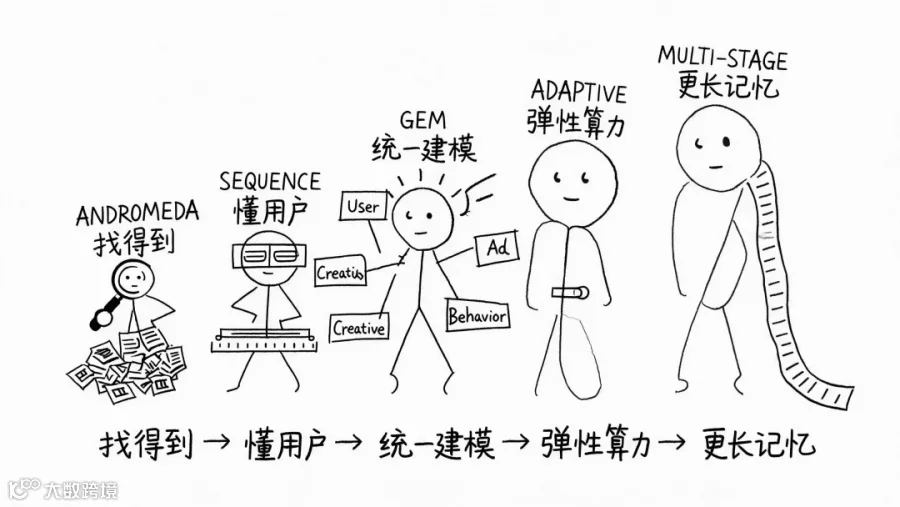
2024年11月,Meta 公开 Sequence Learning,把用户行为从“统计特征”还原成“事件序列”。
系统不再只看“这个用户是什么标签”,而是看用户最近到底做了什么。看了什么广告、点了什么玩法、装了什么游戏、什么时候付费、一连串行为后最终做了什么。
同年12月的 Andromeda 解决广告检索:当候选池大到几千万,系统必须在毫秒级判断这个用户此刻应该先考虑哪些。这直接动摇了「创意测试」的旧前提——系统不会平等地给每条素材曝光机会,它只会快速挑出自认为更匹配的候选。
2025年的 GEM 进一步把用户、广告、行为、内容之间的关系放进更大规模的基础模型;2026年的 Adaptive Ranking 让系统根据具体请求动态分配算力,多阶段 Sequence Model 则把重度用户历史建模嵌入实时推荐。
这条线的终点很清楚:Meta 越加不依赖 CTR、CVR、CPI 这些后台能看到的局部指标,而是基于一套更深层、更动态的预测体系做分发。
所以你问这个素材 CTR 高为什么不给量,平台很难再用你报表上的逻辑来回答。
素材→人群匹配
与其说测试变难,不如说对象变了。
Reddit 上这2个月的反馈很典型:8条素材放一组,第一天90%预算集中到一条;Winner 复制到 Scaling Campaign 后表现迅速下滑。
这些案例不能证明 Meta 的官方规则,但反映了一个现实:预算分配不再是每个素材先公平考试,再按成绩排名。
一条素材的“好”,不能脱离它被验证时的上下文——Campaign、用户池、竞争环境、历史信号,全都参与决定结果。
比“预算集中”更值得讨论的现象是:同一条素材,在不同团队手里,消耗能力可能完全不是一个量级。
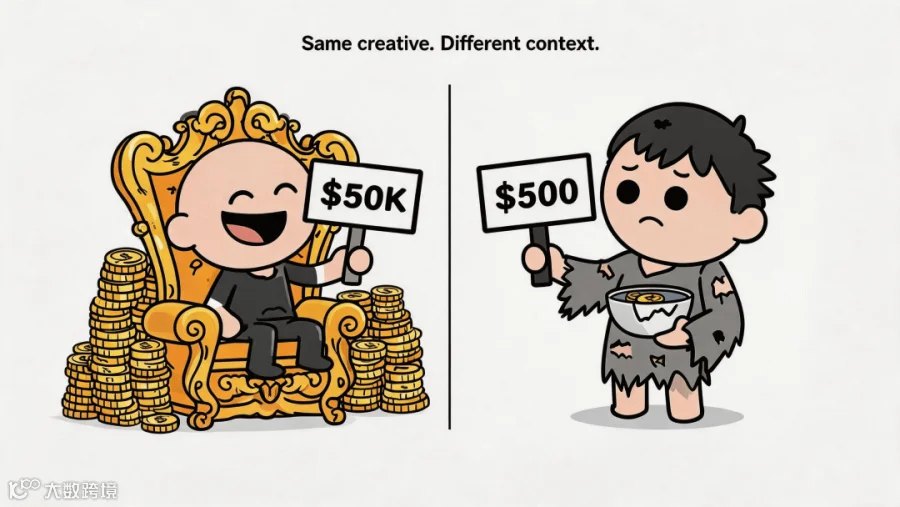
有人拿它跑几万美金还能放量,换到另一个账户或团队,几十美金就停住。素材没变,变的是它面对的人、账户历史、Campaign环境、优化目标和转化事件密度,以及 Meta 判断它能匹配多少用户的信心。
所以我不太建议把“能不能跑量”简单等同于“素材好不好”。
一条素材可能局部效率极高,但覆盖空间很小;也可能数据一般,却能在更大人群里找到匹配。
Creative Performance 和 Creative Distribution Capacity 是两个问题:前者表明给到这批用户后表现怎么样,后者证明除了这批用户,平台还能不能找到更多愿意反应的人。
真正该看的是效率、拿到的量、量级放大后效率是否保持、平台有没有持续给新用户。
把这些合在一起,才能判断它是“没有机会”还是“没有规模”。
从“谁 CPA 低”到“谁能放大”
传统做法:10条素材丢进 Ad Set,看谁 CPA 低,留两条 Winner。现在它只测出哪个素材在这次流量分配里结果更好,没测出这个创意到底覆盖了多少潜在用户。
假设 A 素材 CTR 3.5%、CPI $1.5,B 素材 CTR 2.1%、CPI $2.2,传统思路很容易把 A 定为 Winner。但如果 A 只适用于一小撮高度匹配人群,而 B 能覆盖更大潜在人群,那么预算拉到 $20,000 时,B 的价值可能完全不同。

做创意测试,不能只看这条素材眼下跑得好不好,还得看它有没有放大的空间。能不能从小预算里跑出来,再扩到更大的人群里。
过去它像考试,10条素材做同一套题,看谁分数高。现在更像探索,平台要从大量广告里找什么广告适合什么样人。
当平台越来越擅长 exploitation(利用已知有效的东西),广告主真正稀缺的能力变成 exploration(不断提出值得验证的新假设)。
Meta 能帮你找人、匹配、预测,但它替你决定不了:下一种用户动机是什么?哪个卖点值得押注?哪个看起来不合理的方向值得给一次机会?这仍然是UA团队的价值。
别把算法升级
理解成预算升级
讲完这些,很容易走入一个误区:既然 Meta 这么聪明,是不是应该疯狂做素材、疯狂测试、疯狂扩大实验规模?
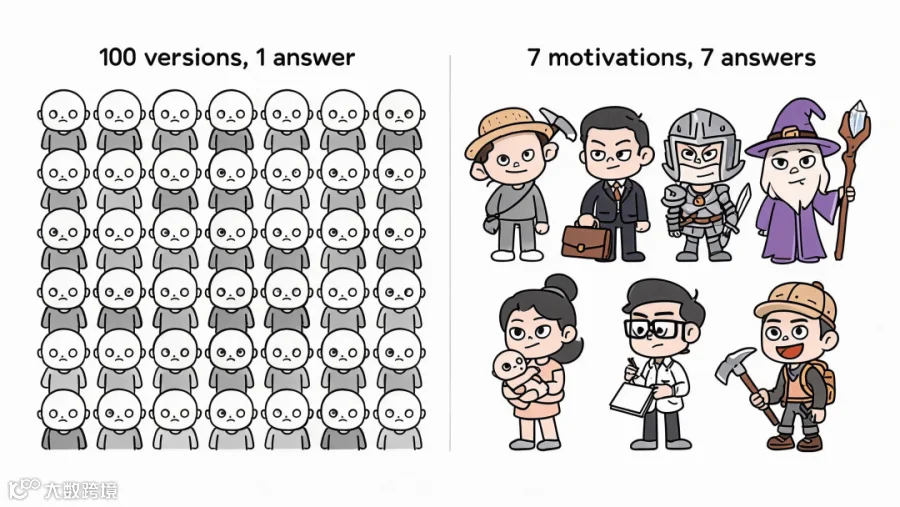
你只要不是土财主,我都劝你别这么搞。
算法越来越强,不代表每个团队都应该用同样的实验方式。尤其不要看到点点这种公司的打法就直接抄。如果一个产品的长期 LTV 能达到普通游戏的数倍,它当然有更大空间承担前期测试成本;
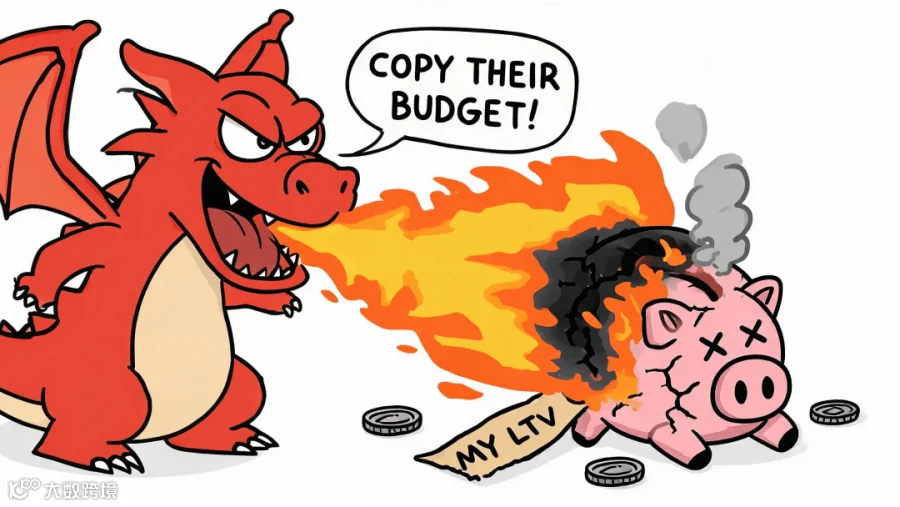
但如果你的产品 LTV 只有它的三分之一甚至更低,照着同样方式烧预算,很可能算法还没找到 Winner,现金流就先趴了。
「创意测试」首先是资源配置问题,其次才是算法问题。你能承受多少失败?一个方向给多少机会?什么情况下继续、什么情况下止损?这些都该建立在自己产品真实的 LTV、回收周期和现金流能力上。
别人是在用自己的 LTV 换探索空间,你可能是在拿自己的利润买一张根本买不起的入场券。
以《Kingshot》这类高 LTV 产品为例,它们可以做某种形式的变体洗测,不代表所有游戏都能这么搞。
真正该学的是,它们为什么敢这么测?一轮实验能承受多少损失?什么数据让它们加码,什么数据让它们止损?能搞清楚这些,比复制素材数量、Campaign 结构或测试预算重要得多。
结语
说到底,2026年的「创意测试」是两件事:一边利用 Meta 越来越强的推荐能力,把验证过的东西交给算法去放大;一边拿自己真正承受得起的预算,持续探索算法还没有足够历史数据判断的新答案。
前者解决放大,后者解决未来。
成熟团队真正要拿捏的,是两者之间那条线。
我们最近开源了一个「创意决策系统」MVP版,欢迎大佬们体验~
顺带尝试用AI出了一条宣传片,还是和手搓有比较大的差距
项目地址:https://github.com/augura-os/augura