



以众包模式扩大物理AI数据产能。
本文为IPO早知道原创
作者|Stone Jin
据IPO早知道消息,觅蜂科技于9月23日正式发布全球首个全品类高质量物理 AI 数据众包服务平台“觅蜂派”。
觅蜂派面向社会开放物理 AI 数据采集任务,用户通过觅蜂派App领取数据采集任务,佩戴 MEgo 设备在零售、仓储、制造、家庭等真实场景中完成指定操作,按照审核后的有效数据时长即可获得相应报酬,成为一名“机器人训练师”。
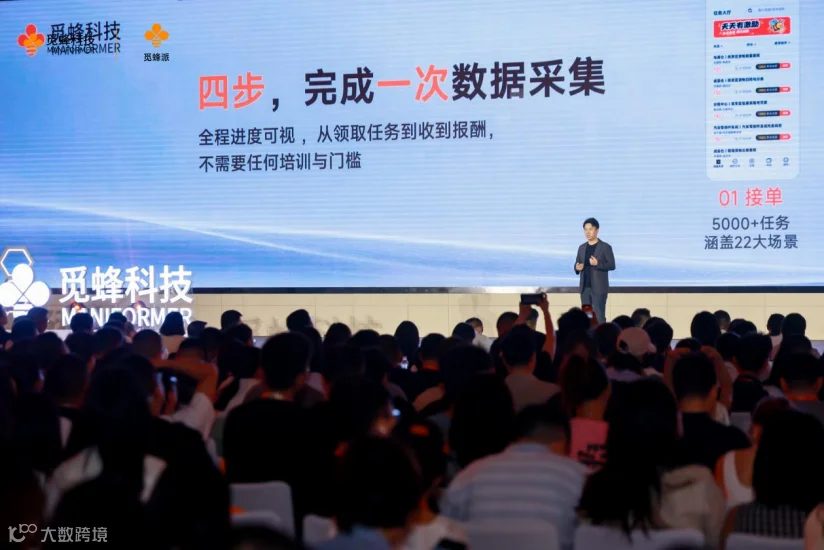
“物理AI最好的老师,是每一个认真生活的人。”觅蜂科技董事长兼CEO姚卯青表示,觅蜂派希望将分散在日常生活和千行百业中的真实操作经验,转化为机器人可以学习、训练和复用的数据。
觅蜂派的上线,意味着物理 AI 数据生产从集中采集走向更广泛的分布式、社会化协作,围绕任务组织、数据工程、质量控制和闭环运营形成新的生产体系。
某种程度上而言,觅蜂派可被视为“中国版 Index”。今年8月,Figure 发布 Index,通过向全球用户付费采集真实任务视频,来构建多样化训练数据集。
同样是把众包模式引入具身数采,二者不同之处在于,觅蜂派面向的是更广泛的行业需求——服务不同模型厂商、机器人企业和数据采购方,根据客户需求组织数据生产,并将处理后的数据作为服务对外交付。
这也意味着,觅蜂派需要处理更复杂的数据需求:服务对象越多,需要覆盖的行业、任务和长尾场景越广;众包规模越大,对采集标准、数据治理和稳定交付的要求也越高。
进一步来讲,觅蜂派真正值得关注、拆解的,也正是“全品类”和“高质量”两个关键词。
让日常经验成为机器人“教材”
事实上,今年以来,具身智能行业开始探索更多样的数据来源,当下逐渐成为共识的数据分工是:无本体采集拓展规模与场景,真机遥操提供贴近本体的数据,真实部署帮助模型持续修正。
至于无本体数据要做到多大规模,一个普遍观点是,如果要实现具身 AGI,需要的数据至少要从百万小时扩展为亿级小时。一百万到一亿,显然难以通过已有模式线性复制,需要一种“降维打击”的方式。
觅蜂派、Index 所采用的众包模式,则是一种有效放大数据产能的杠杆。
Figure 公布的 Helix 2.5 实验已经证明了众包数据的价值:在30套陌生住宅中,不采数据、不额外训练,Index 的预训练让零样本成功率从9%提升至56%。
觅蜂派沿循相同方向,希望让更广泛的人群加入具身数据的生产与采集。
对用户而言,担任“机器人训练师”的门槛并不高:不需要理解机器人算法,也不需要掌握编程,只需要按照任务要求佩戴 MEgo 设备,在熟悉的工作和生活环境中完成操作。
对于仓储、物流、零售、制造等行业的劳动者而言,其中不少采集任务与原本熟悉的工作场景高度重合,使既有经验能够进一步产生数据价值。
在为期一个月的内测期间,觅蜂派注册用户数达2万人,累计产生1.3万份采集任务提交。首批参与者来自不同年龄和职业,他们开始把日常劳动与专业技能转化为机器人训练数据。
为降低用户参与门槛,觅蜂派无需用户掌握编程或机器人知识,任务页面清晰展示操作步骤、设备要求、验收标准和收益规则;采集进度和审核结果均可查询。平台以“合规、真实、标准、不串、多点”五项标准贯穿任务设计、采集执行和质量验收,保障有效数据质量。

发布会上,觅蜂派还宣布启动亿元补贴计划,覆盖采集任务、设备政策、线下服务和保险保障。2026年9月23日至10月22日推广期间,觅蜂派减免设备使用费,符合条件的用户可享受信用免押等政策。

首个全品类高质量物理AI数据众包服务平台
从另一个角度来看,觅蜂派与 Index 都以众包方式扩大数据供给,但在数据如何被使用、最终服务于谁的问题上,两者并不相同——Index 围绕 Figure 自身的模型训练需求建立数据闭环,觅蜂派则面向不同模型厂商、机器人企业和数据采购方,根据客户训练需求组织数据生产,并将处理后的数据作为产品与服务对外交付。
从服务单一模型体系转向服务多个客户,增加的不只是需求数量,还有场景、任务、数据模态和质量标准的复杂度。
觅蜂派因此需要同时回答两个更现实的问题:数据能够覆盖多广的场景,又能否稳定交付。
其“业界首个全品类高质量物理 AI 数据众包服务平台”的定位,也正是围绕这两个问题展开。
何为“全品类”?一端是中国庞大的产业场景基础,一端是觅蜂牵头推进场景联盟、持续拓展数据入口的生态能力。
中国拥有全球规模最大的制造业体系、密集的物流仓储网络、丰富的零售和服务业态,意味着大量机器人未来可能执行的任务,已经有人在真实环境中反复完成。中国的产业链优势,也以一种更直接的方式转化为物理 AI 数据优势。
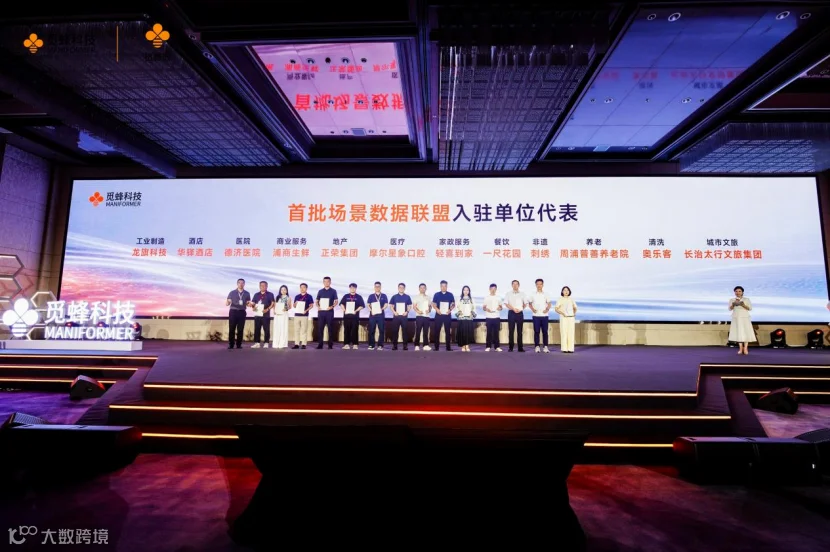
发布会现场,觅蜂宣布发起“场景数据联盟”,联合场景方、采集网络、机器人及模型企业,推动场景需求、数据采集、模型训练和落地验证形成闭环。
联盟首批成员覆盖零售商超、酒店文旅、餐饮服务、养护院、智慧生活、医疗健康、地产制造和城市物业等领域,包括东呈酒店、中旅集团、华驿酒店、陈香贵、普善养护院、上海德济医院、正荣集团、龙旗科技、海天瑞声、张江集团等50余家企业和机构。
据觅蜂披露,觅蜂派覆盖22大类场景、5000多个任务和50000多个真实环境,具体场景包括物流、仓储、住宿服务、教育、养老照护、餐饮、零售、公共服务、办公、汽车服务、医疗、建筑施工、交通出行、农业生产、文旅等。
这些场景既包括取放、整理、搬运等通用操作,也包含装配、检修、照护等专业任务,可为机器人训练动态环境理解、精细动作控制、连续流程执行、风险判断和安全交互等能力提供数据。
从这个角度看,“全品类”并不只是任务列表足够长,更重要的是平台能够持续进入不同产业环境,根据模型需求动态组织数据生产。
用户规模决定数据可以做多大,产业链和场景网络则决定数据可以做多深。
构建一张持续生长的物理AI数据网络
在质量层面,觅蜂对“高质量”的定义,一方面是关注真实行为能否被高质量设备准确记录。
使用觅蜂派采集数据,用户将搭载觅蜂自研的 MEgo 无本体采集设备。该设备采用行业首创的多视角、多模态,300°全景加腕部特写,记录整体环境与手部操作;空间上,三维触觉配合毫米级轨迹重建,时间上,全通道硬件级同步、亚毫秒级对齐,尽可能减少视觉、触觉和姿态之间的偏差。
同时,觅蜂构建了 MEgo Engine 数据处理基础设施,覆盖数据处理、感知、标注和质量评估等环节,并通过高精度位姿重建与动作映射,将真实世界中的手部、身体、头部、机器人末端及环境信息转化为统一的空间数据。
当前,2 万套 MEgo 产品已陆续进入家庭、办公、零售、生产、餐饮等真实场景,累计采集有效数据达到百万小时。
另一方面,则是考验数据能否真正转化为模型能力。
为让海量真实数据能够被高效利用,觅蜂还形成 ManiEval 多维度数据质检与分级体系。ManiEval 从数据类型、任务类型、传感器质量、语义质量、动作质量等多个维度对数据进行评估,并提出“不过滤,只分级”:不同质量、不同特征的数据,匹配不同的模型训练需求,让每一条真实数据都能够找到适合自己的应用场景。
据了解,觅蜂百万小时级无本体数据已开始服务腾讯 Robotics X 实验室、蚂蚁灵波等头部客户,根据不同模型训练需求提供相应的数据产品与服务。
不可否认的是,真正判断数据质量的,始终是下游模型是否愿意复购,以及使用之后有多少价值。
过去,觅蜂已经完成采集硬件、百万小时数据、MEgo Engine 和头部客户验证。觅蜂派进一步补上的,是社会化的数据生产网络与更广泛的场景入口。
随着具身智能的数据需求从百万小时迈向千万乃至亿级小时,能够持续连接真实场景、响应不同模型需求并保持稳定质量的基础设施,其稀缺性会进一步上升。
换言之,觅蜂正在构建这样一张持续生长的物理 AI 数据网络。
小马智行 | 地平线 | 文远知行
蜜雪冰城 | 古茗 | 沪上阿姨
极智嘉 | 云迹科技 | 特斯联