作者丨高允毅
编辑丨岑峰
今早,硅谷迎来双雄对决:Anthropic 推出 Claude Opus 5.5,OpenAI 紧接着推出 GPT-6 Sol 与 Luna。与以往模型更新不同,行业讨论焦点聚焦于“降价”。
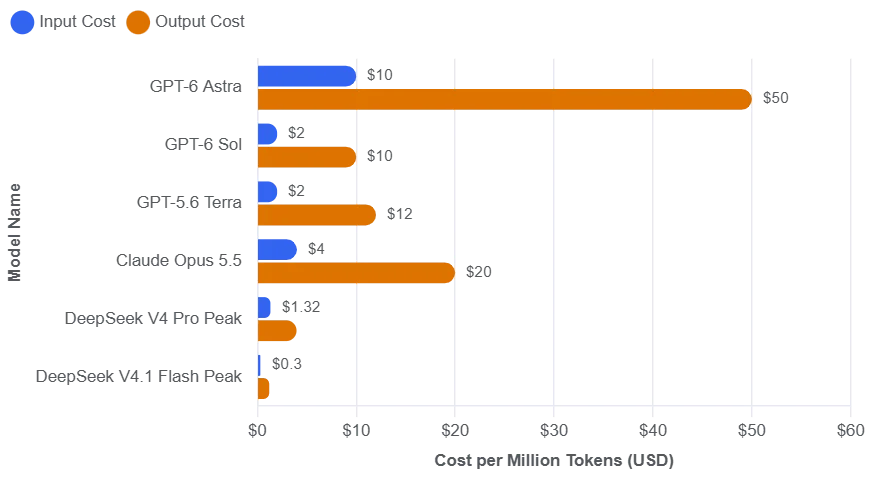
Claude Opus 5.5 较上一代成本降低 40%,性能达到 Fable 级。GPT-6 Sol 性能持平 GPT-5.6 Sol,价格看似腰斩(每百万 Token 输入 2 美元,输出 10 美元),直逼 DeepSeek 的腹地。
但若仔细对照,OpenAI 的“腰斩”实为“偷梁换柱”。此前 OpenAI 模型档位为旗舰 Sol、中端 Terra、轻量 Luna,现变为 Astra、Sol、Luna。被取消的 Terra 实则是被提档改名为 Sol。对比 GPT-5.6 Terra(每百万 Token 输入 2 美元、输出 12 美元),GPT-6 Sol 价格几乎无变化,降价真相不言自明。


三家账本摊开看,谁在真降价?
当下 AI 大模型赛道价格战白热化,但各家降价的成色与逻辑天差地别。Anthropic 最具诚意,DeepSeek 保持绝对成本优势,而 OpenAI 更偏向商业定价叙事的策略型降价。

Anthropic:强模型,真降价
Claude Opus 5.5 用 40% 的价格保留了 80% 的核心能力。其核心优势在于大幅降低了长任务中最烧钱的“思维链”隐形开销,将核心的“缓存读取”费用下调 60%,使长任务深度思考总成本减少近六成,让开发者敢于频繁调用高阶推理。
DeepSeek:绝对成本优势仍在
DeepSeek 的低价优势显著,闲时甚至能减半。尽管高峰时段 GPT-6 Luna 的标价看似更低,但 Luna 仅是十几 B 参数的轻量小模型;而 DeepSeek-V4.1-Flash 则是 552B 参数的重型 MoE 模型,在编程与复杂推理上具备智商碾压。凭借非对称因果编解码(CED)架构,其成本优势极强。不过,DeepSeek 的低价依赖错峰机制与高前缀重复度,而 OpenAI Luna 的“省心价”对中小开发者更友好。
OpenAI:商业套路与价格杠杆
GPT-6 Sol 的“价格腰斩”是一场高明的定价叙事。一方面,其缓存命中输入价格降至 1 折(0.20美元/百万Token),此举能有效增加企业数据迁移成本,构建生态壁垒;另一方面,长文本(超 272K Token)输入费翻倍,实质是用价格杠杆调节需求,掩盖了其在长文本压缩技术上的效率短板。
降价背后:DeepSeek 与 OpenAI 的降本逻辑差异
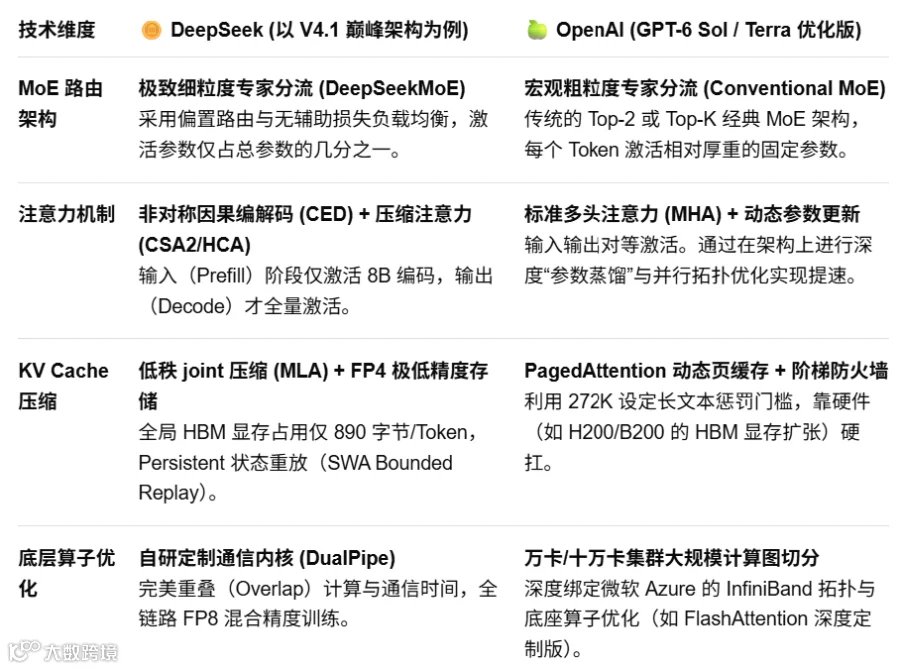
在降本路径上,两者走向了截然不同的方向。
DeepSeek:极客式的极致压缩与调度
DeepSeek 依托因果编解码(CED)架构,预填充与解码非对称激活,将实际激活参数控制在 8B-16B。通过 YOCO 架构“只缓存一次”、MLA 多头潜在注意力及第二代压缩稀疏注意力(CSA2),从特征共享、FP4 极限精度、滑动窗口等多维度压缩 KV 缓存,最终将其体积降至每 Token 约 890 字节,仅为标准 Transformer 的 2%。此外,其在万卡集群中极致压榨 GPU 闲置时间与周边硬件,实现协同提效。
OpenAI:务实路线与提示缓存极致利用
OpenAI 尽量不动核心架构,通过参数蒸馏、稀疏化重构及长上下文阶梯定价来控制成本。其降本核心在于将“缓存用满”:提升缓存命中率并延长寿命至 30 分钟,开放显式缓存断点与预热缓存能力。实测显示,在代码交互与企业级 Agent 场景中,缓存命中率稳定在 90% 以上,大幅削减了重复计算成本,并通过多任务逻辑最大化复用已有算力。
性价比内卷:奥圣上位与行业冷思考
过去两年,DeepSeek 凭借架构创新将价格打穿,梁文锋被誉为“梁圣”。OpenAI 此次降价后,被网友调侃为“奥圣上位”。然而,这位新晋“奥圣”的性价比故事,一半靠换标,一半靠缓存折扣,建立在用户不细看价目表的前提下。
当巨头竞争演变为价格战,既无万卡集群又无自研架构的玩家,下一轮拿什么上牌桌?