

本文作者|罗开荣 本文编辑|蒲诗瑶
- 论文题目:Puro-2B: Poor Lab's Qwen2-1.5B Trained on RTX 5090 within $5090
- 作者:Kairong Luo, Jiarui Cui, Yaorui Yin, Shengqi Chen, Yiming Yang, Linxiang Gao, Yanmohan Wang, Chengxia Li, Mingzhe Zhang, Kaifeng Lyu, Wenguang Chen
- 论文链接:https://arxiv.org/abs/2608.27370
- 项目链接:https://huggingface.co/collections/thu-pacman/puro-2b
训不起千亿参数模型,十亿参数、万亿 token 的预训练门槛有多高?经典的 Qwen 系列虽开源权重但未公开完整预训练配方;OLMo、SmolLM 等虽开放细节,但复现成本高达数十万甚至上百万美元。对于普通实验室,我们需要一套低成本、可复现的“穷人版”预训练方案。
Puro-2B:全流程开源的低成本预训练方案
清华大学陈文光教授与吕凯风教授团队联合推出全流程开源的 Puro-2B(普罗-2B),开源了训练数据、框架、配置和模型权重。团队在消费级显卡 RTX 5090 集群上,从头训练了约 20 亿参数的模型,最多使用 1.4 万亿 token。在 15 项综合评测中,以约 4400 美元的计算成本,模型平均指标超过 Qwen2-1.5B;6900 美元成本的最佳版本,平均性能接近 Qwen2.5-1.5B。
此外,团队拟合了“成本—性能经验曲线”(Puro Cost Scaling Law),帮助研究者在训练前预估不同预算下的模型能力。该低成本方案得益于硬件选择、低精度训练、优化器改进、高质量数据利用及数据选择五方面的协同设计。
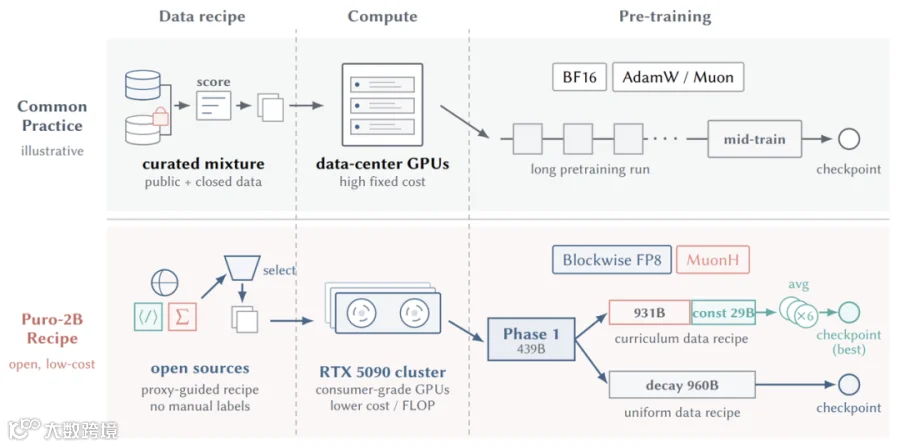
图1 | Puro-2B “穷人版”训练流程
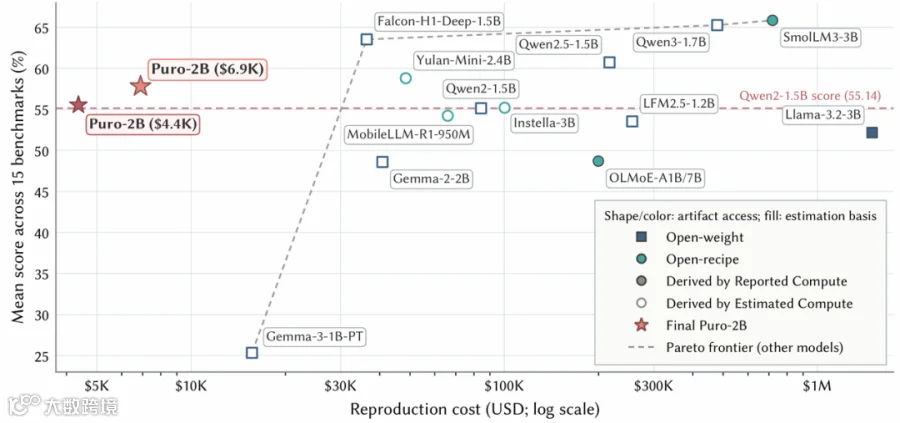
图2 | 模型性能与复现成本
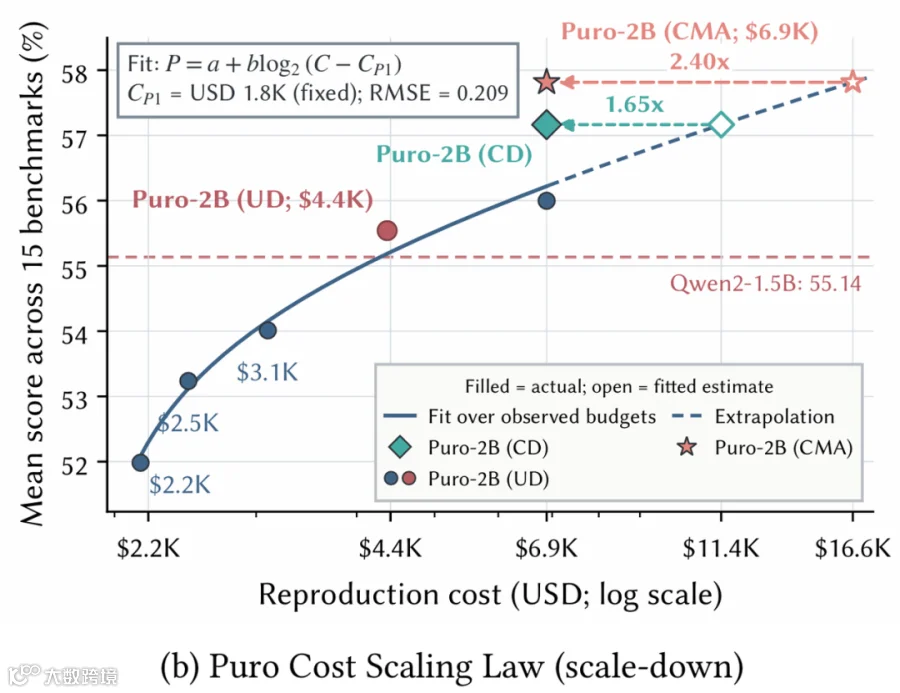
图3 | Puro Cost Scaling Law
RTX 5090:挖掘消费级显卡的算力性价比
相比数据中心 GPU,RTX 5090 的 BF16 峰值算力/美元约为 H200 的 2.77 倍,单位成本算力优势显著。针对 RTX 5090 显存小、无 NVLink 的特点,团队通过 PCIe P2P 和 GPUDirect RDMA 优化,大幅提升节点内和节点间通信带宽,降低延迟。训练策略上,采用数据并行与流水线并行组合,并均衡显存负载,使综合 MFU 超过 70%,将消费卡的性价比转化为成本优势。
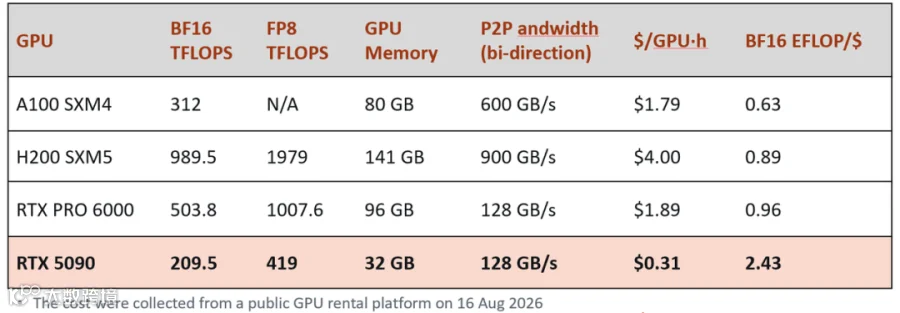
图4 | 不同显卡的计算价格比值的统计与对比
FP8:发挥 Blackwell 架构的低精度效率优势
RTX 5090 支持 FP8 训练。团队沿用细粒度分块量化思路,将主要线性层矩阵乘法置于 FP8 路径,数值敏感操作保留 BF16 或 FP32。实验表明,FP8 验证损失仅高出 0.0031–0.0039,但训练吞吐效率提升 1.36 倍。折算精度损失后,仍具备约 1.34 倍的净效率收益。

图5 | FP8 的损失差距与质量校正后的效率
MuonH:基于有效学习率的优化器与调度设计
团队采用 MuonH 优化器,对权重更新量归一化并投影回固定半径,从而显式预设“有效学习率(ELR)”。对照实验表明,MuonH 的优势核心在于有效学习率的变化过程。结合 power schedule 和长线性衰减的学习率调度策略,MuonH 方案相比调参后的 Muon 基线,训练效率提升约 1.19 倍。

图6 | MuonH 原理示意图以及与Muon的对照
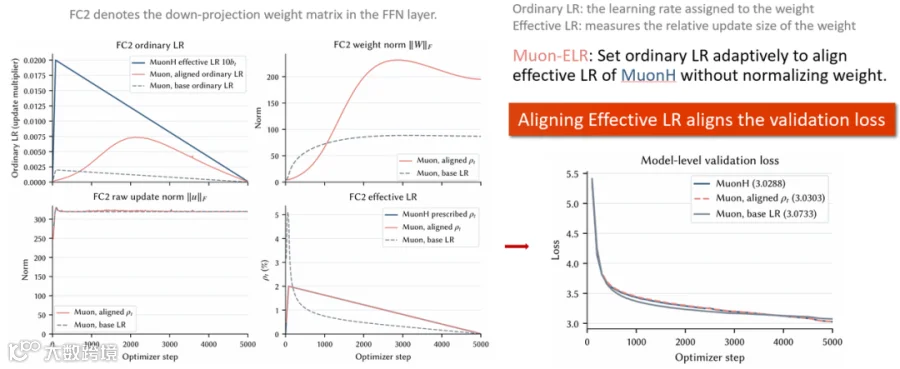
图7 | ELR 对齐实验的解释与对照
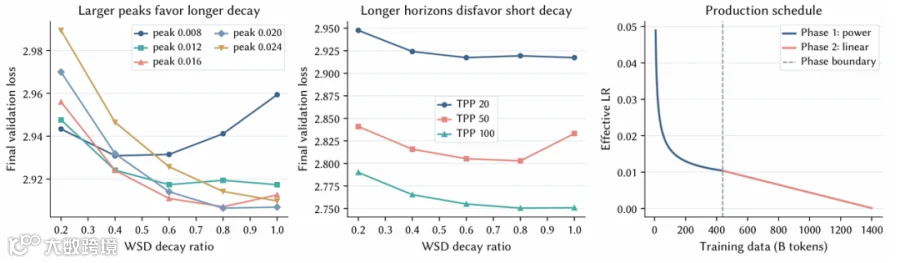
图8 | 学习率设计

图9 | MuonH 的训练效率消融
CMA:提升优质数据在训练后段的利用效率
将高质量数据排在训练后段可提升利用效率,但后期低学习率会导致模型难以充分学习。为此,团队采用课程模型平均(CMA),在训练后期保持恒定学习率,并对末端检查点做权重平均以降低噪声。消融实验证实,数据顺序、后期学习率与模型平均策略必须配合使用。按经验曲线估算,完整 CMA 方案将成本效率提升至约 2.40 倍。
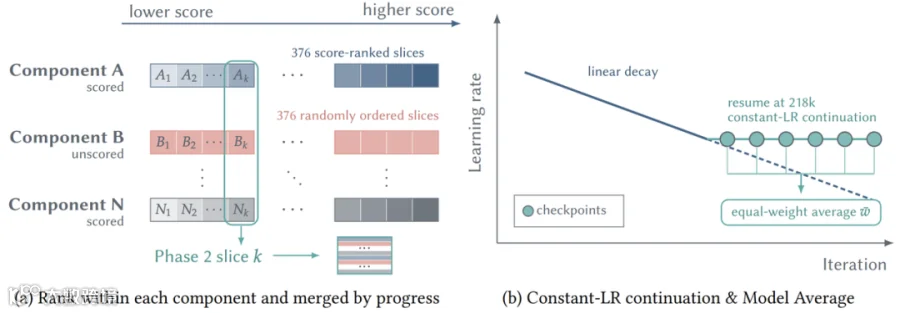
图10 | 课程数据构造与模型平均

图11 | 对数据顺序、后期学习率与模型平均策略的消融实验
数据评测:通过小规模代理实验评估数据价值
团队建立了“数据源—数据切片—能力评测”的分层比较流程。通过小规模代理实验,对比不同数据源及切片的质量差异,发现代码能力对通用能力的削弱较多。据此,在第二阶段适当提高数学数据比重,结合领域覆盖和质量筛选确定最终配比,为数据选择提供量化参考。
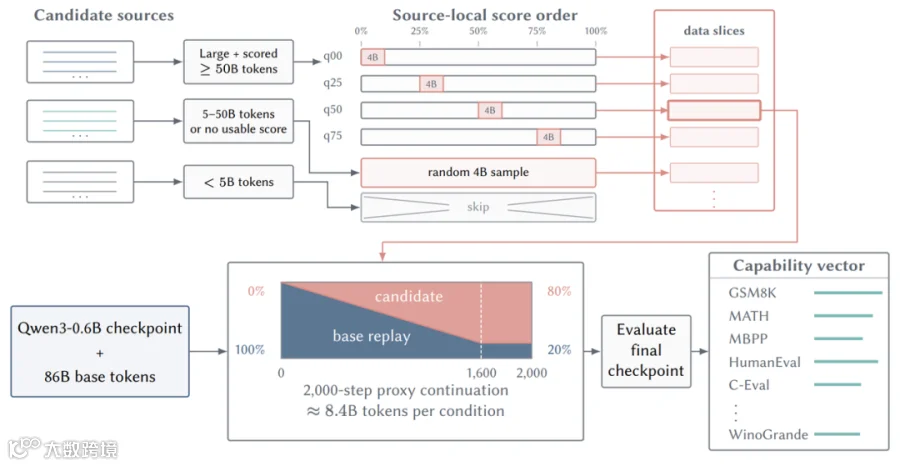
图12 | 代理评测流程

图13 | 两阶段数据配比
从节省算力到支持完整预训练研究
整套方案从硬件降本、FP8提效、MuonH加速收敛、CMA提升数据利用率到代理评测选数,共同构成低成本预训练流程。这不仅是一个高分模型,更为基础架构研究提供了可控、可负担的实验平台。例如,验证预训练方法的改进在后训练阶段是否依然有效。实验表明,基于 CMA 预训练权重微调的模型在多项指标上均优于常规方案,证明其优势能延续至后训练。
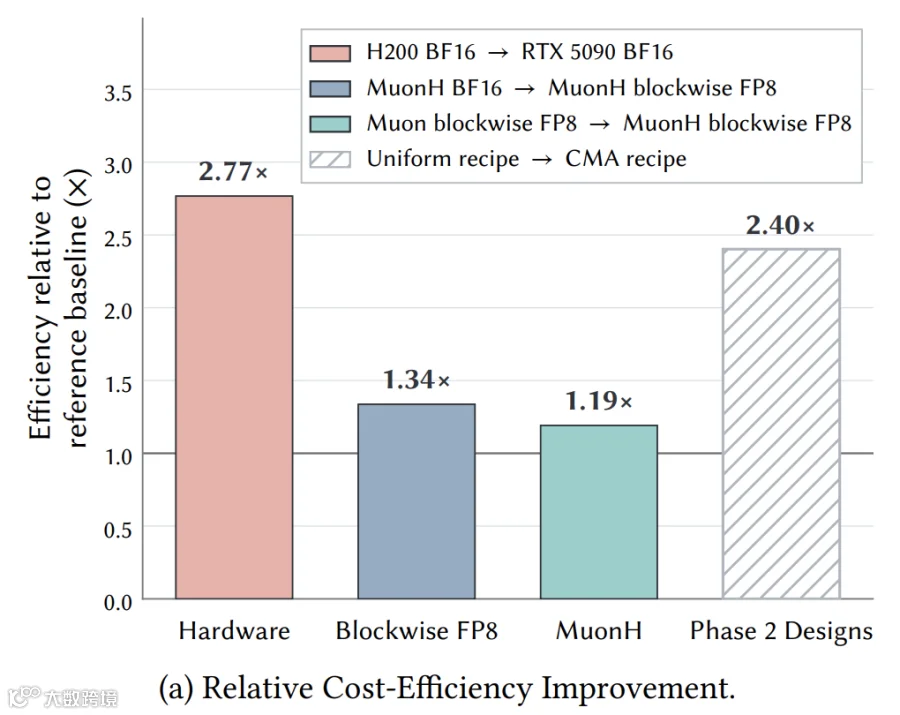
图14 | 各环节效率收益汇总
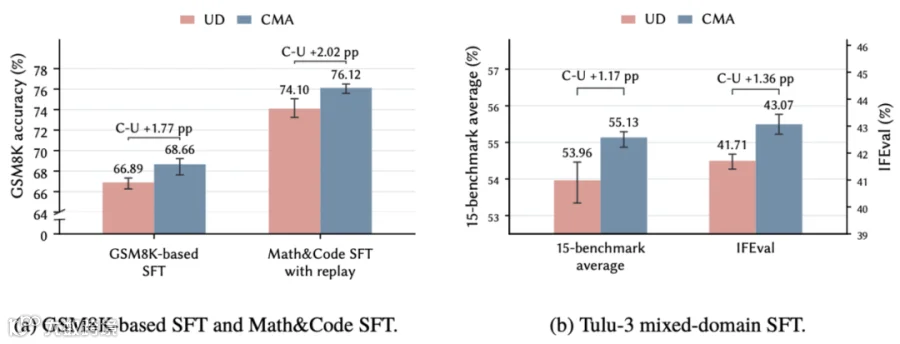
图15 | CMA 与Uniform数据预训练的权重做微调后的对照
全流程开源
团队公开了最终模型、中间检查点、训练数据及代码(Apache 2.0 许可),极大降低了普通团队参与预训练研究的门槛,推动大模型训练向“普罗大众”普及。
注:本项目的成本核算仅针对正式预训练的 GPU 算力成本,不包含数据处理、消融实验、后训练和研发人力等项目总开支。