


2026年9月18日,Convai Innovations 将 Laya 模型权重发布至 Hugging Face。次日,开发者 mizorewww 推出了 Laya-MLX,将这套模型原生移植到 Apple Silicon 的独立 MLX 运行时。核心数据表现亮眼:
421M 参数的英文版单条短问题 MLX 峰值内存仅为 943.6 MiB;322M 的多语言版更是降至 687.6 MiB。两者均控制在 1 GB 以内。无需 PyTorch、Transformers 推理运行时及云端 API,仅需一行 pip install laya-mlx 即可完成安装。
Laya:非自回归的 System 1 决策模型
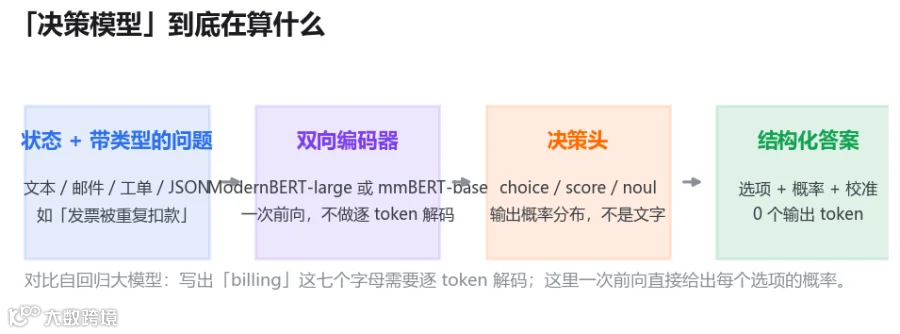
Laya 并非传统的大语言模型,而是非自回归的“System 1 决策模型”。输入状态(文本、邮件、JSON 等)与带类型的问题后,它能通过一次前向传播直接返回答案,无需逐 token 解码或生成 JSON,也不产生输出 token 计费。其核心问题原语包含三种:
choice:从 N 个选项中单选,返回各选项概率;
score:在有序评分量表上评级,返回期望分;
noul:对命题返回 P(真)。
模型主干采用当代双向编码器,提供三个明确的检查点:
| 检查点 | 编码器 | 参数量 | 上下文 |
|---|---|---|---|
convaiinnovations/laya |
ModernBERT-large | 421M | 512 |
convaiinnovations/laya-multilingual |
mmBERT-base | 322M | 1,024 |
convaiinnovations/laya-typed-decisions |
ModernBERT-large | 421M | 1,024 |
其训练采用 RLCD(强化学习与严格适当评分规则),促使模型仅通过输出诚实的概率分布来最大化期望收益,从而实现精准的概率校准。
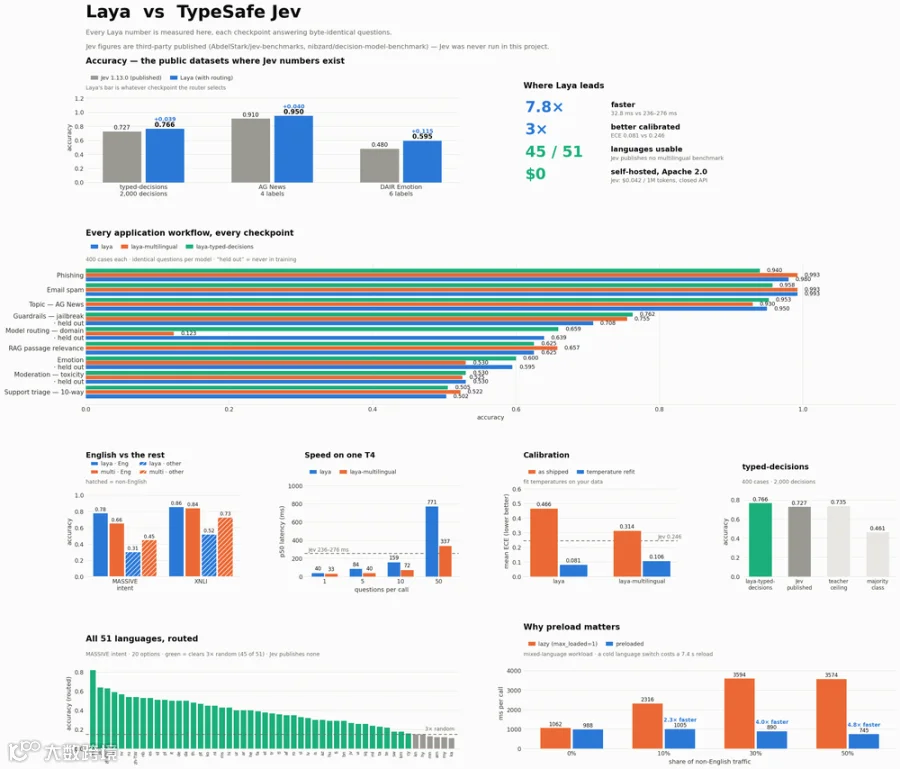
在定位上,Laya 自视为 TypeSafe Jev 的开源平替。相比于闭源云 API Jev(输入 0.042 美元/百万 token),Laya 采用 Apache-2.0 协议,本地部署成本为零,目前 GitHub 星标已超 2 万。
Laya-MLX 的核心技术突破
Laya-MLX 并非简单的代码移植,而是重写了整条推理链。由于上游依赖 PyTorch,而 Apple GPU 需原生 MLX 才能发挥性能,该项目将编码器、决策 Transformer、评分头及动作头全部改用 MLX 实现,仅分词器保留 Hugging Face 的 Rust 实现。
开发效率极高:2026年9月19日建仓当日即完成原生 MLX 推理,随后迅速发布基准测试与导出流程,并于 9 月 22 日跟进上游 v0.3.5 版本。目前项目采用 Apache-2.0 协议,已获 6,016 星标。同时,三个检查点的 FP16 权重已同步发布至 Hugging Face,并全数通过远端校验。作者强调:这是独立的 MLX 社区移植,非 Convai Innovations 官方发布。
内存占用深度解析
以下测试数据基于 M3 Max(40 核 GPU、128 GiB 统一内存)在 FP16 精度下得出(不含模型加载时间):
| 指标 | 英文版 Laya | 多语言版 Multilingual |
|---|---|---|
| 参数量 | 421,293,827 | 321,908,995 |
| FP16 权重占用 | 803.6 MiB | 614.0 MiB |
| 单条短问题峰值分配 | 943.6 MiB | 687.6 MiB |
| 10 条满上下文问题峰值 | 1,833.0 MiB | 1,509.1 MiB |
943.6 MiB 的峰值数据经得起逐字节核对。原始基准 JSON 显示,英文版单问题的 mlx_peak_bytes 为 989,426,222 字节(折合 943.6 MiB),多语言版为 721,049,698 字节(折合 687.6 MiB)。
权重占用 803.6 MiB,峰值却达 943.6 MiB,差额约 140 MiB 用于输入、中间激活及 MLX 分配器缓存。需注意,此“峰值分配”仅为 MLX 内部记账,并非 Mac 系统的总内存占用(操作系统、终端及 Python 进程另计)。
多语言版内存更低,是因为其采用了更轻量的 mmBERT-base(768 维、22 层),而英文版为 ModernBERT-large(1024 维、28 层)。有趣的是,更小的多语言版反而支持更长的上下文(1,024 对 512)。

推理速度:有提升,但未达“数量级”
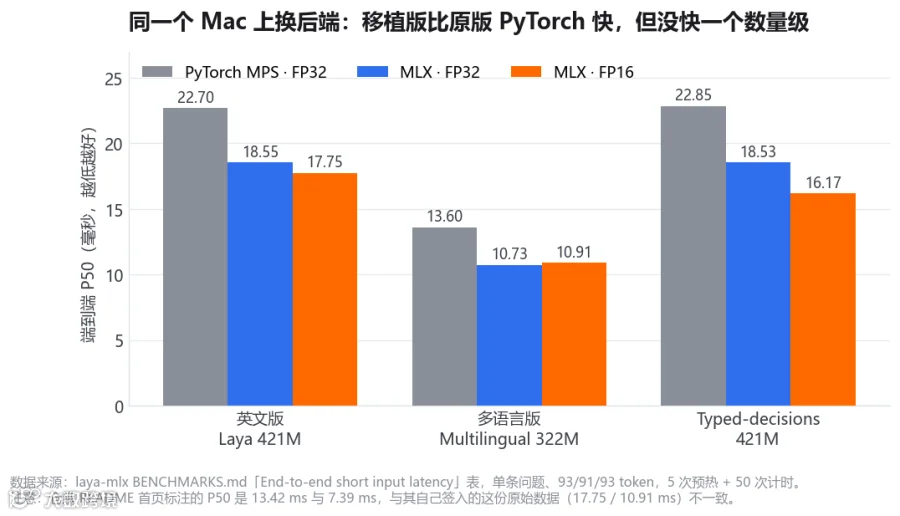
Laya-MLX 的核心在于“替换整条运行时”。在同一台 M3 Max 上的后端对比如下:
| 单条短问题端到端 P50 延迟 | 英文版 Laya | 多语言版 | Typed-decisions |
|---|---|---|---|
| PyTorch MPS · FP32(上游) | 22.70 ms | 13.60 ms | 22.85 ms |
| MLX · FP32 | 18.55 ms | 10.73 ms | 18.53 ms |
| MLX · FP16 | 17.75 ms | 10.91 ms | 16.17 ms |
MLX FP16 确实优于上游 PyTorch MPS FP32,50 条问题的批量吞吐从 146.8 提升至 395.0 题/秒。
但需注意数据矛盾:项目首页与 PyPI 页面宣称单条延迟为 13.42 / 7.39 毫秒,而签入的 BENCHMARKS.md 及原始 JSON 数据均为 17.75 / 10.91 毫秒。经核实,后者具备完整的时间样本记录且可复现。部分媒体误用了首页的漂亮数据,本文以可复现的 17.75 / 10.91 ms 为准。
移植保真度至关重要。作者通过 3 个检查点 × 2 种精度(FP32/FP16),在 63 道验证题上与上游答案逐一比对,378 组测试结果完全一致。此外,每种配置重复调用 100 次,活跃内存增长为 0,证明移植高度忠实于原版 Laya。
实战演示:把决策模型塞进游戏循环
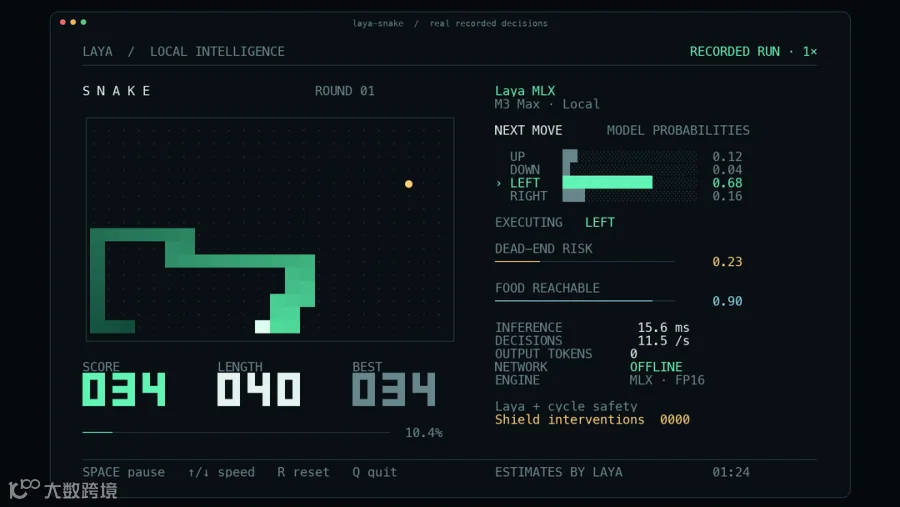
该项目最具传播性的亮点是终端贪吃蛇 Demo:每一帧均调用 Laya 决定移动方向,并实时展示四个方向的概率、推理耗时及安全层接管次数。
实测显示,开启编译与前缀复用后,游戏以 2,400 步 75.40 步/秒 的速度运行,实现零死亡,安全层仅接管 2 次,比 eager 基线快约 6.5%。该 Demo 直观展现了决策模型的工作机制——不生成自然语言再解析,而是直接输出动作概率(如 LEFT 0.68、RIGHT 0.16)及风险评估,大幅降低了推理开销。
理性看待:三个必须厘清的争议点
其一,“快 50 倍”缺乏数据支撑。作者在社交媒体宣称“比 Jev 快 50 倍”,但该倍数在 README、基准表及任何签入数据中均无体现,缺乏共同任务集与对比基线说明。客观结论是:仓库中的延迟、内存、吞吐数据真实可复现,但“50 倍”属于无法核实的营销话术。此外,Laya(Convai Innovations)与 Jev(TypeSafe AI)是两个独立团队的同类产品,不存在抄袭关系。
其二,未获上游官方社区工具收录。在 Laya 上游的 Community Tools 列表中,新增的 Apple Silicon 项目是 laya-apple(结合 MLX GPU 与神经引擎)。先发布且带完整基准的 Laya-MLX 并不在列。上游 Issue #50 中维护者明确表示:“MLX 移植仍由社区维护”,这意味着它并非官方认可的正式路径,且无法保证长期跟随上游更新。
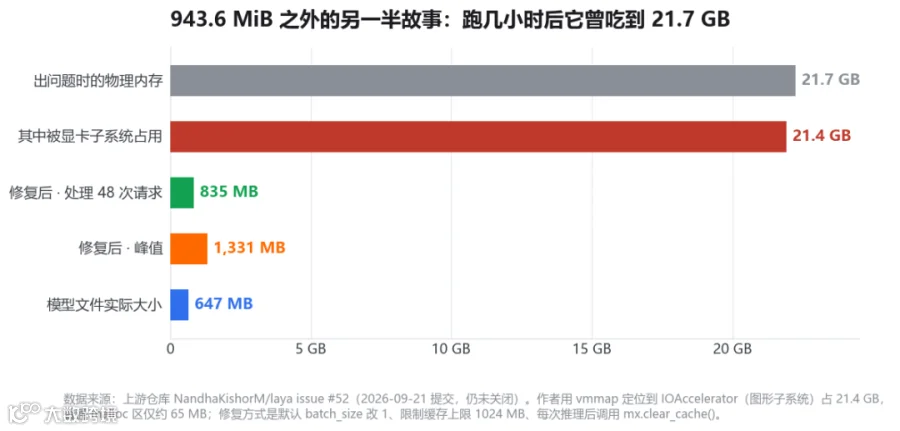
其三,峰值内存不等于长期驻留内存。上游 Issue #52 披露,Laya-MLX 连续运行数小时后,物理内存飙升至 21.7 GB。排查发现,问题不在于模型权重,而是 MLX/Metal 的推理缓冲和分配器缓存持续累积。通过调整 batch_size 为 1、限制分配器缓存并定期清理,内存占用可降至 834.6 MB。该 Issue 目前仍未关闭,说明 943.6 MiB 仅为单次短问题的峰值,长期运行的内存累积问题仍待解决。
上游模型自身的局限性
英文版在非英语场景下会失效。上游测试显示,英文检查点处理高棉语时准确率为 0,但置信度高达 0.952;处理其他非英语语言时也存在类似情况。由于平均置信度始终高于 0.885,无法通过置信度来过滤这些错误,非英语输入必须严格使用多语言检查点。
动作概率信号目前不可用。上游 Issue #185 指出,action.act_probability 对几乎所有输入均返回 1.0,其 AUROC 仅为 0.30,失去门控价值。相比之下,confidence 的 AUROC 达 0.77。若需进行门控操作,应优先使用 confidence 指标。
结语:门槛已降至 1 GB 以下
综合来看,Laya-MLX 在工程层面切实证明了其可行性:一个 421M 参数的双向编码器,能在 Apple Silicon 上以不足 1 GB 的峰值内存和十几毫秒的延迟,高效处理结构化决策问题。其数值保真度通过了严格比对,且安装部署极为便捷。
然而,其宣传话术与实际表现存在落差:首页延迟数据高于原始测试,“快 50 倍”缺乏依据,长期运行的内存累积问题尚未解决。
尽管如此,943.6 MiB 的峰值数据证明了一点:将“判断与决策”类任务从云端迁移至本地,内存门槛已成功降至 1 GB 以下。但这并不意味着该运行时目前已能无条件投入生产环境,仍需开发者审慎评估。
本文数据来源:laya-mlx 仓库 README / BENCHMARKS.md / 原始 JSON、PyPI 项目页、Hugging Face 模型卡、上游仓库相关 Issue 与 PR,以及第三方技术分析。