


官网公告两连:9 月 15 日官宣 System One 模型与 Jev,9 月 20 日取消候补、向所有人开放。
图源:TypeSafe 官网(2026-09-22 取)
摘要它不会聊天、不写代码、不生成长文,只输出一个带置信度的判断。一个把九成能力砍掉的模型,几天内在开发者圈刷屏。
这两天,一个不会聊天、不写代码的 AI 在开发者圈刷屏了:上线几天,社区冒出大约 500 个开源项目,官方 API 一度被挤到无法响应。(来源:社区项目公开仓库,2026-09-22)
它叫 Jev。不会聊天,不写代码,也不生成长文。它只做一件事:判断。
继续还是停止?通过还是拦截?这条广告该不该投放?——单次判断约 0.000015 美元,中位响应 0.33 秒。(来源:官方定价口径、第三方实测公开记录,2026-09-22)
9 月 20 日,TypeSafe 宣布取消候补名单,Jev 向所有人开放,注册即送 5 美金额度——按定价约等于 1.2 亿个 Token。(来源:TypeSafe 官网公告,2026-09-22)
时间线很快:9 月 15 日隐身模式亮相、同天官宣 4000 万美元种子轮;9 月 18 日接入 OpenRouter;9 月 20 日全面开放。(来源:TypeSafe 官网公告,2026-09-22)
周末两天,开发者社区围绕它冒出了大约 500 个开源项目,官方 API 一度被挤到无法响应。(来源:社区项目公开仓库,2026-09-22)
一个看起来「能力被砍掉一大半」的模型,为什么反而火了?
它其实是一个会做判断的函数
先说清楚 Jev 是什么。TypeSafe 官网给它的定义是:把非结构化的状态输入,转成类型化的概率决策。
翻译成人话:你给它一段现场情况,它还你一个选项和一份把握——「暂停,置信度 80%」。
它不生成文字。这点很关键。今天的大模型本质上是「先说话,再说事」:你要它判断一封邮件该不该转发,它得先写一段推理,再给你答案。
Jev 把「说话」这个环节整个砍掉了,只留判断本身。官方文档里它只有三种输出形态:Noul 输出 0 到 1 的概率;Choice 在最多 255 个选项里挑一个;Score 直接打分。
三种形态都附带完整的概率分布和置信度,而且是强类型输出——不是一段话,是软件能直接拿来执行的返回值。
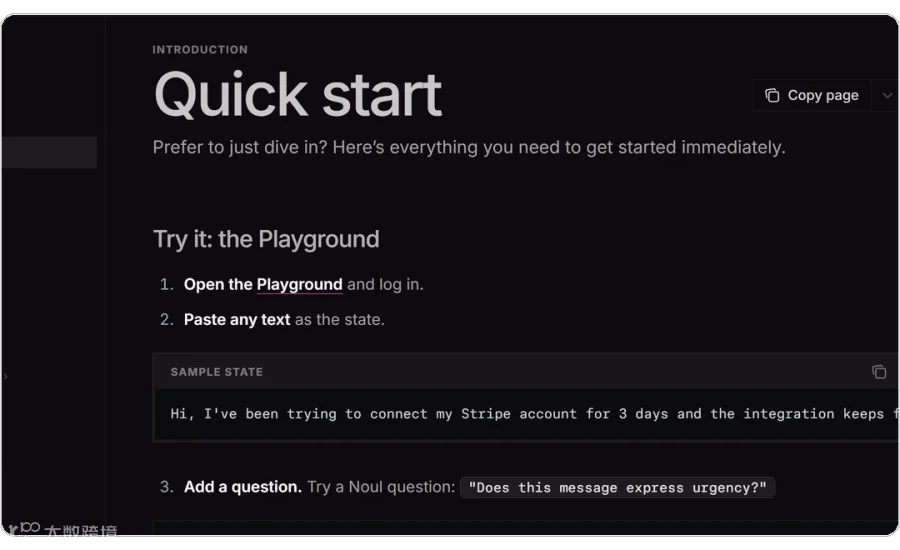
官方 Quickstart:贴一段现场文本、提一个判断问题,就完成一次调用。
图源:TypeSafe 官方文档(typesafe.ai,2026-09-22 取)
官方把 Jev 定位成「系统 1」模型——心理学里那种快思考:高频、海量的直觉判断。下一步调用哪个工具、任务完成没有、这条内容过不过审。
复杂推理留给 GPT、Claude 这些「系统 2」。一个 Agent 每天要做的,恰恰是几百万次小决定,而不是几次深度思考。

Agent 的两套系统:生成模型负责想,判断模型负责反应。
示意图:据 TypeSafe 官网资料绘制|取数 2026-09-22
把人从回路里拿出来
Jev 的来历,比它的参数更有意思。
主导开发它的 Diogo Almeida,正是当年在 OpenAI 参与 RLHF(基于人类反馈的强化学习)和 InstructGPT 的研究员——这套方法直接催生了 ChatGPT。
用他自己的话说:参与发明 ChatGPT 之后,他一直在想一个问题——为什么超人级别的聊天模型,并没有带来 AGI?
他的答案指向了 RLHF 本身:它训练模型学会「什么样的回答人更喜欢」,这让模型擅长讨好,也擅长过度承诺。
TypeSafe 官网那篇宣言的标题就叫「We Took The Opposite Research Direction」——我们走了相反的研究方向。
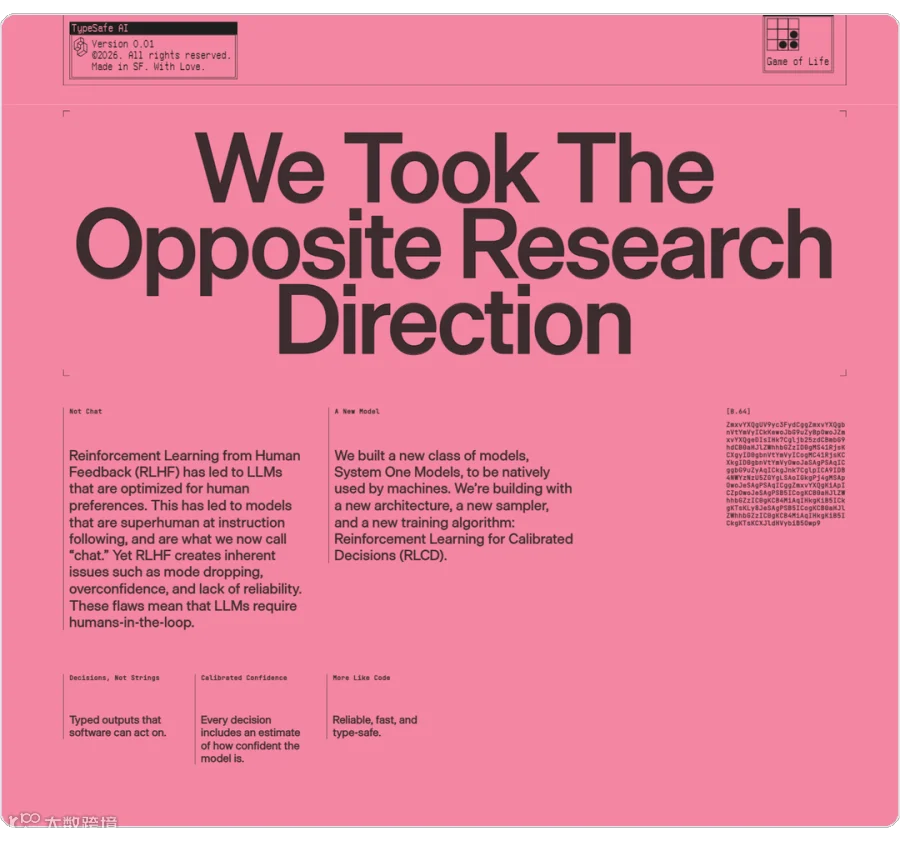
RLHF 造就了会讨好的聊天模型;TypeSafe 反向而行,用 RLCD 训练会交代把握的判断模型。
图源:TypeSafe 官网《We Took The Opposite Research Direction》(2026-09-22 取)
于是有了那组扎心的对比:AI 已经能挑战高等数学,但企业还是不敢把「这单要不要退款」交给它自己决定。
他的判断是:今天的 AI 擅长「协助」,还不擅长「自动化」。协助是人坐在屏幕前检查;自动化是人根本不在场。
Jev 换的训练方法叫 RLCD——Reinforcement Learning for Calibrated Decisions,面向校准决策的强化学习。
目标不是让模型说得更漂亮,而是输出校准过的概率:模型不光给答案,还要交代自己有几成把握。

置信度路由:90% 以上直接执行,70–90% 交更强模型复核,70% 以下转人工。
动作卡:依据 TypeSafe 文档 Confidence-gated routing 绘制(2026-09-22)
拿到 95% 的判断就自动执行,拿到 60% 的判断就退回给人。自动化的闸门,是置信度,不是流畅的文笔。
火的原因:缺口撞上了价格
回头看,Jev 走红不是偶然,三件事刚好叠在一起。
第一,Agent 时代真的到了。去年大家还在聊「AI 帮我写」,今年都在搭「AI 自己跑」。
跑起来的 Agent 每天产生海量小决策:用大模型判断,又慢又贵;用规则脚本,又写不过来。这个缺口一直空着。
第二,价格把心理门槛打穿了。官方口径:输入每百万 Token 0.042 美元,输出免费;单次判断几十毫秒,成本约 0.000015 美元。
5 美元送出 1.2 亿 Token,开发者等于白拿一个实验室。

官网大字:快 193.6 倍、便宜 444.6 倍——脚注注明基于系统 1 任务工作流(官方 Proof 口径)。
图源:TypeSafe 官网(2026-09-22 取)
第三,社区用脚投票。上线几天,有人写插件把 Claude Code 约 100 万 Token 的上下文压缩到 8.6 万——不靠摘要,靠逐条打分。(来源:社区项目公开仓库,2026-09-22)
mobile-jev 在安卓真机 21 秒跑完 9 步 Uber 预约,全程零文字;LangChain 在测它做评估器。(来源:社区项目公开仓库及 LangChain 公开动态,2026-09-22)
第三方实测:有开发者经 OpenRouter 压测 791 次,中位 0.33 秒、最慢 1.42 秒——比官方口径保守,但仍远快于生成式方案。(来源:第三方实测公开记录,2026-09-22)
它不抢 ChatGPT 的活,也没法抢
把 Jev 放进坐标系里看,会更清楚它的位置。
对通用大模型,它是分工不是替代:生成模型负责理解复杂问题、写方案、做推理;判断模型负责在执行链路里做高频裁决。一个是大脑,一个是脊髓反射,缺了哪个都跑不顺。
为什么能这么快?生成模型一个字一个字往外蹦(自回归),Jev 直接并行采样出整个判断分布。官方口径端到端 70–500 毫秒;而前沿模型做复杂推理,慢到 3 秒甚至 5 分钟以上。
对传统分类器,Jev 的优势在输入:分类器只认固定字段和标签,它读得懂非结构化的现场——一段对话、一封邮件上下文。
部署门槛因此从「标注数据+训练模型」,降到「一句话描述判断标准」。
边界也很清楚:它不回答开放问题,不产出内容,不解释自己。你没法让 Jev 写一篇文章——比如你正在读的这篇。
谁已经在用它干活
从社区项目看,最高频的场景有五类:
一是 Agent 的任务验收员——判断子任务是否真的完成,堵住「嘴上说做完了」的漏洞;二是上下文管理——在长对话里逐条打分,把无关内容清出窗口。
三是广告与内容运营——有开发者用它 40 秒分析 724 条实时广告、做出 8724 次判断,这种高频裁决正是投放优化和素材筛选的日常。(来源:广告运营公开案例,2026-09-22)
四是风控审核——通过、拦截、转人工三分类,天然匹配它的输出形态;五是端侧与数据库自动化——mobile-jev 和 pg-jev 这类项目,把概率判断直接嵌进手机操作和数据查询。
对做出海产品的人来说,意义更直接:投放素材筛选、多语言内容合规预审、Agent 客服风险分级,都是「量大、单次简单、错了有代价」的判断任务。
把重复判断交给机器、把决策留给人——这也是我们在 AdsZera 里实践同一件事的原因。
冷思考:三件事要盯住
热度之外,有三件事值得保持清醒。
一看第三方基准。193 倍、444 倍来自官方 Proof 页,脚注写明「基于系统 1 任务工作流」,官方自己也承认这是「较高端」口径;独立基准出来之前,别下重注。
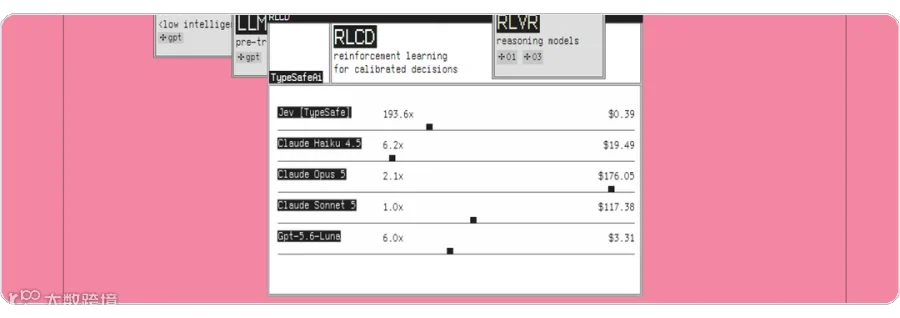
官方基准页:Jev 与多家前沿模型在自动化工作流任务上的速度与成本对比(官方口径)。
图源:TypeSafe 官网基准页(2026-09-22 取)
二看能力边界。Jev 成立的前提是「任务能被拆成判断题」,拆不了的复杂任务仍要回到大模型。
三看商业化持续性。0.042 美元/百万 Token 更像抢生态的进攻价,等对手跟进,「判断层」的军备竞赛才真正开始。
可以基本确定的是方向:AI 行业正从「一个更聪明的模型」走向「一组各司其职的模型」。会聊天的负责理解世界,会判断的负责执行世界。这可能是 Agent 时代关键的架构分工之一。
最后,给你一个可以直接拿走的东西
判断一个任务适不适合交给 Jev 这类判断模型,看三个特征:
1. 输出是有限选项——通过、拦截、A/B/C、0 到 10 分,而不是一篇文章;
2. 高频重复——每天成百上千次,人力盯不过来;
3. 错误可分级——低置信度的判断能退回给人或更强的模型兜底。
三个都满足,它大概率能帮你把成本降一到两个数量级。
