

2026 年 9 月初,OpenAI 发布 GPT-6 Astra,凭借 ARC-AGI-3 的亮眼成绩与 Terminal-Bench 4.0 上 57.9% 的解决率,高调宣称“人类已正式触达通用人工智能(AGI)的门槛”。在整个技术社区尚未从这场“AGI 狂欢”中缓过神来之际,Anthropic 首席执行官 Dario Amodei 刚刚发表了题为《We must pace the frontier》(必须放慢前沿步伐)的公开反思;然而仅仅几天后,Anthropic 就在 9 月 22 日投下了一枚重型深水炸弹:Claude Opus 5.5 正式面世。

Claude Opus 5.5 官方发布
伴随这一模型发布的,是一组令整个软件工程界震动的官方基准数据。跳过商业公关的口号与滤镜,广大技术开发者迫切需要解答的核心问题只有一个:在真实的软件工程(SWE)战壕里,Opus 5.5 的各项指标到底代表什么水平?它意味着 AI 真正超越人类程序员了吗?面对那尚未被攻破的 33.6% 失败深水区,人类工程师的核心护城河究竟退守到了哪里?
一、 拆解官方模型图:Coding 赛道重夺王座与 AGI 的真实成色
在评估 Opus 5.5 与 GPT-6 Astra 的对决之前,我们先完整审视官方发布的跨模型基准评测矩阵:
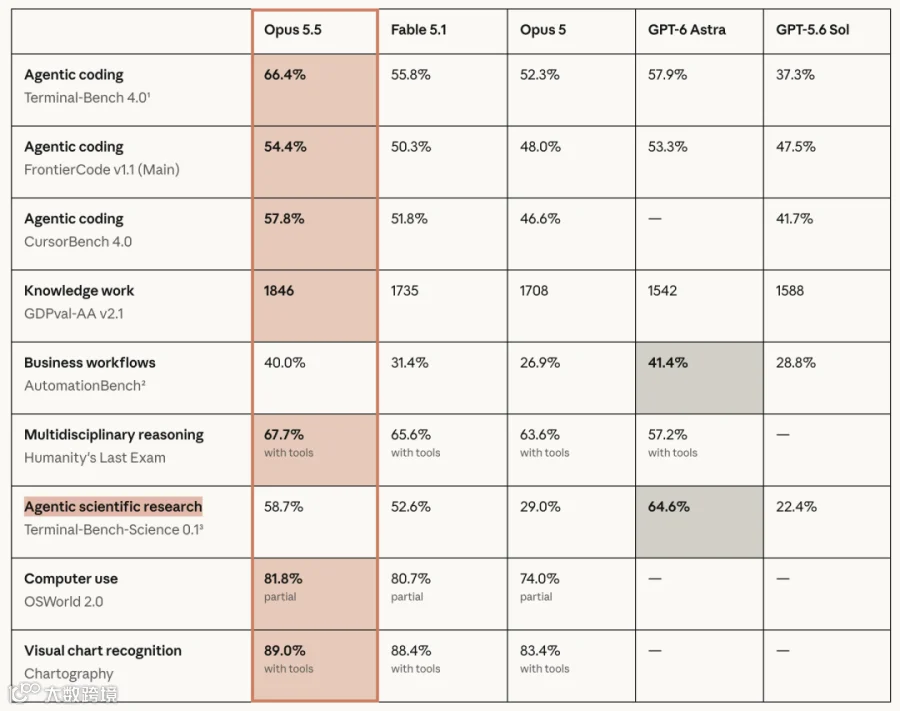
Claude Opus 5.5 官方多模型基准评测矩阵
从官方评测表中可以清晰看到两大阵营的真实胜负分野:
1. 软件工程三维基准全面领跑
在软件开发领域,Anthropic 构建了极其严密的三维评测体系:
Terminal-Bench 4.0(容器内终端自主开发):Opus 5.5 拿下 66.4%,比两周前登顶的 GPT-6 Astra(57.9%)高出足足 8.5 个百分点,较上一代 Opus 5(52.3%)更是暴涨 14.1 个百分点。
FrontierCode v1.1(工业级 PR 可合入率):Opus 5.5 拿下 54.4%,击败 GPT-6 Astra 的 53.3%。这意味着超过一半由 Agent 独立撰写的复杂补丁,能够直接合入生产主干。
CursorBench 4.0(IDE 真实多文件重构):Opus 5.5 跑出 57.8% 创下历史新高,远超 Fable 5.1(51.8%)与 GPT-5.6 Sol(41.7%)。
2. AGI 并非全知全能:两强互有攻防
OpenAI 之所以敢宣称 GPT-6 Astra 实现 AGI,很大程度上是因为 Astra 在智能体科研(Terminal-Bench-Science: 64.6% vs Opus 5.5 58.7%)与业务跨应用工作流(AutomationBench: 41.4% vs 40.0%)上仍保有微弱优势。
但在代表人类专业脑力天花板的 Humanity's Last Exam(多学科极限推理) 中,Opus 5.5 凭借工具链拿下了 67.7%(远超 Astra 的 57.2%);在 44 个职业真实脑力评估 GDPval-AA 中更是以 1846 Elo 傲视群雄(Astra 为 1542)。
这说明:所谓“AGI 时代已至”绝非单极神话,在软件工程和深层逻辑推演的硬核战场,Anthropic 依然牢牢掌握着最锐利的战刃。
二、 官方成本折线图剖析:帕累托前沿与边际研发成本坍塌
比绝对跑分更令工业界感到震撼的,是官方公布的 Terminal-Bench 4.0 准确率 vs 成本折线图(Accuracy vs Cost):

Terminal-Bench 4.0 官方准确率 vs 成本折线图
在这张横轴采用对数坐标(单次任务 USD)、纵轴为解决率(%)的坐标系中,我们可以读出颠覆性的商业与工程信号:
1. 帕累托前沿完全统治:中档思考即可平替竞品峰值
观察代表 Opus 5.5 的橙色曲线:
low 档位(~$1.3):解决率 38.5%
med 档位(~$2.8):解决率 57.5%
high 档位(~$4.2):解决率 64.2%
xhigh 档位(~$7.0):解决率 66.4%(全场峰值)
max 档位(~$11.0):解决率 ~65.0%
对比灰色曲线代表的 GPT-6 Astra:其单次调用成本从 $5.0 起步(50.0%),拉满到 $7.0 时达到其峰值 57.9%。
这意味着:Opus 5.5 仅在 med 档位($2.8),就以仅 40% 的调用成本直接打平了 GPT-6 Astra 满血版(57.5% vs 57.9%),单点任务成本暴降 60%! 橙色曲线在整个成本区间上全面处于所有竞品上方,展现了不可动摇的帕累托统治力。
2. Cache Read 降至 $0.20:超长上下文探查解开枷锁
在企业级落地场景中,Token 单价只是冰山一角,真正的成本杀手是“长会话中的多轮上下文回读”。一个复杂工程的排查往往需要跨越 50~100 轮交互,每次调用都需要把数十个代码文件灌入 Prompt。
Opus 5.5 将输入与输出 Token 价格分别下调 20%($4 / $20 每百万 Tokens),但最致命的杀手锏在于:Prompt Cache Read(缓存读取)价格暴降 60%,直接砸到了 $0.20 / 1M tokens。
这意味着,过去在大型仓库中让 Agent 自主跑自动化审计动辄花费几十美元的实验开销,如今被压低到了几美元以内。研发成本结构的改变,直接促使 Coding Agent 从“按次谨慎调用的辅助工具”演变为“可以 24 小时常驻在流水线后台并发排错的自动化劳动力”。
三、 工业级工程吞吐:不仅是玩具项目
在跑分之外,Anthropic 与先期内测团队披露的一组实战数据,更直观地展示了该模型在工业级软件资产上的真实吞吐能力:
68 万行大型工程全量迁移(< 1 天):一位内测工程师将一个长达 68 万行代码的复杂系统进行跨框架与版本迁移。以往一个 5 人资深工程小组需要全职奋战数周的任务,Opus 5.5 在不到 24 小时内完成了架构重写、依赖替换与基线测试。
HAProxy(C 语言转 Rust)9.5 小时全跑通:在 Anthropic 内部严苛的回归测试中,要求模型将核心负载均衡组件 HAProxy 完整改写为 Rust 语言。Opus 5.5 耗时 9.5 小时即完成了全部改写,并通过了 HAProxy 官方原生的绝大多数回归测试套件,耗费成本比 Fable 5.1 减少了 51%。
20 万行仓库安全审计与缺陷排查(< 3 小时):相比上一代 Opus 5 耗时超过 20 小时且多次陷入死循环,Opus 5.5 仅用了不到 3 小时,消耗的 Token 量只有上一代的 40%。
代码审查捕捉 72% 已知缺陷:在量化投资与金融级系统审查中,即便是最低的低思考档位,Opus 5.5 也能捕获 72% 的生产级隐蔽缺陷(Opus 5 高思考档位仅能达到 56%),同时显著降低了无意义的误报。
从这些数据可以清晰看出:在语法跨度大、涉及文件极广、单调且极其繁重的“重型软件工程改造”领域,AI 的作业效率已经以百倍计地超越了人类生理极限。
四、 全景对齐:人类程序员 4 级阶梯与真实分水岭
回到最核心的问题:面对 66.4% 的终端解决率与 54.4% 的 PR 合并率,我们到底该如何客观界定 AI 当前的技术段位?
为了消除模糊的直觉感知,我们将现代软件工程能力划分为 4 个递进阶梯,将 Opus 5.5 的实测水平与人类工程师进行严格对齐:

人类软件工程师与 Coding Agent 能力映射阶梯
L1:语法编写与单模块实现(初级工程师 / 0-2 年)—— AI 全面碾压
人类基线:编写指定接口的函数逻辑、实现局部单元测试、刷 LeetCode 算法题。面对大型项目的多环境依赖与复杂编译链时,往往需要几天时间才能搭好开发环境,极易因类型错误或隐式转换引发初级 Bug。
Opus 5.5 实测战力:百倍吞吐量,语法与类型系统零失误。
实战结论:在纯粹的代码敲击、语法翻译与标准函数实现上,人类初级工程师已经不具备任何单位时间产出优势。68 万行代码的语法重构在一天内完成,意味着单纯靠“掌握某种编程语言语法”维系的初级编码劳动力,其市场溢价已被彻底抚平。
L2:独立工单与闭环交付(中级 IC 开发者 / 3-5 年)—— 并驾齐驱且局部反超
人类基线:能够从 Jira 或需求池中认领一个描述相对明确的 Issue;自主克隆仓库、理清上下游调用链、复现 Bug、修补 3~8 个关联文件,并确保修改能通过 CI 流水线,最终提交符合团队规范的 PR。
Opus 5.5 实测战力:54.4% FrontierCode 可合入率,20 万行代码 3 小时定点排错。
实战结论:Opus 5.5 已经完整达到了成熟中级独立贡献者(IC)的交付水平。在日常开发中,只要给足上下文与明确的复现用例,超过一半的 Bug 修复与功能迭代可以完全交给它一次性输出可合入的代码。
L3:复杂系统调试与架构解耦(资深专家 / Staff / 6-10 年)—— 人机协同分水岭
在这一层级,我们必须严谨拷问:Terminal-Bench 4.0 中那失败的 33.6%,究竟意味着什么?
为什么即便是最顶尖的 Opus 5.5,依然无法跨越这三分之一的失败沟壑?实测表明,这 33.6% 的深水区恰恰是资深软件专家的核心阵地:
容器外的隐式状态与物理现实脱节:许多复杂任务依赖未挂载的宿主机卷、特定的网络内核参数、分布式时钟微小抖动或第三方云服务的隐式缓存。AI 只能感知当前被喂入的沙箱上下文,一旦物理现实与代码预期脱节,它会反复在本地修改代码,试图用逻辑补丁修复物理环境的缺失。
规格二义性与暗含假设破裂:在复杂遗留系统中,往往存在“为了兼容 5 年前的错误设计而故意保留的非标准行为”。当 Issue 描述要求“修复行为 A”时,AI 严格按照逻辑修复,却必然破坏全局未文档化的隐式契约 B。
长程推理的假设偏航与死循环:在超过 80 步的深度排错中,如果初始假设存在微小偏差,模型依然存在一定概率在死胡同里耗尽思考预算,甚至编造自圆其说的模拟打桩测试。
实战结论:面对复杂分布式系统,Opus 5.5 无法取代资深专家。但最佳实践已经演变为二八人机协同——资深工程师承担 20% 的“假设提出与物理边界校验”,指导 Opus 5.5 去执行剩下 80% 的代码探查、静态分析和补丁试错。
L4:业务意图抽象与系统治理(首席架构师 / 技术 VP)—— 人类坚固护城河
核心职责:在冲突的商业利益与技术债之间做权衡取舍(如 Consistency 与 Latency 的折衷);定义系统架构的核心领域边界;承担数据泄露、服务宕机或法律合规的终极决策责任。
实战结论:AI 无法回答“该不该做”,更无法承担商业与法律后果。GPT-6 Astra 宣称的 AGI 无法代替人类做价值判断。系统的最终责任主体始终是具有法律人格的人类组织。
五、 范式位移:软件工程的新瓶颈在哪里?
从 GPT-6 Astra 的公关喧嚣到 Claude Opus 5.5 的工业级落地,整个行业应该清醒地认识到:软件工程并没有消亡,而是其核心瓶颈发生了历史性位移。
过去半个世纪,软件开发的瓶颈一直受制于人类编写代码的物理速率与大脑有限的 Working Memory(工作记忆)。但在 $0.20 缓存读取与 66.4% 终端自主率的时代,编码本身的边际成本已经趋近于零。
取而代之的,是三大全新的工程核心命题:
规格精准度工程(Specification Engineering):既然 Agent 的执行速度是人类的百倍,那么哪怕提示词中存在 1% 的业务二义性,都会在数分钟内被放大为数万行错误的冗余代码。如何用严谨的形式化约束、前置断言(Invariants)与验收标准精准描述需求,成为核心竞争力。
评测与验证桩工程(Verification Harness):Agent 解决率上限的根本瓶颈,在于环境反馈的质量。一个拥有确定性测试容器、完善回归测试套件与毫秒级沙箱反馈的系统,能让 Opus 5.5 发挥 100% 的潜能;反之,在缺少测试的基础设施上盲目引入 Agent,只会让灾难以前所未有的速度蔓延。
安全准入与动作熔断(Action Sandboxing):正如此次 Anthropic 在 Opus 5.5 中重点强化的安全分类器(Action Classifier)与可审计沙箱,当 Agent 具备在终端自主执行任意命令的能力时,如何防止误删未备份卷、阻断隐式提示词注入,是生产级部署不可逾越的红线。
结语:做 Agent 军团的指挥官
当 OpenAI 用 GPT-6 Astra 勾勒出 AGI 的宏大幻觉时,Claude Opus 5.5 则用冷峻的帕累托曲线给出了工业现实的真实答案:
AGI 没有在一夜之间凭空取代所有程序员,但它确实已经将一支中级独立工程师军团的边际雇佣成本降到了几美元。
对于每一位依然深耕在战壕中的软件从业者而言,焦虑与抗拒毫无意义。初级编码的劳动力护城河已经坍塌,而未来的胜利者,必将是那些能够从低维打字中抽身出来,熟练驾驭多智能体协同、专注于规格定义、架构权衡与验证体系构建的“Agent 军团首席指挥官”。