


导读真正部署模型时,工程师要回答三个问题:PTQ、QAT、动态和静态量化分别描述什么?校准数据在估计什么?为什么 LLM 的权重量化与 YOLO 一类视觉模型的端侧量化,常常采用不同路线?本文把训练时机、激活校准和转换生命周期拆开说明,再用访存、算力与硬件支持解释两类模型的选型差异。
本文 4999 字,阅读约 12 分钟|先把量化问题拆开:算法、数据与部署位置 → 量化的两个维度:训练时机与激活参数的取得方式 → 校准(Calibration)到底在校准什么? → 模型从训练到部署,量化通常在哪一步完成? → 从云端自回归 LLM 到边缘密集感知模型:为什么常见量化路线不同? → 总结与后续实战预告
先把量化问题拆开:算法、数据与部署位置
当我们要把一个真实的 PyTorch 浮点模型部署到服务器或边缘芯片时,工程问题通常集中在三个层面:
“我该选 PTQ 还是 QAT?动态量化和静态量化有什么区别?”
“校准(Calibration)到底在算什么?为什么有些量化需要校准集,有些却不需要?”
“量化到底发生在导出 ONNX 之前、转换 GGUF 之中,还是编译 TensorRT Engine 之时?”
别再把格式和量化混为一谈:从 IEEE 754、FP8/FP4 到对称非对称推导
要回答这些问题,先要把两个经常被混在一起的维度拆开:PTQ/QAT 描述量化发生在训练之后还是训练过程中;动态/静态量化描述激活的量化参数是在运行时取得,还是在部署前固定。
量化的两个维度:训练时机与激活参数的取得方式
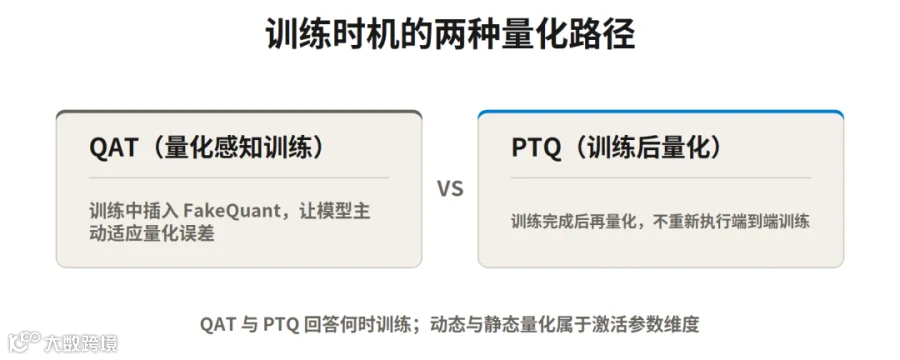
因此,PTQ、QAT、动态量化和静态量化不是同一层级的四个互斥流派,而是两个可以交叉组合的分类维度。实际工具未必支持所有组合,具体还要看框架和硬件:
维度一:量化在训练后还是训练中
PTQ(训练后量化,Post-Training Quantization)
原理:模型训练完成后,再为权重、激活或二者确定低比特表示,不进行端到端反向传播。
特点:部署改造成本较低。只量化静态权重时可以直接从权重统计参数;涉及激活时,通常还需要代表性数据做校准。
QAT(量化感知训练,Quantization-Aware Training)
原理:在模型微调训练中插入 伪量化节点(FakeQuant)。前向传播模拟定点截断与舍入噪声,反向传播利用直通估计器(STE,Straight-Through Estimator)跨越不可导的舍入函数更新高精度浮点权重。
特点:模型在训练期主动适应量化噪声,通常能换取更好的精度,但需要额外训练算力和调优周期;是否需要标签取决于训练任务。
工程上通常先尝试 PTQ,并在目标数据和设备上验证精度、速度与资源占用;如果量化后精度达不到任务要求,再评估 QAT 是否值得投入。QAT 是改善量化后精度的一种选择,不是 PTQ 必须接续的步骤:若项目已有合适的训练数据、算力和工具链,也可以从一开始就把 QAT 纳入方案比较。具体还要确认目标硬件支持相应量化格式和算子。
维度二:激活量化参数何时确定
动态量化(Dynamic Quantization)
原理:至少部分激活量化参数在模型运行时根据当前输入取得,权重是否离线量化取决于具体实现。
优缺点:通常不依赖离线校准集,但要在推理时统计分布并计算量化参数,可能增加运行期开销。
静态量化(Static Quantization)
原理:在部署前固定量化参数,常见做法是用代表性数据统计激活范围,再写入模型或编译产物。
优缺点:更容易使用专用低精度算子,但校准数据必须覆盖实际输入分布;“静态”只表示量化参数提前确定,不等于整个模型或整条链路都必须是 INT8。
这里要把“静态”和“INT8 / W8A8”分开看:静态量化强调激活量化参数在部署前确定;INT8 表示 8 位整数精度,W8A8 则明确权重和激活都采用 8 位表示。许多静态 INT8 全整型方案采用 W8A8,但模型也可能只量化部分张量、让部分算子保留 FP16 或 FP32,不能只凭“静态 INT8”断定全模型都是 W8A8。反过来,W8A8 也可以在推理时动态确定激活参数,所以两者不是同义词。
校准(Calibration)到底在校准什么?
校准数据是一组有代表性的输入样本。量化工具把它们送入模型做前向计算,观察各层产生的激活值,或提取算法需要的输入相关统计,再据此确定量化范围、缩放系数等参数,或减少权重量化误差。它通常用于估计和调整量化方式,不是拿来重新训练模型;校准过程一般不通过反向传播更新原模型权重。
要注意,使用了校准数据,不等于激活也被量化。权重(W)是模型训练后保存的参数,激活(A)是输入经过各层计算产生的中间值;权重量化作用于 W,激活量化作用于 A。
静态激活量化会用校准样本估计激活的量化参数。AWQ(Activation-aware Weight Quantization,激活感知权重量化)和 GPTQ 都属于 Weight-Only(仅权重量化):它们只把权重压到低比特,也会利用代表性输入中的统计改善权重量化;推理时的激活仍可保持 FP16。
1. 为什么“朴素权重量化”不需要校准数据?
权重矩阵是训练后固化在磁盘上的静态张量。对于简单的 Min-Max 映射,算法直接遍历权重矩阵找出最大值和最小值即可估计 Scale(缩放系数)与 Zero-Point(零点),与外部输入数据无关。这里说的是“只量化权重”的简单情况,不代表所有权重量化算法都不需要校准样本。
2. 为什么“静态 W8A8(常见的静态 INT8)”通常需要校准数据?
输入特征图(Activation,激活值或激活张量)是由用户输入的图片或文本经过前面多层网络动态计算生成的。它不是像权重那样固定保存在模型文件中的参数,而是随数据流在各层之间传递的中间结果;以线性层为例,可以粗略写成 X × W + b = Y,其中 X 和 Y 都是激活值,W 是权重,b 是偏置。在模型真正运行之前,没有人知道激活值的动态范围是多少。
如果直接把少量样本中的极值当作量化范围,可能掉入离群点陷阱(Outliers)。例如,一层激活的大多数值集中在较窄区间,少数通道却出现远高于主体分布的尖峰。校准并不是“找到一个永远正确的最大值”,而是在代表性输入上估计一个能平衡截断误差与离散化误差的范围。
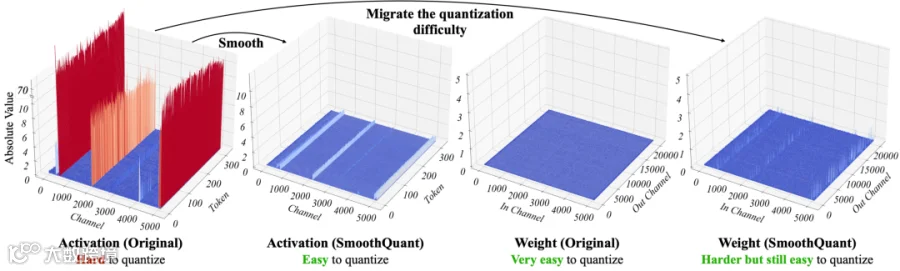 图片说明:OPT-13B 模型中激活值在特定通道出现极端离群尖峰(左)而权重分布均匀(右) 图片来源:SmoothQuant 论文
若按极端最大值确定 Scale,整数刻度会被稀疏尾部占用;
主体分布获得的有效刻度变少,量化误差可能明显增大。
校准的任务,就是用具有代表性的输入跑前向传播,收集各层激活分布,再根据误差目标选择范围或截断阈值。样本数量没有脱离模型和业务分布的固定答案:少了可能覆盖不足,多了则增加构建成本。
3. 均匀量化与非均匀量化:量化步长是否相同
这里还要区分量化映射本身的两种形式:
均匀量化:相邻整数码值对应的实数间隔相同,通常由一个 Scale 和可选的 Zero-Point 完成映射。它结构简单,容易映射到 INT8/INT4 的矩阵乘法,是工程部署中最常见的形式。
非均匀量化:可表示数值之间的间隔不相等,例如浮点格式按指数和尾数编码,或通过码本映射。它能否更好保留某类数据分布,取决于具体格式和数据本身;部署效率还取决于硬件支持。
Min-Max、KL 散度和 MSE 都是为低比特量化选择范围或编码参数的方法;即使使用 KL 做校准,最终仍可能采用等间隔的 INT8 映射,不能把“校准方法”直接等同于“非均匀量化”。同样,均匀/非均匀描述数值映射方式,PTQ/QAT 描述训练时机,动态/静态描述量化参数何时取得,它们属于不同的分类维度。
4. 破除误区:为什么 LLM 的仅权重量化在激活保持 FP16 时,仍需要校准数据?
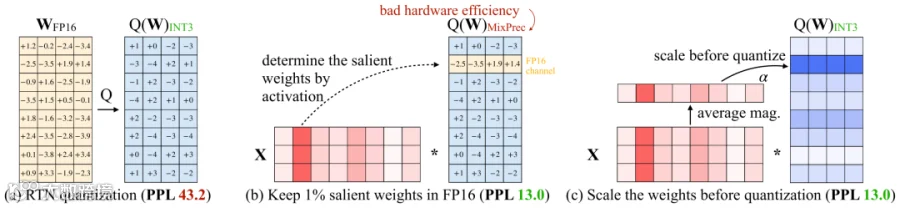 图片说明:AWQ 算法通过观察输入激活特征识别显著权重通道并进行缩放保护 图片来源:MIT HAN Lab (AWQ 论文)
AWQ: 虽然激活值最终不做低比特量化,AWQ 仍会离线观察激活统计,识别与显著权重相关的通道,再通过等价缩放保护这些权重。论文用“约 1% 的显著权重”说明保护少量重要参数的思路,不应把它理解成所有模型都固定为 1%。
GPTQ: GPTQ 用近似二阶信息指导逐列量化和误差补偿,因此需要校准样本来估计输入相关的曲率信息。没有这类样本,就无法按 GPTQ 的原始流程完成同样的误差补偿。
结论:是否需要校准,取决于量化对象和算法。只量化静态权重的简单方法可以不看业务输入;激活量化、AWQ、GPTQ 等需要利用输入分布或输入相关统计的方法,则需要代表性校准数据。
模型从训练到部署,量化通常在哪一步完成?
在工程实践中,量化可能出现在三个位置。它们不是互相排斥的流水线,也不是所有模型都必须完整经过三步:具体位置取决于模型格式、量化工具和目标硬件。
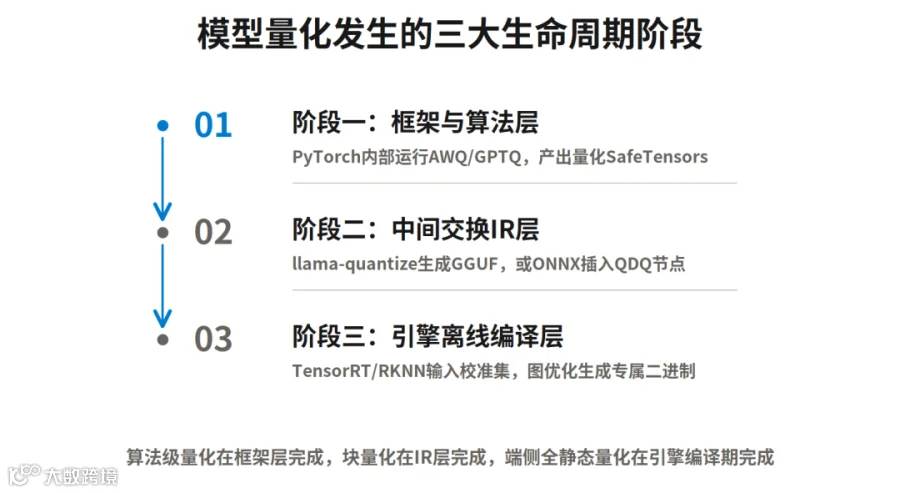
阶段一:在训练框架或模型工具中处理量化
这里说的是量化在模型工具链中的处理位置,不是在定义一种新的量化类型。这个阶段既可能发生在训练完成后,也可能发生在训练过程中:
PTQ(训练后量化):模型训练完成后,再用权重统计或代表性输入计算量化表示。LLM 常见的 AWQ、GPTQ 属于这类训练后权重量化方法;不同工具对校准数据和模型格式的要求并不相同。
QAT(量化感知训练):在微调训练中加入伪量化操作,让模型适应量化误差;训练结束后,还要把训练得到的模型转换或导出为推理使用的量化模型。因此,QAT 的训练发生在这一阶段,但最终部署产物可能在后续转换步骤中生成。
PyTorch 及其周边 Python 工具链都可承载这些流程;具体能力取决于所用库、配置和目标后端。.safetensors 只是容器,具体量化布局和下游兼容性仍由工具链约定,保存成 SafeTensors 本身不会自动获得 INT4 加速。
阶段二:在中间交换表示层量化(IR 转换阶段)
llama.cpp 的 GGUF 路径通常先用 convert_hf_to_gguf.py 转换模型,再调用 llama-quantize 对张量做逐块量化。这一步通常可以在 CPU 上完成;是否能被 Ollama 或 LM Studio 使用,还要看对应版本支持的 GGUF 类型。ONNX 路径则可以用 ONNX Runtime 的量化工具插入 QuantizeLinear 和 DequantizeLinear 节点,生成显式描述量化过程的计算图。
这里的“ONNX 路径”要看具体使用的工具:若使用 ONNX Runtime 做静态量化,校准数据用于预先计算激活量化参数,量化节点和参数会写入量化后的 ONNX 图;若只是把浮点模型导出为 ONNX,导出本身并不代表已经量化。若目标是 Rockchip NPU,常见做法则是把浮点 ONNX 交给 RKNN-Toolkit,在构建 .rknn 模型时启用量化并提供校准数据。两条路线都在部署前处理,但量化发生在不同工具步骤,参数也进入不同产物:一个是量化 ONNX,另一个是构建出的 RKNN 模型。若输入 ONNX 已经包含 QAT 量化信息,RKNN 构建设置也要相应调整,不能默认再按浮点模型流程校准量化。
阶段三:在推理引擎离线编译阶段量化(Engine / NPU 专属格式)
以 TensorRT 和 RKNN 为例,工具链可能在构建阶段读取已有 Scale,或运行代表性数据估计激活范围,再生成面向目标运行时的 engine 或芯片专属模型。TensorRT 10.x 的传统 calibrator 是其中一种 PTQ 路径;TensorRT 11.x 已移除这组 calibrator 接口,改为先离线量化模型(例如用 ModelOpt)或显式提供 Q/DQ,再构建 engine。不能把旧版接口当成所有版本的通用流程。最终产物通常不是可迁移的普通权重文件,具体兼容范围由引擎和芯片工具链决定。
从云端自回归 LLM 到边缘密集感知模型:为什么常见量化路线不同?
工程视角注记:下文用 YOLO 代表一类端侧密集视觉模型,是为了便于对照,不代表所有视觉模型都遵循同一量化路线。具体方案仍要看算子、输出任务、芯片支持和精度验收结果。
下面按瓶颈、精度风险、常见路线和硬件约束对照两类场景。表中描述的是工程倾向,不是对所有模型和硬件的绝对分类。

1. 深度辨析:为什么同一种低比特格式不能直接横向套用?
在技术选型中,常见误区是把“某种格式在一种模型上有效”直接推导成“所有模型都应该采用它”。
更稳妥的判断方式是同时看三件事:数值误差是否落在任务可接受范围内,目标硬件是否有对应算子,以及编译器是否能把模型完整映射到这些算子。
① 误差落在哪里:生成质量与几何输出不是同一种验收
LLM 的重点:自回归生成时,权重搬运和激活离群会影响量化误差;FP8 等格式能否发挥作用,取决于具体硬件、缩放策略和评测结果。
视觉模型的重点:检测、分割和关键点任务不仅看分类分数,还要看坐标、掩码或关键点误差。低比特格式是否合适,不能只看位宽,必须用目标任务的指标和真实输入验证。
② 硬件精度支持与算子生态
云端 GPU/TPU 往往提供专门的低精度浮点路径,但具体格式、累加精度和算子支持随硬件代际变化。
边缘 NPU 常把 INT8 等定点算子作为重要加速路径,但不同芯片对 FP16、BF16、FP8 或混合精度的支持差异很大。
因此,端侧选型不能从“行业通常使用 INT8”直接推出“某颗芯片一定不支持 FP8”。最终要以芯片文档、编译器日志和端到端精度/性能测试为准。
2. LLM:典型的“访存受限(Memory-Bound)”与 Weight-Only 策略
 图片说明:大模型在自回归生成(Batch size=1)时处于典型的显存带宽受限区(Memory-Bound) 图片来源:AWQ 论文
在自回归生成(Decode)阶段,模型每生成一个 Token 都要反复访问大量权重;当批量较小、算术强度不足时,显存带宽可能成为主要瓶颈。
因此,Weight-Only W4A16/W8A16 常被用来减少权重占用和搬运量。它能带来多少速度收益,仍取决于批量、上下文长度、内核实现和其他访存开销,不能直接承诺固定比例。
3. YOLO 与边缘密集感知:从模型结构到量化部署
面对高分辨率视频流,单纯压缩权重未必能解决卷积和特征图计算的瓶颈。因此端侧视觉部署经常评估 W8A8、算子融合和 QAT 等组合,但是否采用 INT8、FP16 或混合精度,要由芯片支持、模型结构、输入分布和精度目标共同决定。
把模型结构、训练精度和部署量化拆开看,才能避免把架构变化误读成量化结论:
训练时使用 AMP(自动混合精度)降低训练成本,不等于部署时已经完成 INT8 量化;训练精度、权重格式和推理图中的算子精度是三件事。
YOLO26 的结构与训练策略变化属于模型设计层,不能直接推出它已具备通用 INT8 PTQ 零掉点能力,或已适配所有 NPU 的 QAT 流程。
总结与后续实战预告
这篇文章可以先留下四个判断:
1. 格式与量化解耦:格式是承载结构与权重的容器(SafeTensors/GGUF/ONNX/Engine),量化是低比特数值编码与计算规则。
2. 量化参数决定部署行为:激活量化要看输入分布,权重量化要看权重统计;AWQ/GPTQ 则进一步利用输入相关统计来减少误差。
3. 量化位置决定交付物:它可能发生在框架工具、GGUF/ONNX 等中间表示转换阶段,也可能发生在推理引擎构建阶段。
4. 模型和硬件共同决定路线:LLM 常在 Decode 阶段优先压缩权重;端侧视觉模型常评估 INT8、Q/DQ、算子融合和 QAT,但任何路线都要用目标任务和目标芯片验收。
这篇先建立判断框架;后续专题再分别进入大模型格式转换和 YOLO/端侧 NPU 实测,并把具体版本、芯片型号、校准集和精度指标写清楚。
参考资料
1. AWQ 论文(Activation-aware Weight Quantization): https://arxiv.org/abs/2306.00978
2. GPTQ 论文(Accurate Post-Training Quantization for GPT): https://arxiv.org/abs/2210.17323
3. SmoothQuant 论文(Accurate and Efficient Post-Training Quantization): https://arxiv.org/abs/2211.10438
4. YOLO26 官方论文(Ultralytics YOLO26: Unified Real-Time End-to-End Vision Models): https://arxiv.org/abs/2606.03748
5. NVIDIA TensorRT 当前量化文档: https://docs.nvidia.com/deeplearning/tensorrt/latest/inference-library/work-with-quantized-types.html
6. TensorRT 10.x 到 11.x 的量化 API 迁移说明: https://docs.nvidia.com/deeplearning/tensorrt/latest/api/migration/tensorrt-10x-to-11x-c-api-patterns.html
7. ONNX Runtime 量化文档(静态量化、校准数据与 Q/DQ 图表示): https://onnxruntime.ai/docs/performance/model-optimizations/quantization.html
8. Rockchip RKNN-Toolkit2 官方 ONNX YOLOv5 示例(载入 ONNX、校准构建并导出 RKNN): https://github.com/airockchip/rknn-toolkit2/blob/master/rknpu2/examples/rknn_yolov5_demo/convert_rknn_demo/yolov5/onnx2rknn.py
9. Rockchip RKNN-Toolkit2 官方 QAT 示例(QAT 模型构建时的量化设置说明): https://github.com/airockchip/rknn-toolkit2/blob/master/rknn-toolkit2/examples/pytorch/resnet18_qat/README.md
10. PyTorch 量化教程(训练后动态/静态量化与 QAT 流程): https://docs.pytorch.org/tutorials/recipes/quantization.html
11. NVIDIA TensorRT 10.x 量化与传统 INT8 Entropy calibrator 文档: https://docs.nvidia.com/deeplearning/tensorrt/10.x.x/inference-library/work-quantized-types.html
12. PyTorch TorchAO QAT 指南(将 QAT 作为缓解 PTQ 精度损失的可选微调): https://pytorch.org/blog/quantization-aware-training-in-torchao-ii/
13. llama.cpp 官方量化说明(GGUF 转换、量化步骤与 CPU 示例): https://github.com/ggml-org/llama.cpp/blob/master/tools/quantize/README.md
14. Qualcomm AIMET 量化仿真指南(Min-Max 范围估计): https://qualcomm.github.io/aimet-pages/releases/2.7.0/quantsim/index.html
15. Qualcomm AIMET Sequential MSE 指南(MSE 搜索量化编码): https://qualcomm.github.io/aimet-pages/releases/2.1.0/featureguide/seq_mse.html
16. NVIDIA TensorRT 精度说明(均匀与非均匀量化格式): https://docs.nvidia.com/deeplearning/tensorrt/latest/inference-library/accuracy-considerations.html
— THE END —
文章仅做学术分享,如有侵权请联系删除,非常感谢!