
大数跨境

AI原生落到工厂舆情系统,四条硬判据

AI原生落到工厂舆情系统,四条硬判据 AI驱动数字化转型
2026-09-23
10
导读:这件事的技术含量不在于模型有多强,而在于系统有没有把企业自己的说法当主干,有没有把每一步的依据留下来,以及三年之后换一批人接手的时候,这套知识还在不在。
舆情系统的第一代做法是关键词匹配,企业设一批关键词,系统把带这些词的新闻捞回来,按热度排好,交给品牌部的人去看。这套做法能用,但它的天花板写在原理里,机器只认字面,不认关系。
结果就是三个问题机器答不了,一堆材料里哪几条真的跟本公司有关,哪几条其实是同一件事被转了很多遍,以及要不要回话。判断这活仍然落在人身上,人少的时候,判断就漏。

最大的浪费,是让人去做匹配
Part01
企业买舆情系统,通常以为买的是眼睛,其实缺的是判断。一堆材料里哪条跟自己的供应商有关,哪条只是同名的另一家公司,哪条是三个月前的旧闻被翻出来重炒一遍,这些活本该由机器干完,现在却全压在品牌部那两三个人身上。
压久了会出两种事,一种是漏,重要的一条被埋在几十条里没人看见。
另一种更常见,被迫把每一条都当重要处理,反应过度,把评论区的一句抱怨当成危机来办。要让机器接住这活,缺的是让机器听懂这家企业自己怎么说话,模型并不是瓶颈。

本体不是图,是这家企业的说法体系
Part01
先把本体说清楚,因为它被讲得太玄。本体不是数据库里的表,也不是挂在会议室墙上给领导看的关系图。
它是这家企业的说法体系,里面写着有哪些品牌、哪些产品、哪些供应商、哪些区域,它们之间是什么关系,同一个东西有几种叫法。一家电池厂自己说“云帆”,客户说“云帆汽车”,招标文件里写“云帆新能源汽车有限公司”,三个说法指向同一个对象,这套对应关系只有企业自己清楚,任何通用模型都不会知道。
这套系统的主线可以概括成一句话,把每一条舆情接进企业自己的本体,再用本体去判断。拿到一条舆情,它要认三样东西,名字、类型和关系。
  • 名字先归一,文中出现“比亚迪股份有限公司”,在别名表里落到本体节点“比亚迪”;标题里只有“云帆”两个字,它同样认得出这是品牌名。
  • 类型决定读哪几列,产品事故类的事件读产品名、部件、失效现象,服务投诉类的事件读门店、区域、时间,这份对照表写在行业配置里。
  • 关系负责往下传导,一条舆情命中了产品P001,而P001的货来自宁德那家电池供应商,这条舆情就同时落在那家供应商头上,走的是本体里已经写好的对象关系,不是算出来的相似度。
三路做完,一条舆情挂到了几个本体节点上。这家企业现在的演示行业里有75个事件,连出522条这样的关联,每一条都能点开看依据,写明是品牌前缀命中、别名命中,还是由哪条关系传导过来。
有一条旧账值得翻,改之前的版本里,事件和本体的连接靠片段相似度兜底,给出来的二十条边里有十四条站不住。其中一条关于微单相机的新闻,连到了汽车的热管理系统上,凭的是两边都含“系统”两个字。
连错比连不上危险得多,连不上只是少一条,连错了人会按错的方向去处置。现在的规矩是不瞎连,也不装作连上了,没连上的事件如实标成未关联,接口把未关联的条数直接报出来。
说不清依据的判断,交不出去
Part01
判断类的能力最怕出来的只是一个分数、一个标签。人不敢用它,多半是因为不知道它凭什么这么说,只有一个数字是撑不住责任的。
情感判断做了四层处理,否定作用域管住“没有出现自燃问题”这类句子,否定词一出现情绪就要抵消;程度词参与加权,“严重下滑”和“略有下滑”不是一个量级。
实体绑定把情绪落到本体的具体节点上,实在绑不上的按行业上下文降权,不硬给一个高分。算完之后还能复算,输入摘要、模型、当时的本体版本、置信度都记下来,同一句话再跑一遍,结果对得上。
趋势判断同样把过程摊开,滑窗取几个时间点,用最小二乘算斜率,给出拟合优度和置信度的来源。时间点不够就直接写“依据不足,不做趋势判断”,两个时间点连成的线本来也不叫趋势,强行给一个方向,等于让算法替客户背了一个他并不知情的结论。
判断层还有一个容易忽略的坑,这一轮里真踩到了,算好的斜率、样本数、理由、依据点,在接口那一层被丢掉了,前端只拿到一个趋势值,界面看上去正常,依据却没了。
可解释不是写在宣传页上的,它得从算法一路带到屏幕上,中间掉一环就等于没有。

什么叫AI原生
Part01
现在说AI原生,通常指调了某个模型接口,这个口径太松。这套系统用的是另一套判据,四条一起看。
  1. 主干是语义与判断,规则退到兜底:采集进来的内容先过语义筛选,本体别名表在筛选阶段就当约束用,而不是等模型出结果再拿关键词筛一遍。规则没有被扔掉,它在语义判断给不出结论的时候接手,保证系统不掉线。
  2. 知识往外扩,但要人点头:系统从真实事件里抽出候选实体,先放进待确认区,人工确认之后才并入别名表,本体版本加一,现在是第11版。如果让模型自动往母本体里写东西,几次之后错的名词和错的关系就混进了底座,此后所有判断都在脏数据上做。待确认区把这条路堵住,母本体只收被确认过的东西。
  3. 判断可解释,也能复算:前面讲过的依据、摘要和版本记录都落在这条上,同一句话再跑一遍,得出的结论对得上。
  4. 人和agent都能用:对外是接口,再往上收成工具层,agent可以像人一样调它,拿到的不是一段描述,而是带依据的结构化结果。
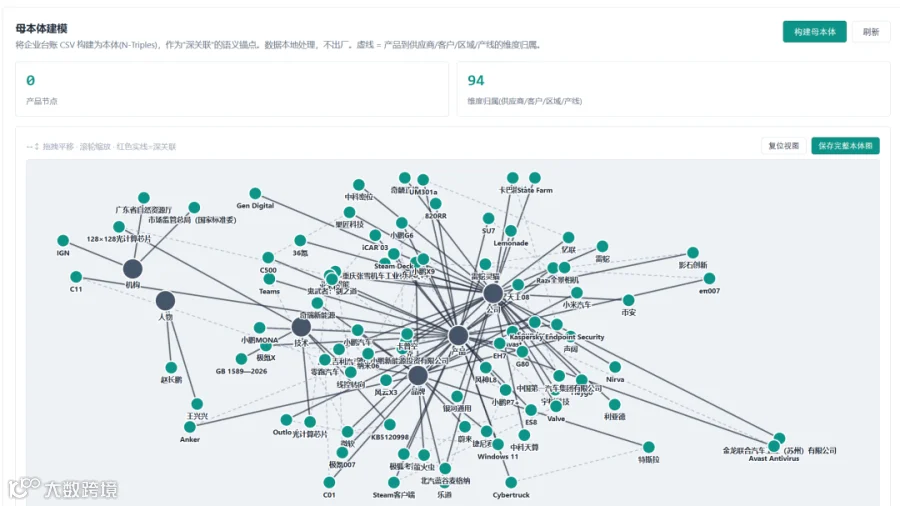
四条当中第二条最难,也最能拉开差距。多数系统的知识是死的,要么半年换一次,要么靠人肉维护,这套系统的本体在往前走,而且走法有审计。

行业开始讲标准的时候,底座带得走吗
Part01
各家企业现在各说各话,同一个行业十家公司十套叫法,数据也不出门。变化已经在发生,威胁情报领域有STIX,知识表示领域有OWL和RDF,方向都是把实体和关系说成一套公共语言,等到行业标准落地,迁移成本由谁承担是个很现实的问题。
这套系统在三处留了接口:
  • 本体能导出,STIX2.1的子集导出已经落地,实测导出276个对象,必备字段校验通过,界面上点一下就能拿到文件。
  • 本体能版本化,母本体慢变、行业共享,事件专属的二次本体快变、跟着事情走。两层分开之后母本体不会被一次热点事件带偏,版本号、指纹、体检结果都记在库里。
  • 换行业不用改代码,行业之间的差别写在一份配置里,包括本体类、关系、事件类型对应的字段和影响列。现在系统里并存三套行业,云帆新能源的合成演示数据、真实科技新闻、阀门行业,顶栏切一下就换,代码一行不动。
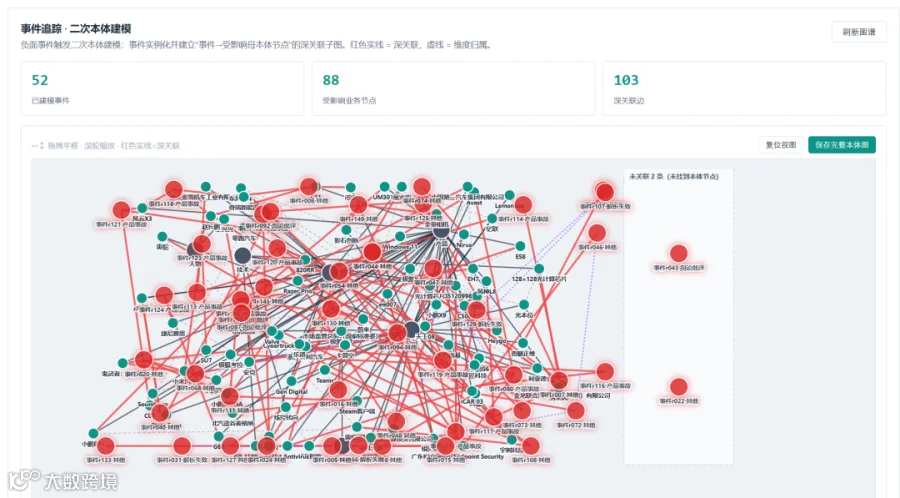
三条加起来说的是同一件事,本体是这家企业的资产,不是某套软件的附庸,资产要能带走、能对上标准、能交给下一个人。

能不能交出去,看的是底座
Part01
数据口径统一在库里,生产环境跑MySQL,十一个业务表,读写以库为准,不回退文件。
权限分开,登录带租户标识,写接口要求操作员权限,租户之间的数据靠库隔离,口令有策略约束,登录失败会累计并锁定,会话过期时间可以配置,审计记录按保留天数归档。
采集有护栏,robots规则、最小采集间隔、联络方式都写进采集网关,个人信息在落库前先做掩码。这两处对着的是《网络数据安全管理条例》里采集影响评估和删除匿名化的要求。
配置能改,十八项参数分四组,分别是模型降级链、采集护栏、预警阈值与静默期、事件簇阈值。取值分三层,环境变量给默认值,库里可以覆盖,界面上能改,每一项都标着当前值从哪里来。模型有降级链,云端在先,本地在后,最后是规则,任何一环挂了都不空转。
这些话不靠嘴说,二十一套验收门在跑,覆盖口令策略、登录限流、配置读写、情感、趋势、事件匹配、簇归并、合规护栏、采集到出报的整条流程和前端链接,这一轮全部通过。
门自己也被修过,有的门把“真数据里必须恰好有缺陷”写成了判据,数据一干净就报红;有的门拿匿名请求去测已经收口的写接口。这类红不是产品坏了,是门写错了,改的是门。一支团队愿不愿意回头修自己的门,比门有多好看更能说明问题。
同样的三个问题,在一套本体驱动的系统里有各自的答案。哪几条跟本公司有关,来自本体里已经写好的品牌、产品、供应商和区域;哪几条是同一件事被转了很多遍,来自事件簇的归并结果;要不要回话,来自每一层判断留下的依据和版本记录。
这件事的技术含量不在于模型有多强,而在于系统有没有把企业自己的说法当主干,有没有把每一步的依据留下来,以及三年之后换一批人接手的时候,这套知识还在不在。

【声明】内容源于网络
0
0
AI驱动数字化转型
专注AI,促进智造行业数据衍生,服务智能制造企业的数字化、智能化,聚焦大模型私域部署、大模型微调、数据清洗、AI模型训练、私域知识库及agent技术延展等。行业智能,落地为先。
内容 1092
粉丝 1
AI驱动数字化转型 专注AI,促进智造行业数据衍生,服务智能制造企业的数字化、智能化,聚焦大模型私域部署、大模型微调、数据清洗、AI模型训练、私域知识库及agent技术延展等。行业智能,落地为先。
总阅读11.8k
粉丝1
内容1.1k