AI问数总翻车?八成的问题不在模型,是数据没“长嘴”
把数仓当成一座城市,AI 是那个最聪明的快递员——可他手里没有地图,也没有门牌。
览众数据图谱 × 语义层 · 零售行业篇 ·
先看三个翻车现场,都是这半年零售圈的真事。
现场一。某零售集团大促复盘会上,商品总监随口问“上季度毛利率是多少”,AI 秒答 28.6%。财务递上来的报表却是 23.4%,差了 5.2 个点,全场安静。追下去才发现:AI 用的是“含税销售额减采购成本”,退货、折扣、运费一分没扣;财务用的是“净收入口径”,退掉的、折掉的、送出去的,先减掉再算。两边嘴上说的都是“毛利率”,可谁也没规定过:它到底按哪套算法算。
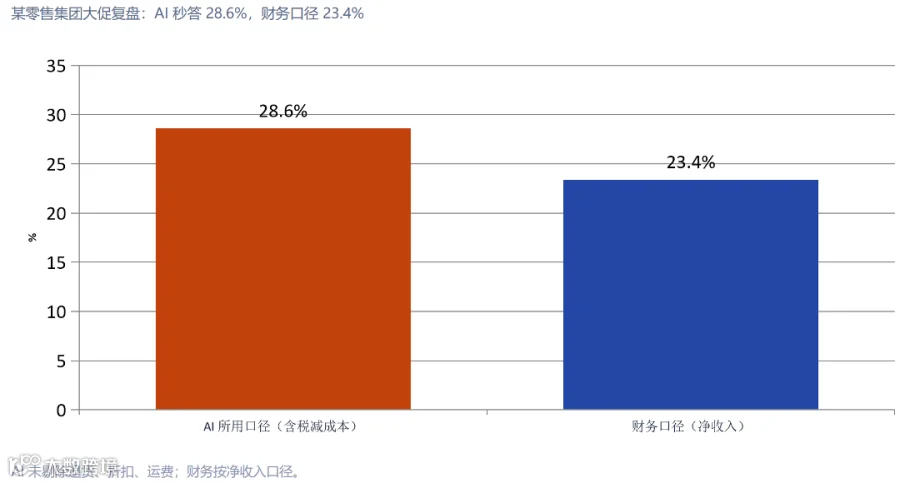
【图 1】同一个词“毛利率”,两个口径差出 5.2 个点
现场二。一家连锁服饰品牌的运营问“春季款售罄率到多少了”,AI 答“未找到相关数据”。可库存表 SKU_BI_2024S 里躺着三百多万行,sld_qty、rcv_qty 两个字段清清楚楚。问题出在哪?这张表的注释只写着“周度业务数据”;sld_qty 是销量还是售出件数?rcv_qty 是入库量还是可售量?“售罄率”等于销量除以入库量——这个公式,整个系统里没有一处登记过。AI 不是没数据,是没人告诉它:这堆字段就是答案。
现场三。一家区域连锁超市认定问数不准是模型不行,从开源 32B 一路换到闭源旗舰,两个月换了三代。答对率从 52% 涨到 57%,只多了 5 个点,推理成本却翻了八倍。数据团队忍不下去,进场补了十天:指标字典、口径对照、字段业务注释。答对率干到 84%。
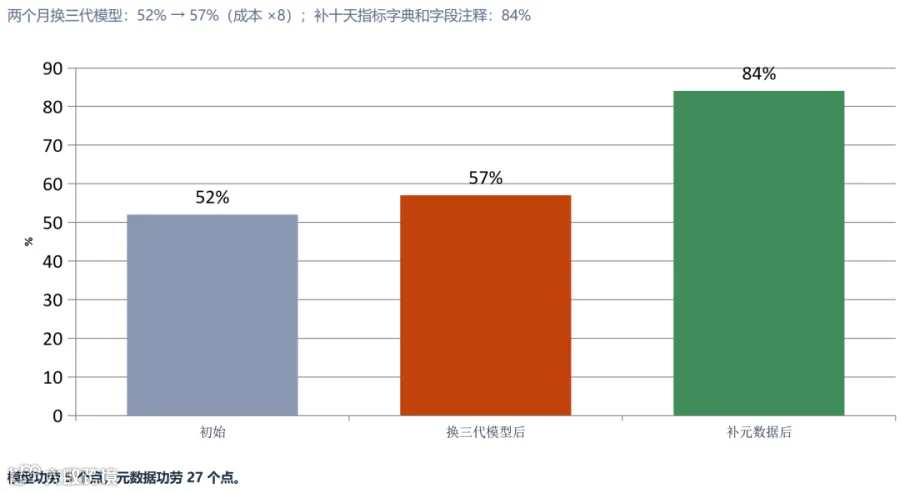
【图 2】换两代模型 vs 补十天元数据
这 5 个点是模型的功劳,那 27 个点是数据的功劳。
一、一次问数三道题,模型只做得了第一道
把一次 AI 问数拆开看,其实是三道题:听懂问题、找到答案、按规矩回答。模型负责的只有第一道——把“毛利率多少”翻成查询意图。后两道它天生不会:数据躺在哪张表?字段是什么意思?按哪个口径算?这些答案不在模型里,在数据里。
所以模型再强,也有三个“天生不知道”:不知道数据在哪——“售罄率”对应哪张表,它无从推断;不知道字段什么意思——sld_qty 是销量还是售出件数,它只能猜;不知道口径怎么算——“毛利率”扣不扣退货折扣,它没有任何依据。
没人把这些喂给它,AI 问数就像让一个天才翻译去读一本没有目录、没有注释、页码还乱的书——翻得再快,读出来的也是错的。
(一)翻车不在模型,在数据的三处“失语”
对应模型的三个“不知道”,翻车现场也正好三种。第一类:数据失联——表和业务词之间没有桥。业务说“售罄率”,库里的表叫 SKU_BI_2024S;业务说“黑金卡”,字段叫 cst_lvl,值是 0/1/2/3。没有映射,AI 只能瞎猜或放弃。
第二类:字段失义——注释要么空着,要么写着“周度业务数据”这种话。字段是什么业务含义、怎么加工出来的,一个字没有。模型只能按字面猜,猜错就是那种“数字是对的、口径是错的”的静默错误。
第三类:口径失约——同一个词,各算各的。“毛利率”按含税算、按不含税算、扣不扣退货,三个系统三种数。一个指标三套口径,十个人问出十个答案。
(二)那为什么大家还是习惯先怪模型?
因为怪模型成本最低、动作最顺:换模型,是提需求、走采购、等上线,锅在外部,功劳看得见;补数据,是自己下场:跟业务对口径、翻老系统找字段、找开发补注释——活又脏又碎,还很难向老板汇报“我修好了什么”。
更隐蔽的是心理账:“模型不行”是供应商的锅,“数据不行”是自己的锅。承认后者,等于承认过去几年该做没做。所以每次问数翻车,大家宁可相信是模型不够聪明。
但翻车不会因为换了模型就消失,它只是被推迟到下一次问数。模型是引擎,数据是油路——油路堵着,换再新的引擎,也只是把堵车从这条路挪到那条路。
二、数据图谱+语义层:让数仓学会“说话”(本章重点)
你说:我们做元数据管理好几年了,怎么问数还是不准?
因为大多数企业做的元数据,是给人看的档案:字段名、类型、长度、责任人、生命周期。这些信息对模型几乎没用。模型不需要知道字段是 varchar(64),它需要知道:这个字段在业务上是什么意思、跟别的字段是什么关系、哪个口径说了算。
要让数仓“学会说话”,靠两样东西:数据图谱把看不见的关系画出来,语义层把说不清的口径立成字据。
(一)找得到——数据目录,给表和业务词牵上线
览众数据图谱是 AI 驱动的元数据扫描器,从数据库、ETL、BI,到 Python、Spark/ML,跨遗留系统到现代云,自动把全企业的数据资产扫进一张基于事实的数据目录——POS、会员、商品、促销、财务,一张图。再靠 AI 上下文感知,把“复购率”“黑金卡”这样的业务术语自动关联到对应的表、字段、代码——业务词和数据资产之间,终于有了桥。
(二)看得懂——字段级血缘,把来龙去脉画成图
数据不是孤岛,是流水线。览众数据图谱自动解析 SQL、存储过程、各类 ETL 脚本的加工逻辑,画出从源系统到 ODS、DWD、ADS、再到报表的全链路字段级血缘。哪张报表的数从哪张表来、中间经过几道加工、口径在哪一步被定义——一张图说清楚。AI 问数时沿着血缘走,等于拿着导航送快递,而不是挨家敲门猜。
(三)对得上——语义层,给每个指标立“户口页”
这是最容易被忽略、也最要命的一环。高频指标,每个都该有一张“户口页”:计算公式、统计维度、时间口径、权威来源,白纸黑字登记,版本化管理——口径改了,旧版本还在,谁都能查。比如“复购率”:计算公式、统计维度(会员/门店/品类/城市)、时间口径(自然月)、权威来源(会员中台)、版本(v1 到 v2,复购窗口 30 天调整到 90 天)。

【表 1】语义层“户口页”示例
更重要的是:语义层不是给人看的文档,是给模型走的规矩。口径登记、认证之后,编译成唯一的查询路径——同一个指标、同一个版本,不管谁来问,都只有一种算法、一个口径。口径没登记,AI 就只能靠猜、靠蒙、靠运气。
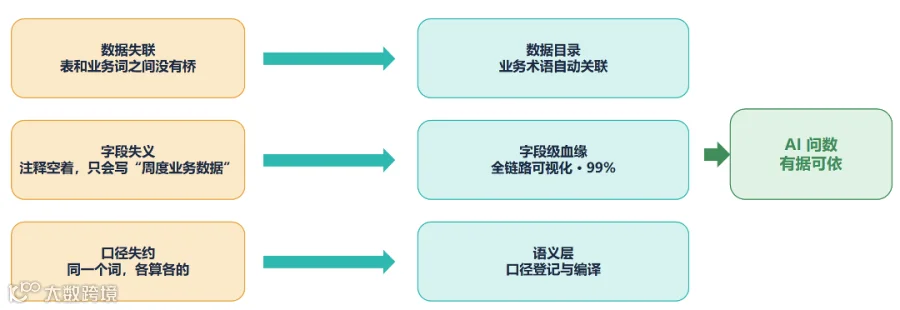
【图 3】三处“失语” → 三样解法:AI 问数从“靠猜”到“有据可依”
三、落地三步,别贪大
听着像大工程,其实起步就三步,核心原则一个:不追求一次画完全图,先把问得最多的那几条路铺平。
第一步:让图谱先“长出来”。先接上核心数据源——POS、会员、商品、促销、财务——自动扫描,把全链路血缘盘出来。不是憋三个月做完美模型,而是先有一张会呼吸的地图——数据一变,它自己更新。有家银行做监管报送链路梳理,过去 12 个资深技术盘半年、花 500 万做一次静态盘点;用图谱 24 小时自动盘清全域口径,之后从按月跟踪直接变成按天跟踪。
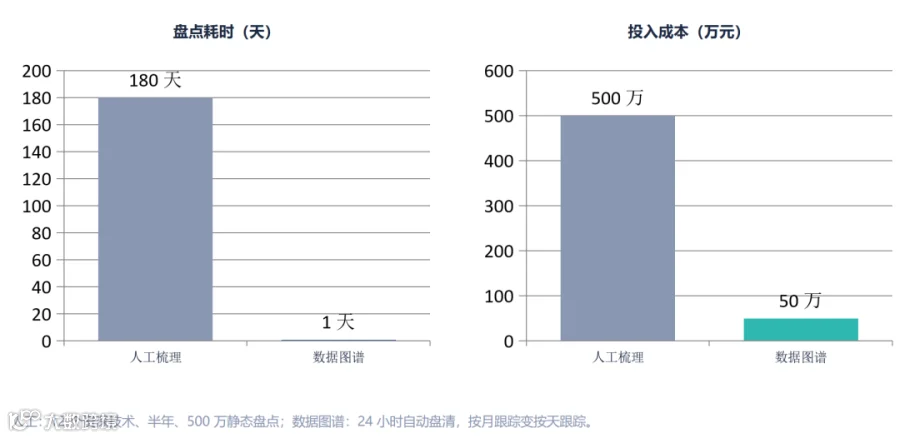
【图 4】同一份链路梳理:人工 vs 数据图谱
第二步:给 Top 30 指标立“户口页”。跟财务、运营把口径一个个对齐——GMV、毛利率、复购率、客单价、库存周转——登记进语义层。有分歧不怕,怕的是分歧不上桌——口径的账,最好在会议室里算清,而不是最后算在老板的报表上。
第三步:让 AI 问数走“语义路径”。图谱负责指路,语义层负责立规矩,AI 只能在被治理过的路径上查数。数据团队终于不用再做“人肉口径机”——同样的口径问题一天被问上几十遍的日子,结束了。
四、写在最后:别让模型跑在“失语”的数据上
现在行业里有个奇观:模型的参数卷到万亿,发布节奏以月计;数仓里的表注释却还空着,血缘还断着,口径还各说各话。
模型的上限,从来不是参数量,而是它看得懂多少数据。
八成问数翻车,换的不是模型,是缺一张图、缺一套规矩。
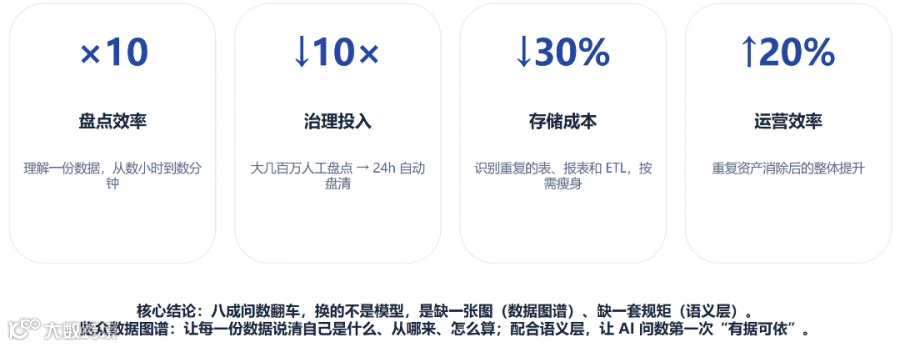
【表 2】览众数据图谱客户收益
下次问数翻车,先别急着骂模型——去数仓里看看:那张表的注释是不是还空着,那条血缘是不是还没画出来,那个指标的口径,是不是还没立字据。
览众数据图谱:让每一份数据说清自己是什么、从哪来、怎么算;配合语义层,让 AI 问数第一次“有据可依”。