

大家好,我是萝卜哥~
今天可是真热闹啊,Anthropic 先发了 Claude Opus 5.5,大概一个半小时之后,OpenAI 就甩出了 GPT-6 Sol 和 Luna。两家前后脚,连降价都撞在一起了。
Opus 5.5 是 Anthropic 这次的主力,官方说法是大部分工作能达到自家顶配 Fable 5.1 的水平,但是价格却比 Opus 5 便宜了 40% 左右。
Sol 是 OpenAI 的中档大模型,定位是给写代码、干技术活用的,上面还有着一个更贵的 GPT-6 Astra。
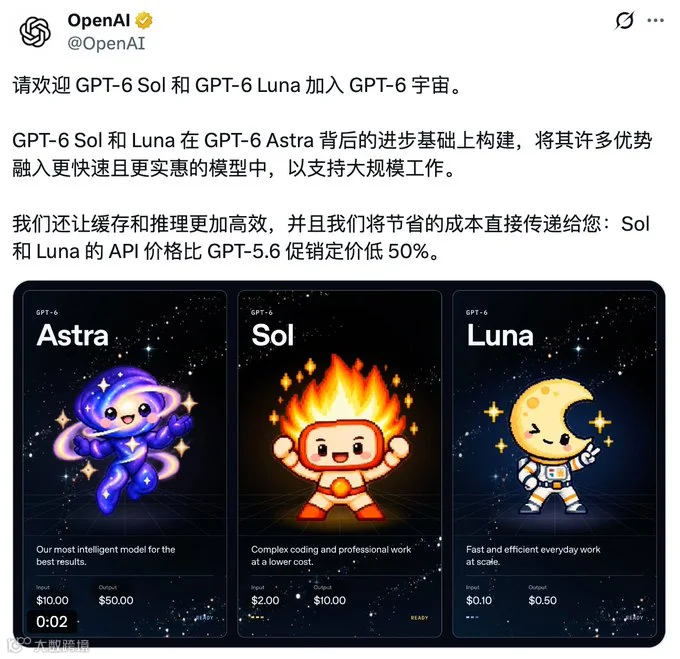
Luna 是便宜货,专门接那种量大、目标明确的活,比如总结文档、抽信息、快问快答,免费用户在桌面端就能用。
光看这张表,Sol 刚好是 Opus 5.5 的半价,但是现在的大模型,光是便宜可不行,咱们还要看效果。
下面根据萝卜哥的几个测试案例,来看看两个大模型到底怎么样吧~
先来个热身题,但这题其实挺考细节。
我给的提示词是这样的。
Opus 5.5 交出来的效果是这样的,真的好棒啊。
几个细节我都挺满意的,切换文字的时候每个粒子随机领一个新坐标,所以炸开再聚合的路线都不一样,看着很自然。
拖尾用的是半透明背景覆盖,没有额外算轨迹,性能很省,用浏览器打开没有一点卡顿的感觉。
再来看 GPT-6 SOL 的效果,同样很棒,我个人觉得这个案例,甚至 SOL 更打动我。
不知道大家觉得哪个更好呢?
这一题我觉得两边的差距,更多是风格上的偏好。提示词写得这么细,两个模型基本都是照着单子一条条交作业,能拉开的空间本来就不大。
所以谁更打动你,很大程度上看你喜欢哪种手感。粒子推开以后是软软地弹回去,还是干脆利落地归位,颜色是偏冷还是偏艳,这些提示词里都没写死,全靠模型自己拿主意。
这题开始上难度了,考的是审美。
Opus 5.5 的版本。
Opus 5.5 还是很稳定的,提示词里面要求的都满足得很不错。
频谱那圈柱子从粉色一路过渡到青色,每隔一会儿会有一次重拍,所有柱子一起往外顶一下,挺有节奏感的。
最让我惊喜的是它对于暂停的处理,按下去以后频谱柱子一根根落回去,背景的色块也慢慢暗下来,整个页面像是跟着安静了。
来看看 GPT-6 SOL 的效果。
说实话这个就差很多,可以说是被全面碾压了,看来对于纯前端的任务,GPT 还是不太行啊。
我觉得提示词里面那几个形容词,比如“呼吸感”“细细的高光”“慢慢落下去”,这些词没法直接翻译成代码,模型得自己去想。
•呼吸感到底是多快的节奏?
•高光到底要多细?
•落下去要花几秒?
GPT-6 SOL 理解得不到位。
做过设计的朋友都知道,从能用到好看,中间那段路最难走。所以以后你要做落地页、产品展示页这种门面活,审美这一关我建议优先交给 Opus 5.5。
纯前端视觉任务不仅考功能实现,也考模型对“呼吸感”“高级感”“细腻”等抽象描述的理解能力。
这是一个比较能拉开差距的地方,页面好看可以靠堆特效,游戏能不能玩一上手就知道。
Opus 5.5 的版本。
每次跳跃的时候,萝卜脚下那些淡紫色的小点是起跳时扬起的灰,右上角那颗金色的小圆点就是金币。
手感方面,第一跳高、第二跳矮一点,节奏挺舒服。兔子是一蹦一蹦过来的,每只蹦的节奏还不一样,判断起跳时机需要一点反应。
被兔子逮住的那一下,屏幕会抖,萝卜炸成一片粉绿色的碎片,看着有点惨,又有点好笑。
SOL 的效果。
其实也不错,跳跃的感觉没有 Opus 5.5 好,但是整体游戏元素要更好一些,萝卜人的四肢也比较明显。
对于这个案例,我觉得两个大模型能打个平手吧~
如果你是想做个小游戏自己玩,或者拿给小朋友玩,我会选手感好的那个,因为玩几把以后你根本不会盯着萝卜的胳膊看。
要是拿来做演示、录视频,那 SOL 这版反而更上镜。
其实上面的提示词,我觉得还是约束太多了,对于 Opus 和 SOL 这样的顶级大模型,反而束缚了它们的手脚,所以下面两个案例,我的提示词是越来越简单,但是效果还是很惊艳。
现在我们在测试一个大模型水平的时候,总是喜欢让它画鹈鹕骑自行车。我这次没有这么做,直接让它们复刻经典游戏,来看看它们的理解能力怎么样。
Opus 5.5 的效果如下,它的首页是动图,立刻就感觉高大上了不少啊。
GPT-6 SOL 相对来说就差了不少,各种细节都比不过,人物的出圈、赛场上的干扰因素,比如逆向的车辆等等,全方位被碾压了。
这一题最能看出两个模型的差别,因为提示词只有一句话,剩下的全靠它们自己脑补。
“把你所能用到的能力都用上”,这句话其实是在考主动性。
Opus 5.5 的理解是,一个完整的游戏该有的东西都得有,所以它先做了动态首页,赛道上还主动加了逆行的车辆当干扰。这些我一个字都没提,它自己补上了。
从成品来看,SOL 更像是把题目的字面意思做完就收工,能跑能玩,但也就到这儿了。
我的判断是,需求越模糊,越需要模型自己拿主意,Opus 5.5 的优势就越明显。需求写得清清楚楚、按单子干活的时候,两边的差距会小很多,前面三个案例已经说明了这一点。
在网上还看到有网友一句话生成科普视频,真的是太强了。我稍微做了一下优化,使用的是下面的提示词。
Opus 5.5 的作品,它生成了 HTML 页面,有背景音乐,但是没有旁白。
可是这个效果是真的牛啊,画面精美,各个人物也很精良,对于历史事件的描述也很准确,囊括了史实和演义的内容,我觉得足可以称得上精品了,就算直接发到短视频平台也没问题。
SOL 的产物,它生成的不是 HTML,是直接给出了 MP4 文件,而且带有旁白,这一点还不错。
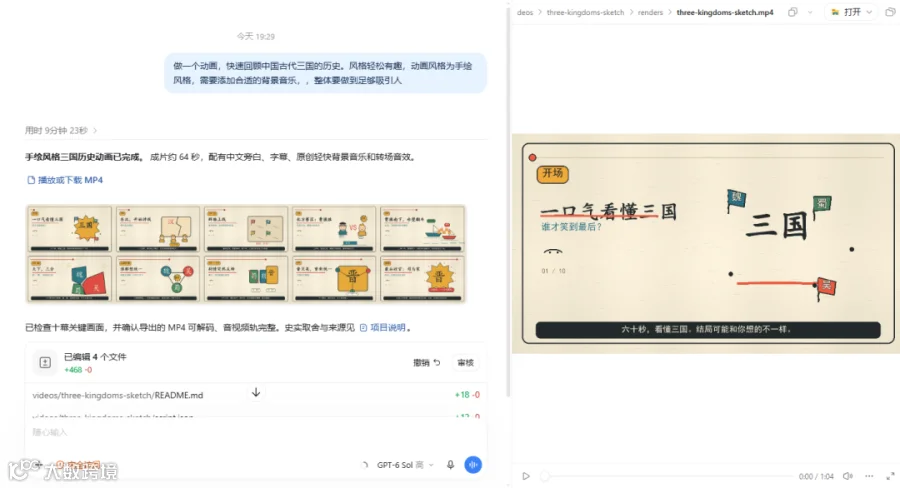
可是其他的就没法比了,虽然说整体事件没有问题,但是画面还是太粗糙了,完全没有 Opus 那种寓教于乐的感觉,整体画面就是一些图片的简单拼接,动效太简单。
这五个案例测试下来,我本来以为自己的 GPT 和 Claude 额度会见底,结果没想到异常的坚挺。
我的 GPT Plus 账号五小时额度还有 66%,Claude Pro 账号五小时额度还有 76%,你敢信?
而且这些任务我跑下来,前前后后总共也就花了不到 3 个小时,这真的是又快又好又耐用啊。
这个额度表现,我觉得比任何跑分都更实在。
总体来说,我觉得简单的任务交给 SOL 还是完全没有问题的,它的额度现在也是比较抗用的。
但是如果是比较复杂的编码工作,那有条件一定要上 Opus 5.5,确实是强啊,关键还不贵。
简单、明确、按要求执行的任务,选择 GPT-6 SOL,性价比更高。
复杂、开放、需要审美和主动决策的任务,优先选择 Claude Opus 5.5。
五个案例排下来,其实能看到一条很清楚的脉络:
•提示词写得细的时候,粒子和跑酷两题基本打平。
•考审美的播放器拉开了差距,因为审美那部分提示词写不死。
•提示词越短、需求越模糊,差距就拉得越开。
•暴力摩托和三国动画这两题,Opus 5.5 几乎是一边倒的优势。
这条脉络对我们自己用模型也有参考价值。
你要是习惯把需求写得清清楚楚,一条一条列出来,那 SOL 性价比更高,API 价格只有 Opus 5.5 的一半。
你要是经常一句话丢过去,希望模型自己把事情想周全,那多花的钱花在 Opus 身上就更合适。
提示词我都完整放在文章里了,最简单的那两句一共也没几个字,复制过去就能跑。
挑一个你最想要的,丢给两个模型试试,跑出来的效果欢迎在评论区晒一晒。
以上就是今天的分享,觉得有帮助,帮请帮一键三连:点赞、转发,再看和留言,你的反馈对我很重要!