

彩蛋:结尾扫描二维码,领取《AI编程工作流实战指导手册》。

前天,小米刚刚把 MiMo V2.6 系列端了出来。
Pro、Flash、UltraSpeed 三个版本一起上,其中 MiMo V2.6 Pro 在 Artificial Analysis 综合智能指数拿到 46 分,小米将它称为当前最强的开放权重模型。更关键的是,能力涨了一大截,API 价格却继续沿用 V2.5。
结果隔了一天,GPT-6 Sol 和 GPT-6 Luna 又来了。
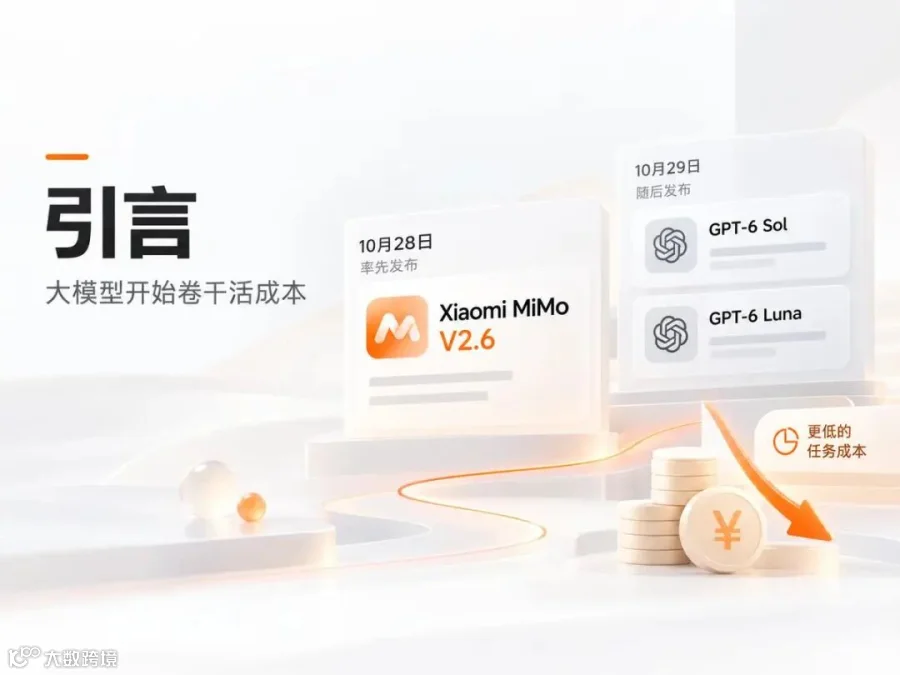
OpenAI 这次同样把“便宜”摆到了台面上:Sol 每百万 Token 输入 2 美元、输出 10 美元,Luna 输入 0.1 美元、输出 0.5 美元,相比 GPT-5.6 对应型号的促销价格直接下降 50%。而且官方开始反复强调一个指标:Cost per task——完成一次任务到底要花多少钱。
把这两次发布连起来看,我觉得真正有意思的事情出现了。
以前大模型天天争“谁最聪明”,现在大家开始认真算另一笔账:
让这个模型替我狠狠干一天,到底要多少钱?
而今天这篇,我们就回来仔细看看先出场的 MiMo V2.6。
大模型进入 Agent 和 AI 编程以后,成本这件事的重要性会被迅速放大。
以前跟 AI 聊几句话,一次也就消耗几千 Token。现在让 Coding Agent 读取整个代码库、修改文件、调用工具、跑测试、修 CI,一个任务跑几十轮甚至上百轮非常正常。
所以模型强不强,只解决第一道问题。
真正进入工作以后,还得看另外两件事:跑得够不够快,以及你敢不敢一直用。
OpenAI 昨天把 Sol 和 Luna 的价格砍下来,小米前一天则选择“能力大涨、价格不涨”。两家公司走的路线不同,最后瞄准的是同一个问题:
怎么把足够强的智能,变成真正可以高频调用的生产资料。
这才是 MiMo V2.6 这次最值得关注的地方。

01|这次已经不只是“便宜模型”了
先说能力。
MiMo V2.6 Pro 是 MoE(混合专家)架构,总参数 1.02T、激活参数约 42B;Pro 和 Flash 都支持 1M Token 上下文,可以直接理解文字、图片、视频和音频,明显是冲着 Coding、Agent 和长程任务去的。
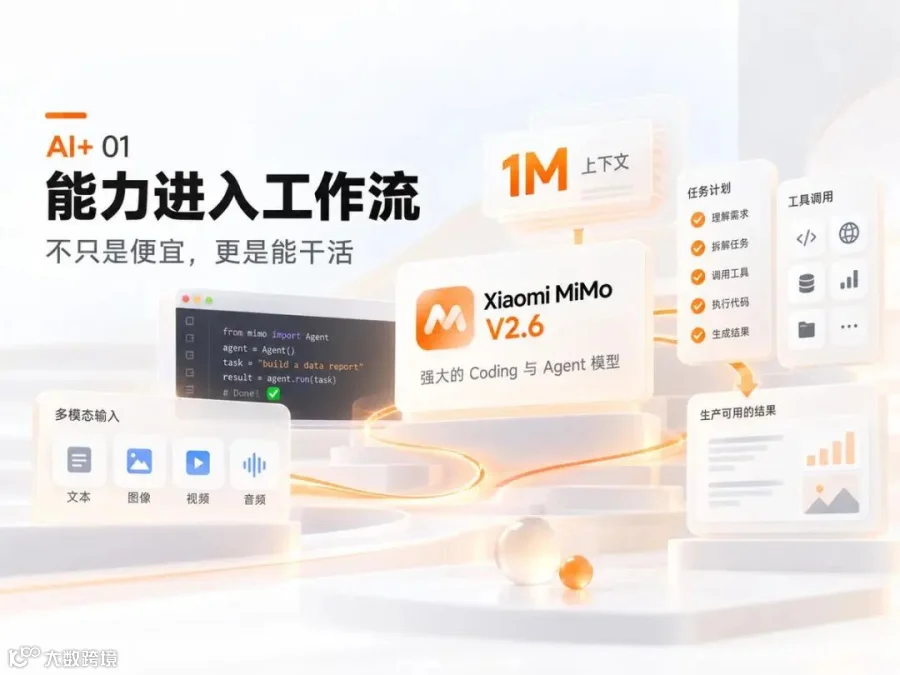
在 Artificial Analysis 综合智能指数上,Pro 达到 46 分。官方披露的 DeepSWE、Terminal Bench 等 Agent 和软件工程测试也进入了当前开放模型的第一梯队。
所以这次 MiMo 给我的感觉很明确:
它已经开始从“价格便宜,可以试试”,进入到“能力够强,可以考虑真的拿来干活”。
这两句话,差别很大。
02|真正狠的,还是价格
然后看最刺激的部分。
MiMo V2.6 Pro 国内 API 每百万 Token,缓存未命中输入 3 元、输出 6 元;Flash 更低,输入 1 元、输出 2 元。
如果大量上下文可以命中缓存,Pro 输入直接降到 0.025 元/百万 Token,Flash 更是只有 0.02 元。
而昨天发布的 GPT-6 Sol 是 2 美元输入、10 美元输出;GPT-6 Luna 是 0.1 美元输入、0.5 美元输出。
所以以后选模型,真的不能再只看“谁跑分最高”。
大型架构设计、高风险重构,可以继续交给最强模型;普通功能开发、Bug 修复、批量处理、测试补充,就完全可以交给成本更低的模型去跑。
让贵模型负责想,让便宜模型负责狠狠干。
这种模型分工,可能会成为接下来 AI 编程非常实用的一种工作方式。
03|小米这次开源的东西,也挺狠
还有一个容易被价格盖过去的点:MiMo V2.6 这次开源得相当彻底。
除了 Pro、Flash 模型权重和技术报告,小米还开放了 7000+ 高质量 RL 任务环境、端到端强化学习框架、轻量 Harness,以及一个 MiMo-V2.6-Distill-Qwen-9B。

更有意思的是,这轮强化学习此前还公开直播了训练过程。
小米披露,Flash 和 Pro 不到 6 天各完成 30 个训练 Step,累计约 75 万条轨迹,训练成本分别约 85 万美元和 262 万美元。原稿也记录了这组数据。
对于普通用户,模型权重当然重要。
但对于真正做 Agent 的团队,那 7000 多个 RL 环境、训练框架和 Harness,可能更值钱。
因为以后真正难的,已经不只是“有一个聪明模型”。
还要让它在真实任务里学会稳定干活。
夸完了,该泼的冷水还是得泼。

第一,开放模型第一,不等于全球最强。 小米自己也明确写了,MiMo V2.6 Pro 和 GPT-6 Astra、Claude Fable 5.1 这样的顶级闭源模型仍有差距。
第二,价格低,也别直接把核心项目全换过去。 普通开发、Bug 修复完全值得试,但大型重构和高风险生产代码,最好先拿自己的真实项目做一轮对比。
第三,UltraSpeed 很快,但也贵。 它最高能做到 Pro 的 20 倍输出速度,相应的价格也提升到国内输入 30 元、输出 60 元/百万 Token,所以它解决的是实时性,不是省钱。
1. MiMo V2.6 最大的变化,是把开放模型能力继续往旗舰区间推,同时把 API 价格留在一个可以高频调用的位置。
2. 它还没有全面超过最强闭源模型,但 Pro、Flash、UltraSpeed 三档,加上 1M 上下文和低缓存成本,已经很适合真正的 Agent 和 AI 编程工作流。
3. MiMo V2.6 先发,隔天 GPT-6 Sol/Luna 再降价 50%,已经说明一个趋势:下一轮模型竞争,不只比谁最聪明,还要比完成同一件工作到底花多少钱。

这次我专门整理了一份 《AI编程工作流实战指导手册》。
里面不讲空泛的模型介绍,而是直接按照真实编程任务来选模型:Bug 修复、单功能开发、大型重构、代码审查分别该怎么用;同时把 MiMo V2.6 Pro / Flash 和 GPT-6 Sol / Luna 的 API 价格、缓存成本以及不同任务的选择方式放在一起对比。
目标很简单:拿到以后,你就能直接照着自己的项目配置,知道什么时候该用强模型,什么时候换便宜模型省钱。

扫码回复关键词【编程】即可领取。