

这次更新,先看三个关键词:
价格约减半 · 能力升级 · 缓存降价
API 价格降至前代对应型号约一半,编程、专业工作和电脑操作等能力也有升级。
01|三个型号,怎么区分?
结合官方定位,可以这样理解。右侧是可尝试的任务,不代表本文已经实测。
| 模型 | 主要定位 | 可尝试的任务 |
|---|---|---|
| Astra | 家族内最高能力 | 难度高、需要深入分析的任务 |
| Sol | 复杂编程、多步骤工作 | 修改项目、处理报错、连续调用工具 |
| Luna | 明确、重复、大批量的任务 | 文档分类、信息抽取、批量摘要 |
不必所有任务都从最高档开始。
可以先比较便宜型号的结果,再决定是否升级。
科研也是其中一种应用:例如测试 Luna 做文献分类,再比较 Sol、Astra 的论文分析表现。
02|便宜多少?先看价格,再看算例
先看单价
下表对比的是 GPT-5.6 对应型号的促销价格与 GPT-6 新价格。
单位:美元/百万 tokens。
| 模型 | 输入:前代 → 新版 | 输出:前代 → 新版 |
|---|---|---|
| Sol | 2** | 10** |
| Luna | 0.10** | 0.50** |
再换成一个直观的例子
单价不够直观?假设调用 1,000 次,每次输入 10,000 tokens,计费输出 1,000 tokens。
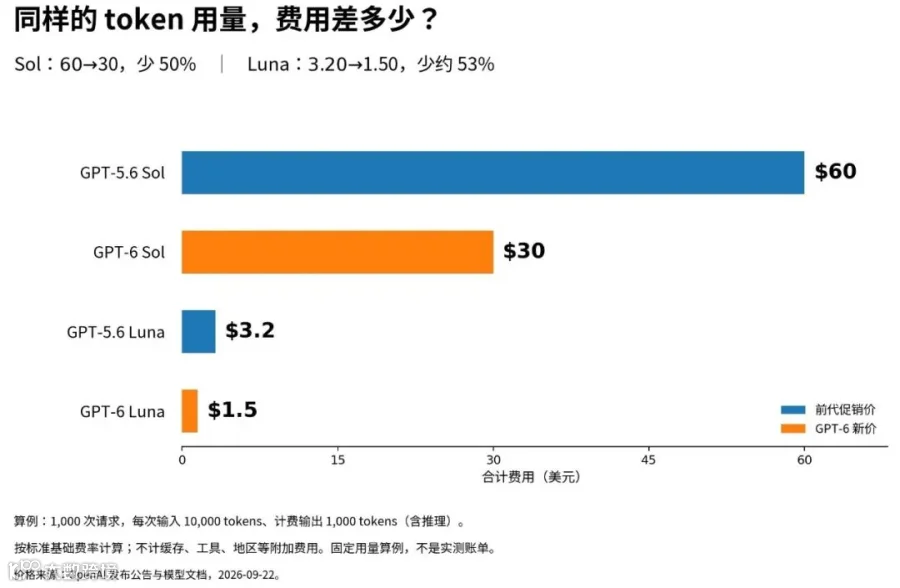
按固定 token 用量计算的费用对比,非实测账单
Sol:60 美元 → 30 美元,减少 50%。
Luna:3.20 美元 → 1.50 美元,减少约 53%。
算例未计缓存、工具及其他附加费用。真实任务的 token 用量也可能不同。
03|能力怎么样?看结果,也看成本
软件工程:分差与成本放在一起看
先看软件工程评测 DeepSWE 1.1。官方公布的结果如下。
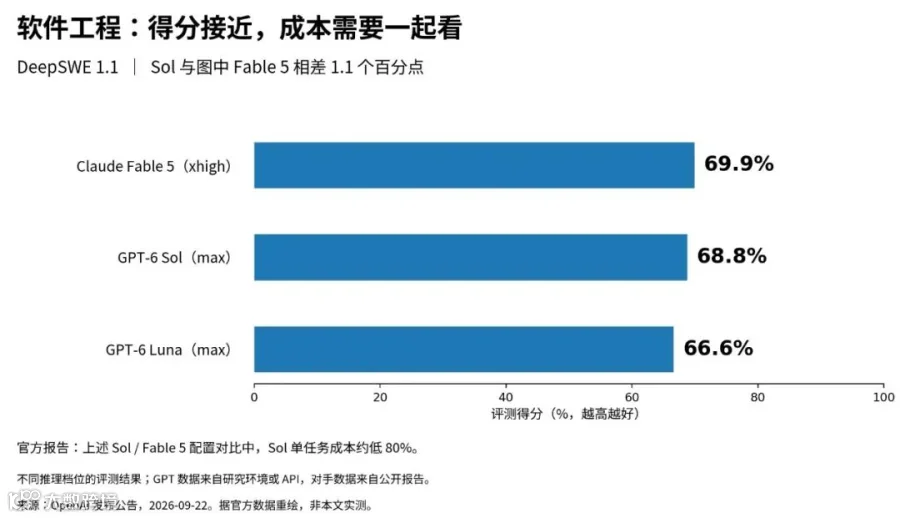
不同推理档位下的官方评测数据,非本文实测
Sol 与图中 Fable 5 相差 1.1 个百分点,单任务成本约低 80%。
这组结果的看点,不是 Sol 得分最高,而是能力与成本之间的取舍。
这是特定评测与推理档位下的对比,不能直接换算成所有工作的省钱比例。
其他能力,一张表看清
其他能力,可以集中看这张表。
| 能力方向 | 官方结果 | 怎么理解 |
|---|---|---|
| 专业工作 | Sol(max)得到 56.4% | Agents’ Last Exam,考察跨行业长流程任务 |
| 电脑操作 | Sol(xhigh)60.5%;Opus 5(medium)60.3% | OSWorld 2.0 离线集,按部分完成情况计分 |
| 事实准确性 | Sol 的错误约为前代的 一半 | 来自内部易错对话样本,不代表日常整体错误率 |
评测成绩不等于你的实际使用结果。
推理档位、工具和测试环境,都会影响表现与成本。以上均非本文实测。
04|缓存:重复的内容,可以少算一遍
假设你要处理一批文档,每次使用相同的规则和模板。
材料在变,前面的要求没有变。
满足缓存条件时,这段相同前缀可以复用已有计算,不必每次重新处理。
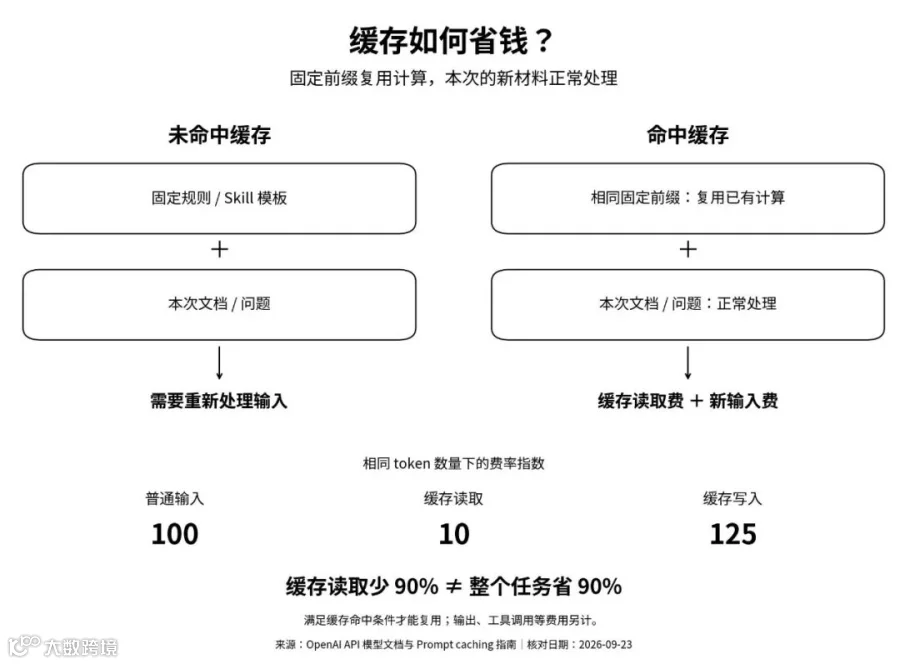
具体能省多少?
单位:美元/百万 tokens。
| 计费项目 | Sol | Luna |
|---|---|---|
| 普通输入 | $2.00 | $0.10 |
| 缓存读取 | $0.20 | $0.01 |
| 缓存写入 | $2.50 | $0.125 |
缓存读取只收普通输入的 10%,
≠ 整个任务便宜 90%。
未命中的内容、缓存写入和模型输出,仍然需要计费。
这次还增加了缓存看板、命中诊断,以及保留缓存的推理档位和工具调整方式。对反复使用同一套 Skill、处理大量材料的应用,这些控制值得关注。
05|在哪里能用?使用条件集中看
入口与参数
使用入口按发布公告整理,参数以 API 文档为依据。
| 项目 | 说明 |
|---|---|
| 付费用户 | Plus、Pro、Business、Enterprise、Edu:在 ChatGPT Work 和 Codex 使用 |
| Free、Go 用户 | 可在桌面应用中使用 Luna |
| 普通 Chat 入口 | 发布时尚未提供这两款模型 |
| API 模型名 | gpt-6-sol、gpt-6-luna |
| 输入与输出 | 文本、图片输入;文本输出 |
| 上下文窗口 | 105 万 tokens |
| 最大输出 | 12.8 万 tokens |
两个容易忽略的地方
注意一|长上下文有加价。
输入超过 27.2 万 tokens 时,整个请求的输入与缓存费率按 2 倍计算,输出按 1.5 倍计算。
注意二|额度重置,不是 API 余额。
Banked reset 是一次性 Codex 使用额度重置,不会永久提高订阅额度。是否获得、何时到期,可以在账户的“设置 → 使用情况”查看。
最后|便宜是起点,做好任务才是目的
这次更新值得尝试的,不只是“新模型”,还有新的任务分工。
选一个经常做的任务,用相同材料比较结果、耗时和返工次数。
更便宜是起点,能把事情做好,才是最终的使用价值。
B685:创新点设计与可证伪性检验Skill安装包:paper-novelty-design
B754:drawio绘图软件、skill、插件安装包和使用
B795:可编辑 PPT 生成系统安装包和使用手册
B814:ChatGPT 5.6 安装包、使用教程视频
科研小白需安装的 11 个 SKills
往期文章推荐:
GPT-6 + Zotero + Skill ,全自动完成搜索文献和分类管理