

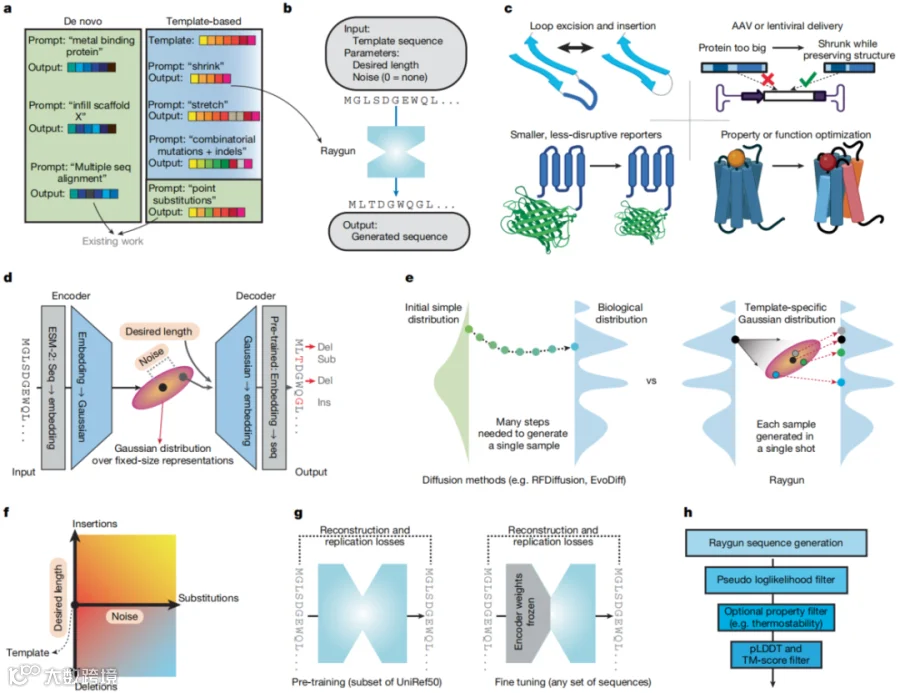
今天和大家分享的是杜克大学与加州大学圣迭戈分校团队发表于Nature的工作《Miniaturizing and modifying natural proteins with Raygun》。与从头设计生成新蛋白不同,Raygun以天然或已有功能蛋白为模板,通过同时引入替换、插入和删除,对模板进行大尺度改造,并尽可能保持其结构与功能。作者的核心思路是:不再把不同长度的蛋白质表示为不可直接比较的变长残基向量,而是将每个蛋白压缩为固定维度的概率分布,使不同长度蛋白可以在同一空间中进行比较、采样与长度变换。
基于这一表示,Raygun只需两个可调参数(噪声强度和目标长度),即可分别控制序列替换程度与整体增删幅度。模型能够将蛋白缩短约10%–25%,在部分情况下甚至超过50%,也能够放大到超过天然长度。生成过程为单步采样,在NVIDIA A100上每次生成约需0.3 s。最后作者进一步通过荧光蛋白、TurboID和EGF的实验验证了模型在真实功能蛋白改造中的可行性。
1 研究方法
作者使用含6.5亿参数的ESM-2将输入序列编码为逐残基嵌入。随后把一条蛋白质的嵌入沿序列方向划分为K=50个连续片段,每个区块覆盖的残基数随蛋白质长度变化。无论原始蛋白有多长,都被表示为50×1280的固定长度潜在表示。这一处理有两个直接意义。第一,不同长度蛋白被映射到同一维度,可以在统一空间中比较和处理;第二,得到的模板特异性高斯分布可以直接采样。
Raygun本质上是作用于ESM-2嵌入的自编码器。Reduction层对连续区块进行聚合,将变长嵌入压缩为固定长度表示;Repetition层接收目标长度,把固定表示扩展为指定长度的嵌入;T-Block则结合Transformer模块与一维卷积模块,同时处理全局上下文和局部残基关系。整个Raygun约含7.01亿个可训练参数。在解码方向,作者另外训练了从ESM-2嵌入恢复氨基酸序列的网络,验证准确率超过99%。因此,Raygun可以先在连续表征空间中完成长度调整和扰动,再可靠地返回可实际合成的序列。
Raygun采用自监督训练,目标是让模型在压缩和恢复后仍保持蛋白质信息。训练损失包含三个互补部分:其一是嵌入空间重建损失,用于约束恢复后的ESM-2表征;其二是序列空间交叉熵损失,约束经预训练ESM-2解码器还原后的氨基酸序列;其三是潜在空间的长度不变性损失,即把固定表示先解码为较短序列,再重新编码,并约束两次固定维度表示保持一致,从而提高模型跨长度生成的稳定性。论文主体结果使用约8万条UniRef50蛋白进行训练,作者同时指出扩大模型和训练数据可进一步提升性能。
推理时,噪声与目标长度彼此独立。噪声通过缩放高斯分布的协方差控制替换程度:噪声接近0时更偏向保留模板,噪声升高则序列差异逐渐增大;目标长度直接决定插入和删除的总体幅度。生成后,作者使用基于蛋白质语言模型的伪对数似然对候选进行排序,并对该指标进行长度校正,以便公平比较不同长度序列;具体任务中还可叠加结构、结构域、热稳定性或功能预测等筛选器。
2 结果

作者首先选择血红蛋白、CCR1、lacZ和mTOR四种长度跨度约17倍的蛋白进行系统测试,分别包含147、355、1024和2549个残基。每个模板在多个目标长度下生成2000个候选,并以中等噪声0.5进行采样,再保留长度校正伪对数似然最高的5%。结果表明,Raygun在大范围长度修改下仍能较好保持预测结构,而且结构质量随改动幅度增加呈渐进下降。例如,CCR1缩短17%时TM-score仍为0.68;mTOR缩短约25%时TM-score为0.69,并且能够在删除超过500个残基的情况下维持约0.7的TM-score。即使进行更激进的操作,模型仍可在一定程度上保留整体折叠。
插入和删除的位置也并非简单集中于某一段序列。作者发现,在较小的长度变化下,Raygun对删除环区仅有轻微偏好;随着压缩幅度增大,这种偏好进一步减弱。更重要的是,即使没有显式输入功能位点注释,模型也倾向于优先保留关键区域。在更大规模的功能评估中,跨四类主要SCOP结构类型的Pfam结构域测试显示,候选在家族中位长度50%–200%的范围内,平均有50.65%保留其注释的Pfam结构域;与随机基线相比,Raygun的Pfam结构域保留率高约15%。


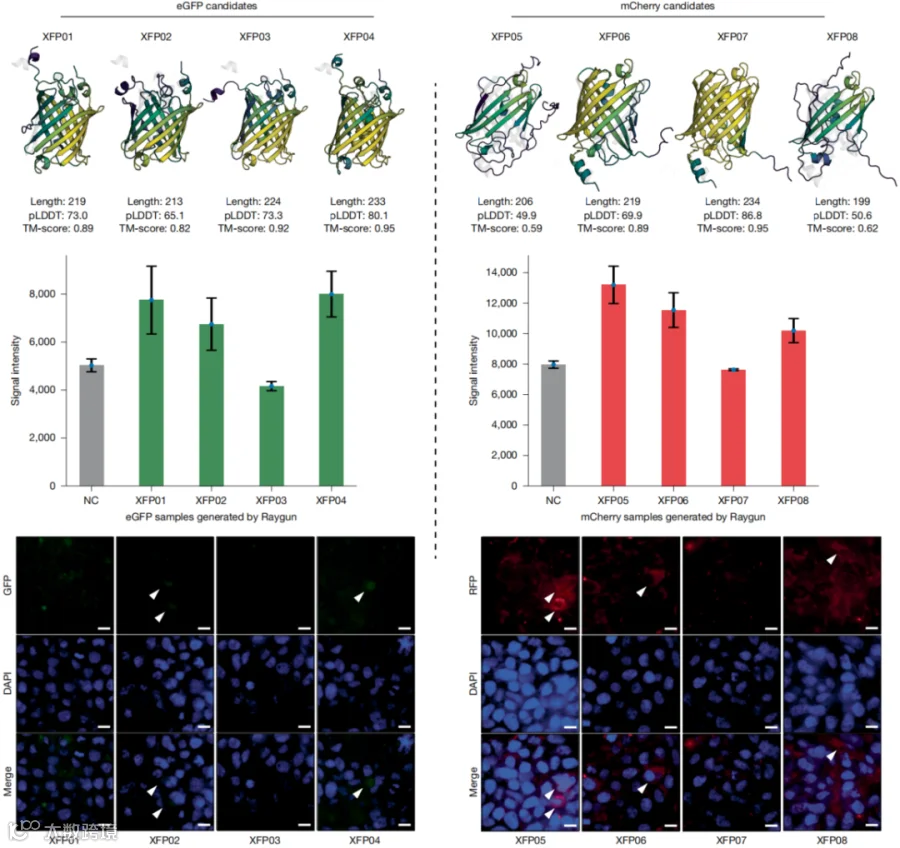
为了验证模型是否能够在真实实验中完成小型化,作者以eGFP和mCherry为模板,分别生成了70000条长度为195–235个残基的候选,筛选后最终获得8个实验候选。
值得注意的是,生成过程中没有显式固定GFP常见的XYG发色团基序,也没有像近期部分从头设计方法那样预先约束发色团残基或局部骨架。细胞实验中,8个候选里有6个表现出明显高于阴性对照的荧光信号。Raygun最多将eGFP缩短25个残基,将mCherry缩短37个残基,其中最短候选分别为199和206个残基。其中一个199残基候选在发色团区域发生了甘氨酸删除和丝氨酸替换,仍能产生荧光。这说明Raygun并非只是在模板附近进行保守修改,而是能够在维持整体功能语法的前提下探索非经典序列组合。

TurboID是常用的邻近标记生物素连接酶,长度约335个残基。作者共生成500,000个候选,分别针对195–235个残基的中等小型化和150–180个残基的极端小型化,并利用各指标进行筛选,最终选择11个候选进行实验验证。
Raygun在没有结构域注释的情况下,自主删除了TurboID的DNA结合结构域,得到165个残基的TurboID-11,恰好与人工构建UltraID时被删除的结构域相同。11个候选中有6个可在HEK细胞中成功表达;进一步的生物素化实验表明,TurboID-1和TurboID-5具有显著连接酶活性,长度分别为317和304个残基。极端缩短约50%的TurboID-11虽能稳定表达,但生物素连接活性未达显著水平。
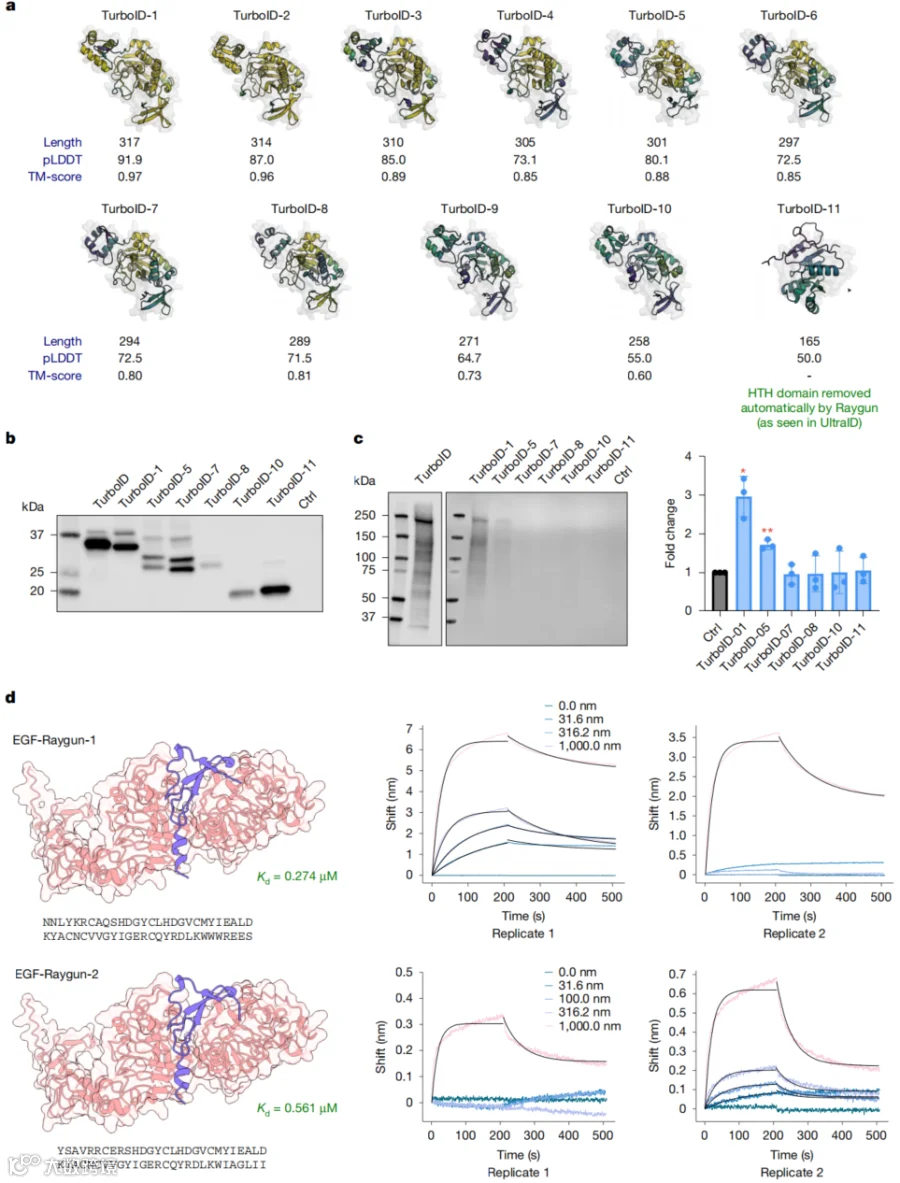

Raygun不仅可以缩短蛋白,也可以对模板进行放大。作者以53个残基的EGF为模板,将目标长度设为55–57个残基,并仅用5条EGF类似序列对模型进行微调,共生成10,000个候选,从中筛选出10个,最终有4个候选进入生物学评价并全部成功表达。其中EGF-Raygun-1的解离常数Kd=0.274 µM,EGF-Raygun-2的Kd=0.561 µM,均优于野生型EGF的Kd=0.759 µM,两条高亲和力候选与野生型的序列同一性分别只有70.7%和76.8%,而关键变化主要位于预计远离直接结合界面的外围位置。
3 讨论与总结
作者提出的Raygun通过把逐残基、随序列长度改变的ESM-2表征压缩为固定维度的模板特异性高斯分布,模型使不同长度蛋白变得可直接比较,也使插入、删除和替换能够在同一概率空间中被统一控制。论文中的荧光蛋白、TurboID和EGF实验说明,这种模板引导策略能够跨越较大的序列变化范围,甚至在不显式固定功能位点时保留或增强功能。
同时,论文也清楚展示了Raygun的局限性。固定维度表示对超长、多结构域蛋白的零样本重建仍存在压力,压缩程度较大时,高强度功能可能无法完全恢复。未来方向包括扩大模型和数据规模、引入更强或含结构信息的蛋白质语言模型、显式处理多结构域组织,以及将Raygun候选与实验筛选和定向进化闭环结合。
原文链接
https://doi.org/10.1038/s41586-026-10842-8
往期文章
药梦想013 | 噬菌体展示原理与多肽筛选实验流程
先选哪条二硫键:构象模拟引导七种富二硫键肽折叠
罗氏|新思路重写抗体筛选:2万条序列只测31个,命中11个