

在CTR预估任务中,用户行为序列与非序列上下文特征之间的有效交互,是决定模型效果的关键。近年来,大量方法围绕这一问题展开,但现有方案普遍面临一个核心矛盾:聚合式方法先将用户行为序列压缩为定长表示,再与上下文特征交互。该类方法计算高效,但会丢失大量细粒度行为信息,难以刻画“历史上哪一个具体行为”与当前候选物品真正相关。全展开式方法虽然允许序列中每个行为与上下文特征直接交互,能够保留更细粒度的关联模式,但其计算复杂度高,并且容易引入大量无关行为噪声,淹没真正有效的序列-非序列交叉信号。
针对这个两难,本文提出 CDNet(Core-Behaviors and Distributional-Compensation Dual-View Interaction Network),从两个互补的角度进行序列-非序列特征交互:
在公开数据集与工业数据集上的大量实验表明,二者结合在精度和效率上同时超越 SOTA;在Lazada推荐广告的线上 A/B 实验中,CDNet 带来显著的CTR提升。
论文标题:《CDNet: Efficient Sequential-Contextual Feature Interaction via Core-Behavior Selection and Interest-Distribution Compensation》
作者:Yi Xu, Chaofan Fan, Moyu Zhang, Jinxin Hu*, Jiahao Wang, Hao Zhang, Shizhun Wang, Yu Zhang, Xiaoyi Zeng
链接:https://arxiv.org/abs/2603.12578
1. 背景
在CTR预估任务中,用户行为序列与非序列上下文特征之间的有效交互,是决定模型效果的关键。现有方法可以分为两类:
聚合式:主流做法是先把行为序列聚合成一个或几个定长向量,再通过 FM、DNN 或注意力机制与压缩后的表示做交叉。计算上便利,但预聚合造成了关键的信息瓶颈:模型无法捕捉"某个具体历史行为"与"当前候选商品"之间的细粒度交互了。
全展开式:让序列中每个行为与每个上下文特征直接交互。最大程度上保留了行为细节,但计算复杂度随序列长度平方增长。更关键的是:当每个行为都同等地与上下文特征交互时,少数高度相关行为带来的强信号,极易被数量上远占优势的无关行为交互所淹没,反而导致预估准确度降低。
现有方法在交互阶段把所有行为同等对待,没有区分它们与当前候选商品的相关性差异。因此,高效的序列非序列交叉需要解决两个核心问题:
2. CDNet 框架
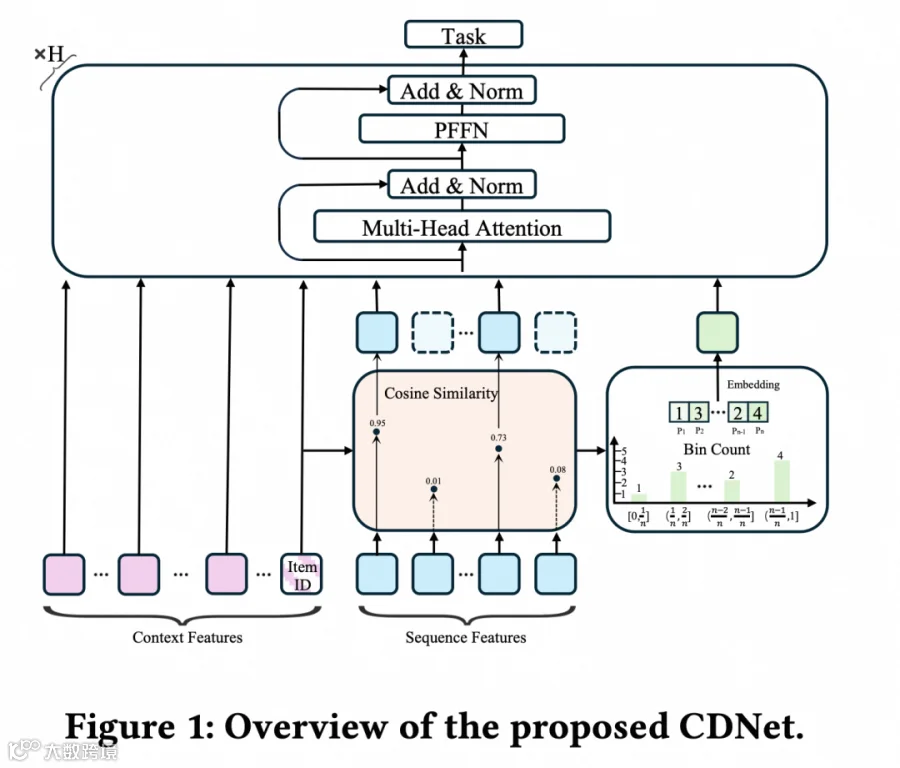
由于全长序列既带来平方注意力开销,又引入无关行为的噪声,CDNet 不再把完整的 L 长度行为序列连同全部上下文特征一起塞进 Transformer,而是对用户历史行为序列构建两个视角,与非序列上下文特征拼接后,通过统一的特征交互层建模,预估点击率。
2.1 细粒度核心行为建模(Fine-grained Core-Behaviors Module)
相关性打分。 先用目标商品表征 与每个行为表征 的归一化余弦相似度打分:
其中 把余弦相似度平移缩放到 ,保证分数非负——这是为后一个模块的直方图分桶服务的。由此得到分数序列 。
可微的核心行为选择。 取 top- ( )个行为。问题在于:离散的 top- 选择不可微,梯度无法回传。
Solution:直通估计器(Straight-Through Estimator, STE)。
● 前向传播: 用二值掩码 选出 个行为,保证推理高效;
● 反向传播: 把离散掩码替换为连续分数 ,梯度可以流回全部 个行为,打分网络 得以端到端训练。
为 stop-gradient。这样前向是"精确的稀疏选择",后向是"平滑的全序列梯度",兼得效率与可学习性。
2.2 全局兴趣分布模块(Global Interest-Distribution Module)
核心行为模块回答的是"哪些行为最相关、它们给上下文特征提供了什么信息"。但它留下了一个结构上正交、同样重要的问题:用户的整段历史在多大范围内与候选商品吻合?
设想两个用户:他们的 top- 核心行为完全一致,但一位用户的全部历史都密集集中在候选商品所属品类,另一位只是在漫长的无关历史中零星有几个相关行为,两者的点击倾向根本不同。这种"全局兴趣强度"信号与核心行为语义正交,无法从任何被选中的行为子集中推断出来。
CDNet 用一个覆盖全序列的紧凑相关性直方图来捕捉全局兴趣分布:
-
分桶: 把 均匀切成 个等宽区间 , ;
-
计数: ,得到直方图 。它编码了用户历史是"扎堆在高相关区间"还是"散落在低相关区间";
-
映射: 每个计数经可学习 embedding 查表后取平均, 。
即"全局兴趣分布 token",代表用户完整历史与候选商品的整体吻合模式。它与核心行为一起,作为额外 token 送入后续交互层。这个 token 的表达力与 无关:无论序列是 256 还是 1600,它始终只占一个token。被丢弃的行为并没有"消失",而是被压进了一个全局校准信号里。
2.3 特征交互与预测层
token 序列 经 层标准 Transformer(MHA + LayerNorm + Per-token FFN)处理后,取输出 做mean pooling过 MLP 与 sigmoid 得到 ,用标准二分类交叉熵训练。
复杂度分析:CDNet 的自注意力作用在 个 token 上,每层复杂度 ;相较之下,OneTrans 等全展开方法需要 ,其中, 是序列总长度。
3. 实验
3.1 数据集与设置
- Taobao
:公开数据集,约 8900 万条记录。按用户点击时间序构建行为序列,取最近 600 个点击商品作为序列特征。 - Industrial
:Lazada推荐广告TH的数据,含 70 亿次用户交互,行为序列最长达 1600。 - 指标
:AUC、GAUC、LogLoss。 - 基线
:覆盖两大范式。(1) 聚合式三种聚合策略(Mean / Target-attention / Self-attention Pooling)× 五个骨干(DCN、AutoInt、Hiformer、Wukong、RankMixer),共 15 个组合;(2) 全展开式:InterFormer 与 OneTrans。 - 实现细节
:核心行为数 k=16,相似度区间数 n=5;Taobao 序列长度 600,工业数据集 256。
3.2 总体表现
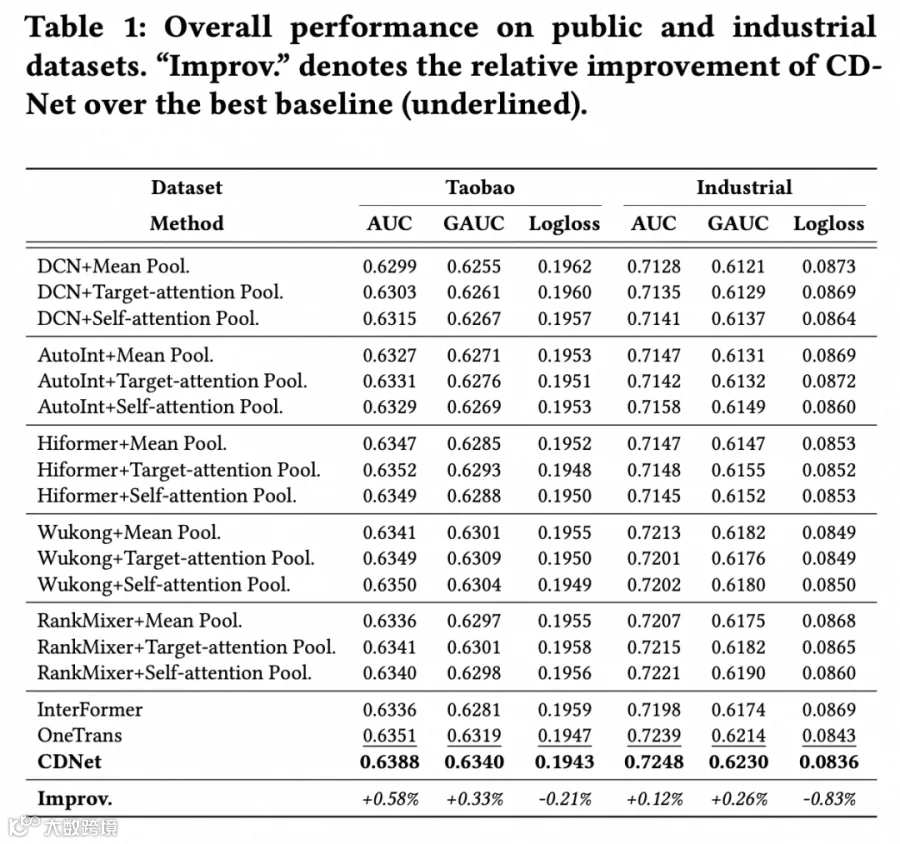
CDNet 在两个数据集的所有指标上均取得最优:
3.3 消融实验
-
去掉核心行为造成最大的性能下滑,说明"最相关行为与上下文特征之间的精细语义交互"是精度收益的主要来源; -
去掉全局分布 token 同样在所有指标上一致下降,证明全局兴趣强度信号是序列-上下文交互中独立且必要的输入;

3.4 超参分析
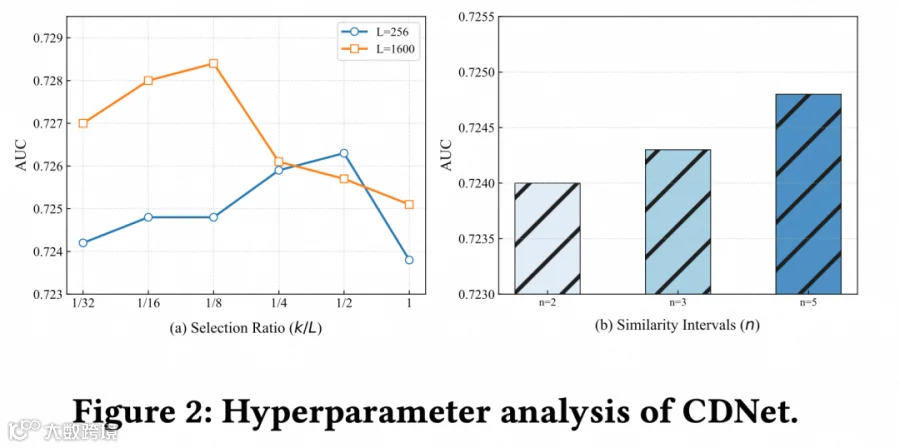
- 选择比例 k/L
:在 L ∈ {256, 1600} 两个量级下,k/L = 1(用全序列)始终次优,印证无关行为引入的噪声会损害模型;性能在中间比例达到峰值,验证了核心行为选择机制的必要性。两种序列长度下的最优比例接近,说明该选择机制对序列长度稳健。 - 区间数 n
:分桶越细(n 越大)性能越好,表明对相关性分布更细粒度的编码,能帮助模型更准确地刻画用户兴趣强度。
3.5 线上实验
在Lazada推荐广告10 天线上 A/B效果:使用长度 1600 的行为序列、k=100,CDNet 取得 2.24% 的 CTR 相对提升。
4. 关于我们
我们是阿里国际-智能技术-Lazada推荐广告算法团队,我们致力于融合前沿深度学习、生成式推荐、用户超长序列建模、多场景建模、大模型算法等技术构建工业级推荐大模型,通过更深刻地洞察用户个性化偏好与决策逻辑持续助力商家投放效益与平台收益的快速增长。近年来,我们在前沿算法领域持续深耕,已经在WWW、SIGIR、CIKM、WSDM、RecSys、ICDE等顶级学术会议发表了多篇高质量论文。也欢迎感兴趣的同学加入我们,共同开创AI推荐的新篇章。

点击上方名片,关注我们吧~