

小米大模型核心团队(LLM-Core)在 arXiv 上公开了一项重磅研究成果——《HySparse2: Hybrid Sparse Attention with Two-Level KV Sharing》。与此同时,团队负责人罗福莉在社交媒体上正式宣布:小米下一代旗舰大模型 MiMo-V3 将采用全新的底层架构,而今天亮相的 HySparse2 正是该架构的核心基石。
这篇论文针对当前智能体(Agent)和大模型在长上下文推理中所面临的严峻挑战,提出了一种结合两级 KV 共享(Two-Level KV Sharing)与细粒度 Token 稀疏注意力的革命性模型架构。
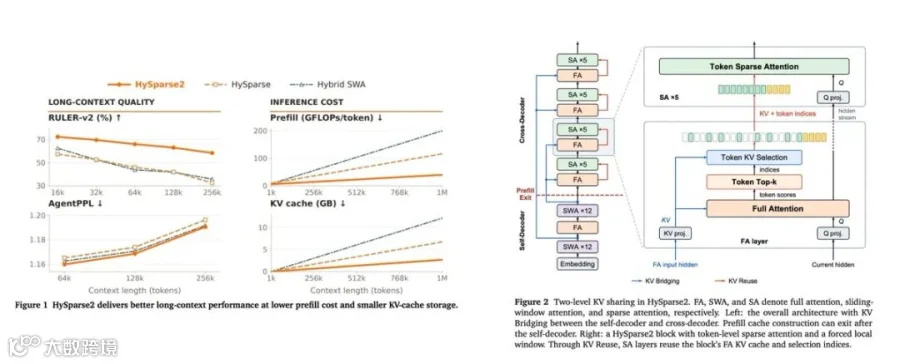
在 100 万(1M)Tokens 的极限上下文测试中,相较于 MiMo-V2.6 采用的 Hybrid SWA(混合滑动窗口注意力)架构,HySparse2 实现了惊人的“三全其美”:
这项研究不仅揭示了 MiMo-V3 未来的架构路线,更深入回应了整个大模型行业在走向真实智能体应用落地时的最大瓶颈。
为什么 Agent 时代必须重构注意力架构?
在传统的多轮对话中,用户输入通常很简短,模型的输出也相对线性。但当大模型化身为能够调用工具、执行代码、浏览长文档的 自主智能体(Agent) 时,计算负载的底层特征发生了根本性变化。
在长程(Long-horizon)与多轮交互的 Agent 任务中,模型往往呈现出这样的运行规律:
这种独特的负载,将当前以标准注意力机制为基础的模型推入了三大死胡同:
小米团队提出的 HySparse2,正是专为击穿这一三角困境而打造的解决方案。
核心机制拆解:什么是“两级 KV 共享”?
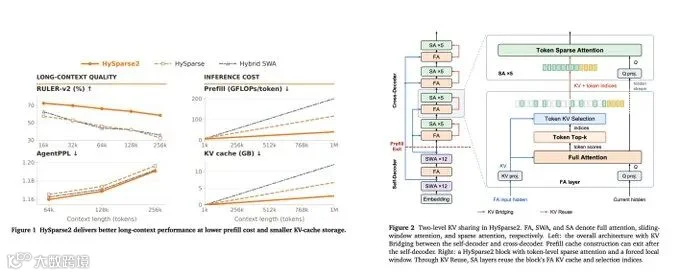
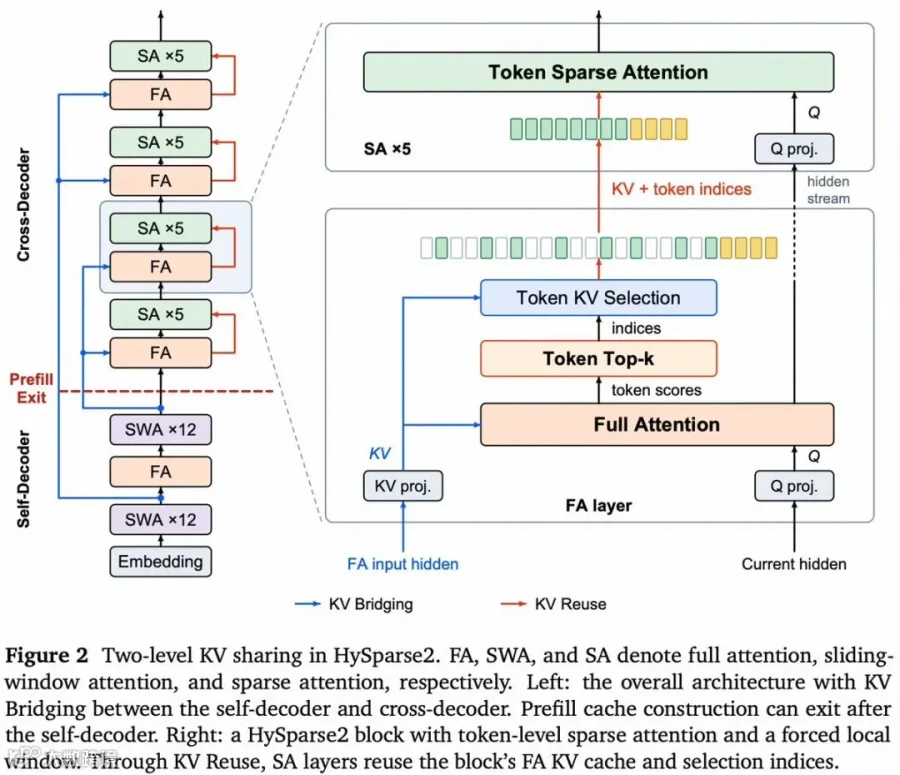
HySparse2 架构最精妙的突破,在于将 KV Cache 的共享与复用解构为外层(宏观结构跨层桥接)与内层(微观块内稀疏复用)两级机制。
1. 外层:KV Bridging(跨解码器桥接,让 Prefill 提前退出)
在宏观骨干网络设计上,HySparse2 借鉴了微软此前提出的 YOCO 架构理念,将整个 Transformer 解码器划分为前后两大连续阶段:
与常规做法不同的是,HySparse2 实现了 KV Bridging(KV 桥接): Cross-Decoder 中的全注意力层不再从自身输入中重新计算 Key 和 Value 矩阵,而是直接借用 Self-Decoder 对应全注意力层输出的隐藏状态(Hidden States),通过各自独立的线性投影矩阵快速生成所需的 K/V 缓存。
这一机制带来了极为强大的工程优势:预填充提前退出(Prefill Early Exit)。 在处理长输入文本时,模型只需要前向传播完前半部分的 Self-Decoder,就可以直接计算并生成后半部分 Cross-Decoder 所需的全部 K/V 缓存!换句话说,在 Prefill 阶段,模型完全可以直接跳过 Cross-Decoder 的所有网络层。
在工业级推理部署中,这尤其利好“预填充与解码解耦”(PD 分离)架构: 以论文测试的 49 层模型为例,负责 Prefill 的算力节点只需要加载前 25 层网络及 KV 桥接投影,无需常驻后 24 层的参数与计算,不仅使计算复杂度腰斩,更为计算节点节省了巨大的内存开销。
2. 内层:KV Reuse(稀疏层全面复用,且全面升级为 Token 级细粒度)
除了外层的宏观桥接,HySparse2 在后半部分的稀疏注意力块中延续并革新了第一代 HySparse 的 KV Reuse(KV 复用) 核心理念,并作出了两项关键进化:
进化一:用 Token-level 稀疏替代 Block-level 稀疏
以往的稀疏注意力设计大多采用固定大小的“块选择”(Block-level Sparsity,例如以 64 或 128 个 tokens 为一个单元进行筛选)。这种粗粒度设计虽然在硬件张量计算上友好,但存在严重缺陷:为了保留块内某一个关键信息 token,不得不连带存入数十个毫无意义的噪声 token。
在 Agent 工具调用日志中,关键信息往往高度孤立。HySparse2 将其彻底改造为逐 Token 粒度的细粒度筛选(Token-level Sparsity),让注意力注意力预算完全集中在真正重要的具体 Token 上,显著提升了信息信噪比。
进化二:移除独立分支,引入强制局部窗口(Forced Recent Window)
在第一代 HySparse 中,稀疏层内部并存着一个独立的滑动窗口分支,导致局部特征与全局稀疏检索需要维护两套独立的缓存与流转逻辑。
HySparse2 巧妙地移除了独立的 SWA 分支,改为在稀疏检索集合中强制纳入最近的 128 个 Token 作为滑动窗口,同时结合注意力打分挑选出最多 1024 个高相关性的全局 Token。这样一来,局部邻近上下文与全局远距离记忆被完美归一到同一个共享 KV Cache 中,结构更加简洁轻量。
严谨实验:5.02 倍加速与 4.5 倍显存压缩
为了全面评估 HySparse2 的真实表现,小米团队在拥有 800 亿总参数、单 Token 激活 30 亿参数的混合专家模型(80B-A3B MoE)上进行了系统性的端到端对比评测。
1. 极致的吞吐与显存效率
在 1M(100万)Tokens 的长上下文规模下,HySparse2 的计算与内存效率展现了断层式优势:
这意味着在同等硬件集群配置下,服务提供商不仅能以更低的首字延迟响应请求,还能将并发批处理容量(Batch Size)提升数倍,大幅压缩商业落地成本。
2. 越长越强:长文本与检索能力反超全注意力
模型算力与显存的大幅削减,往往容易引发对“模型理解力是否缩水”的担忧。然而,经过约 1000 亿(100B)Tokens 的长文本后训练(扩展至 256k 上下文)之后,HySparse2 在各项标准评测中不仅没有退化,反而大幅超越了基线模型:
|
|
|
|
|
|---|---|---|---|
| MRCR-v2 平均得分 | 大幅领先 |
|
|
| RULER-v2 平均得分 | 大幅领先 |
|
|
| 256k 极限上下文 RULER-v2 | 58.45 |
|
|
| AgentPPL / LongPPL(困惑度) | 各长度下均最低 |
|
|
在最具挑战性的 256k 上下文 RULER-v2 检索基准上,HySparse2 拿下了 58.45 分的高分,而前代 HySparse 仅为 32.61 分,Hybrid SWA 仅为 35.74 分。这表明细粒度的 Token 稀疏检索能够极其精确地捕捉到分散在长文本深处的关键证据。
3. 消融实验证明架构决策的有效性
论文作者们针对核心设计做出了详尽的消融分析:
此外,团队还在更大规模的 290B-A8B(总参数 2900 亿,激活 80 亿)模型上验证了扩展性。实验证明,随着模型参数体量成倍扩大,具有 KV Bridging 的架构在 MMLU、TriviaQA、代码困惑度等核心能力上与密集基线保持高度一致,展现了极强的泛化能力。
结语:迈向下一代原生 Agent 大模型
长上下文能力的竞赛,正在从早期的“单纯拼窗口数字大小”,转向“真实长文本负载下的算力效率与推理吞吐”。
小米 LLM-Core 团队在 HySparse2 中展示的思路非常清晰:承认全注意力在长程关联建模上的重要性,但绝不盲目在每一层都重复做全量计算;通过两级跨层与跨块的 KV 复用,将昂贵的计算压缩到少数关键节点,再用高精度的 Token 稀疏注意力和提前退出机制解决效率难题。
正如罗福莉团队所预告的,HySparse2 将成为小米下一代旗舰大模型 MiMo-V3 的核心技术底座。随着该论文的公开与后续工程实现的成熟,这种针对 Agent 真实负载设计的创新架构,或将为下一代高效、低成本、高精度的智能体应用开辟一条全新的演进路径。