

欢迎向本公众号投稿文献解读类原创文章,投稿邮箱:380198025@qq.com,请将稿件以附件形式发送。海内外招生、访学、招聘等稿件,请联系微信:xiongzhankun1997。
编辑 | 周慧嘉
审核 | 王紫嫣
摘要
研究背景
当前de novo protein design的一个核心瓶颈并不只是“能不能生成结构”,而是生成之后的有效率。以RFdiffusion为代表的扩散模型可以快速产生大量 backbone 或复合物候选,但真正通过严格in silico filters、值得进入实验验证的比例仍然较低。模型架构
1.两条互补的优化分支:Gradient-guided MCMC + Structure Cycling
RFO 是一个training-free、模块化的优化框架。每个外层optimization cycle中,系统会在两类mutation move之间进行选择:RF3 gradient branch 负责目标导向的局部修改,Boltz cycling branch负责基于独立结构假设的序列重新采样。论文默认两条分支以相同概率被选择。
-
Gradient branch:通过RF3的可微信心头和distogram head,把用户定义的目标函数对输入序列求梯度,再据此提出离散氨基酸突变。 -
Cycling branch:使用Boltz对当前序列重新进行全原子结构预测,再用ProteinMPNN或LigandMPNN对可设计位置做inverse folding,得到与预测骨架相容的新序列。

图 1 RFOptimization总体框架:从已有complex 出发,在gradient-guided MCMC 与cycling 两条分支之间交替优化。
2.如何绕过 RF3 diffusion 的不可微问题?
RF3的全原子坐标由diffusion module逐步去噪生成,如果直接穿过整个扩散过程反向传播,计算代价很高。RFO的做法是对diffusion module使stop-gradient,不通过采样坐标本身求梯度,而是从Pairformer trunk 上连接的confidence head和distogram head构建可微objective。
因此,梯度路径可以被理解为:objective→confidence/distogram →Pairformer→residue-type input。每次提出突变后,RFO都会把序列重新投影为真实的离散氨基酸序列,并重新执行RF3 featurization,使原子类型、连接关系和参考坐标与当前残基身份保持一致,而不是让序列停留在连续松弛空间中:
L_total = Σₖ λₖ Lₖ
其中不同的Lₖ可以来自confidence、distogram proxy或原子级几何约束。比如binder benchmark中主要使用mean interface PAE作为优化目标:
L_iPAE = Mean { Eᵢⱼ : Mᶦⁿᵗᵢⱼ = 1 }
这里Eᵢⱼ表示RF3给出的expected predicted aligned error,Mᶦⁿᵗ 用于选出跨链interface pair。因为RFO统一最小化loss,所以更低的interface PAE对应更高的复合物相对定位置信度。对于酶设计,则可以把pLDDT与特定催化原子之间的距离约束组合在同一个目标函数中。
3.GradMCMC:不是只接受“变好”的突变
如果每一步都贪心地选择当前最优突变,很容易卡在局部极小值。RFO因此把梯度引导与Metropolis-style MCMC结合:如果新序列使loss降低,就直接接受;如果loss暂时升高,也允许以温度相关概率接受,从而在优化早期保留探索能力。
ΔL = L(s′) − L(sᵗ)
P_acc = exp[ −ΔL / max(Tₜ, 10⁻¹⁰) ] (当 ΔL ≥ 0)
Tₜ = T₀ · 2⁻⁽ᵗ⁻¹⁾⁄ʰ
补充材料中的默认设置为T₀= 1.0、temperature half-life h = 40;随着温度逐步降低,搜索策略会从早期“允许跳出局部区域”逐渐转向后期的局部精修。默认的GradMCMC单次 proposal 最多改变1个氨基酸。
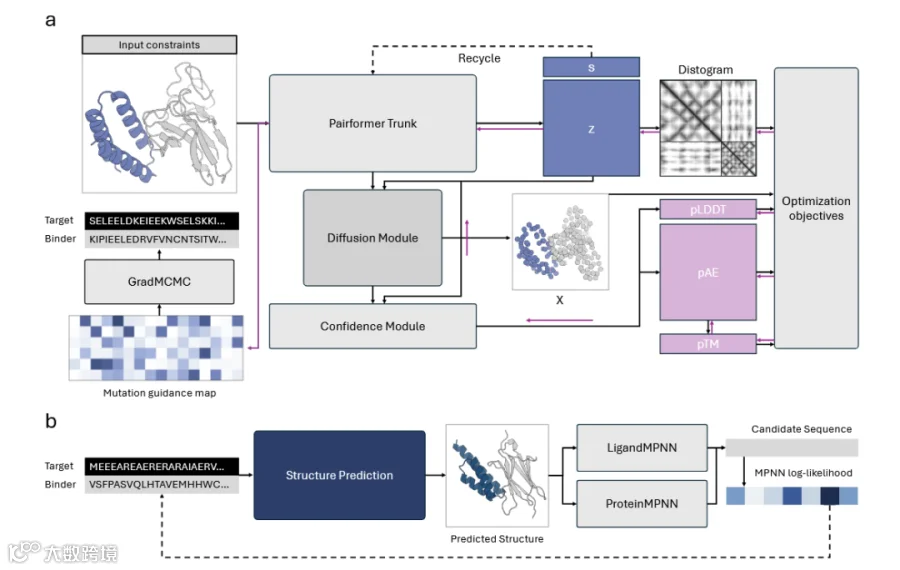
图 2 RFO 的mutation proposal pipeline:上方为RF3 gradient-guided mutation,下方为structure prediction + MPNN cycling。
3.GradMCMC:不是只接受“变好”的突变
如果每一步都贪心地选择当前最优突变,很容易卡在局部极小值。RFO因此把梯度引导与Metropolis-style MCMC结合:如果新序列使loss降低,就直接接受;如果loss暂时升高,也允许以温度相关概率接受,从而在优化早期保留探索能力。
ΔL = L(s′) − L(sᵗ)
P_acc = exp[ −ΔL / max(Tₜ, 10⁻¹⁰) ] (当 ΔL ≥ 0)
Tₜ = T₀ · 2⁻⁽ᵗ⁻¹⁾⁄ʰ
补充材料中的默认设置为T₀= 1.0、temperature half-life h = 40;随着温度逐步降低,搜索策略会从早期“允许跳出局部区域”逐渐转向后期的局部精修。默认的GradMCMC单次 proposal 最多改变1个氨基酸。
图 2 RFO 的mutation proposal pipeline:上方为RF3 gradient-guided mutation,下方为structure prediction + MPNN cycling。
4.可自定义 objective:从 binder confidence 到原子级催化几何
-
Confidence-based loss:例如 mean iPAE、pLDDT 等,用于提高模型对结构或界面的预测置信度。 -
Distogram-based proxy:例如跨链接触、链内接触和 interface distance entropy,用预测距离分布提供可微信号。 -
Atom-level geometric constraints:直接约束任意原子对之间的距离,适用于 enzyme active site、金属配位或共价相互作用等需要精确几何控制的任务。
实验结果
1.Protein–protein binder:平均成功率从 6.73% 提升到 22.31%
作者首先在13个此前用于binder design benchmark的蛋白靶点上测试RFO。初始候选由RFdiffusion生成,优化目标采用mean-iPAE;优化后再用未参与梯度或cycling的AlphaFold3独立refold,并以iPAE< 2.5、iPTM > 0.8作为最终通过标准。在最多10个optimization cycles后,平均成功率从6.73% 提升到22.31%,约为原来的3.3倍。部分靶点提升尤其明显:PDGFR 从17.5% → 50.0%,PD-L1从10.0% → 40.75%,FGFR2从0% → 28.0%,PD1从0% → 27.5%,VirB8 从0% → 27.25%。
2.Cyclic peptide:1.25% → 12.57%,约 10.1 倍提升
在GABARAP、MCL1、MDM2 和 RbtA四个cyclic peptide target上,起始scaffold来自 RFpeptides。相同的AF3 filter下,平均成功率从1.25%提升到12.57%。其中GABARAP从0%提升到24.12%,MCL1从0%到10.25%,MDM2 从3.75%到10.25%,RbtA从1.25%到5.63%。作者指出,不同target的提升幅度并不一致,说明 RFO并不是对所有pocket都能同样容易地优化;例如具有明确疏水LIR-binding groove的GABARAP在几何上更容易被局部优化。
3.Enzyme / atomic motif:同时优化全局折叠与催化几何
在24个atomic motif enzyme(AME)target上,RFO使用一个composite objective:一部分是催化残基之间的原子级几何约束,另一部分是结构置信度项。优化后24个target中有18个的composite fitness得到改善,同时所有24个target 的predicted substrate confidence都随优化提高。这部分实验体现了全原子模型的优势:优化对象不只是“这个蛋白像不像能折叠”,还可以直接指定“某几个催化原子之间应该保持什么距离”,让局部活性位点几何与整体scaffold quality同时进入搜索目标。

图 3 RFO 的in silico benchmark结果
4.三模型共识:降低“只会讨好一个 predictor”的风险效应
结构预测模型反向优化的一个常见风险是model hacking:序列可能只是学会提高某个predictor的confidence,而不是真正变得更可靠。RFO为此用RF3提供gradient、Boltz提供cycling,而AF3从不参与优化,只在最后作为独立evaluator。
5.计算效率:约 26 GPU-min 得到一个 consensus-passing design
在13个PPI target 上,作者进一步比较了获得一个通过三模型 consensus filter的设计所需的摊销GPU时间。在单张A100 上,RFO平均约26分钟得到一个通过候选;Protein Hunter 约为178分钟;论文给出的BindCraft对比约为 34 GPU-hours。
这也是本文最核心的工程意义之一:不是依赖更大规模的全局采样,而是把计算预算集中在已有候选附近做 targeted local optimization。主文报告单次RF3 优化迭代约需要45–60秒,通常1–10个iteration 就能看到明显改善。
讨论
首先,这篇工作的所有benchmark 都是in silico结果,目前并没有提供 wet-lab binding affinity、activity或实验成功率。因此,“通过AF3 /consensus filter”不能直接等价为“实验上一定能结合或有功能”。RFO 更准确的定位是提高计算筛选阶段的候选质量和效率。
其次,RFO是局部优化框架,它依赖起始seed的质量。如果初始backbone、binding pose或active-site topology本身已经非常差,少量residue mutation未必能够把它带到完全不同的结构区域。论文也明确把底层structure predictor的准确性和initial design quality列为当前限制。
另外,一个容易忽略的实现细节是:主文把iPTM列在可用confidence metrics中,但补充材料指出当前软件实现中的iPTM会被转换成Python scalar,因此目前并不是gradient-bearing objective。写代码或复现实验时,需要区分“模型能够报告的metric”和“真正参与反向传播的loss”。
从方法学上看,RFO更像是在protein design pipeline中增加了一个“refinement layer”:上游模型负责探索更大的结构空间,RFO则负责对筛选边界附近的候选进行快速、可定制的序列修补。未来如果上游生成质量和全原子预测模型继续提升,这类局部优化方法的价值可能会进一步放大。
论文
原文:https://www.biorxiv.org/content/10.64898/2026.09.04.749184v1
扫描二维码获取
更多精彩
AI in Graph
本公众号主要介绍应用于图、知识图谱的人工智能算法和研究进展,及其在生物信息、医学健康领域的应用。欢迎关注本公众号获取领域最新文献解读。

点个在看+赞支持一下