

Averill M. Law 是当今离散事件仿真领域公认的权威人物之一。

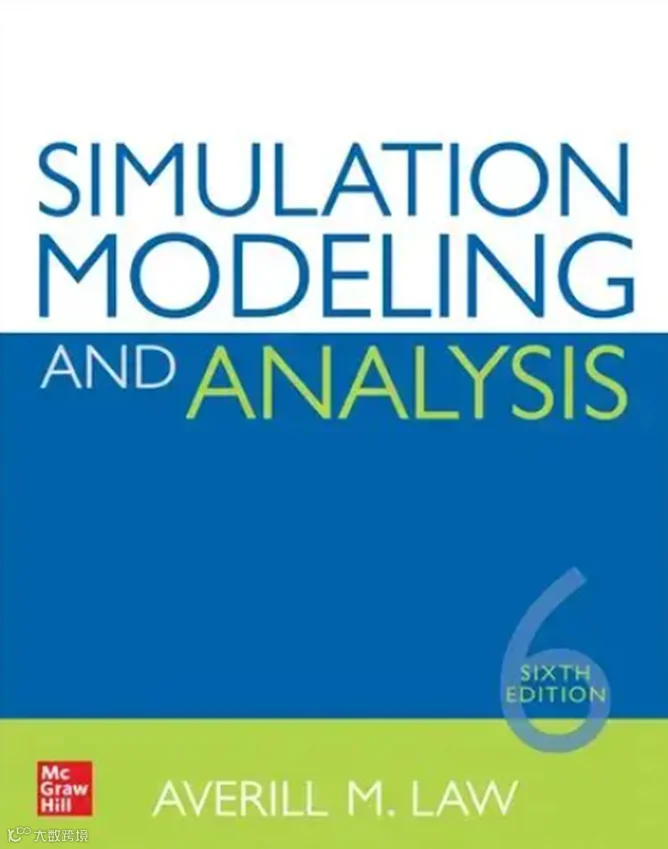
他同时也是仿真经典教程《Simulation Modeling and Analysis》的作者。
他已在 20 个国家讲授过 570 多场仿真或统计短训课程,客户包括:波音、卡特彼勒、可口可乐、通用电气、通用汽车、IBM、英特尔、洛克希德·马丁、洛斯阿拉莫斯国家实验室、NASA、北约、美国国安局、3M、UPS、美国空军、陆军和海军等。他也在国内开过培训班。
本文介绍他去年提出的仿真研究(simulation study)的十步法。
仿真研究(也可以叫基于仿真的研究 SBS)是一项复杂的系统分析活动,要求分析人员至少具备多学科的知识:仿真方法论(模型确认、输入概率分布的选择、仿真实验的设计与分析等)、概率论、统计学、项目管理,以及所研究系统的详细运作知识(如作战业务知识、交通流理论知识、气象知识、供应链知识、工厂内部物流知识、临床医学知识、力学材料学知识等)。虽然不同学科对仿真研究的定义不太一样,但都包括几个共同要素:以模型为媒介,强调对系统动态行为的再现,以受控实验方式组织,跨多个学科。
不幸的是,许多组织把仿真研究仅仅看作一项复杂的计算机编程工作。但实际上,在严谨的仿真研究中,模型的编程仅占全部工作的25%~50%。
造成这些认知缺失的原因,Averill Law 认为可能是因为仿真分析师所受的教育仅限于仿真软件供应商的培训,或者是因为他们仅学过一门侧重于如何使用某个特定仿真软件包的本科仿真建模课程。
即使仿真分析师学过一门全面的研究生水平的仿真课程,由于缺乏实际开展仿真研究的经验,仍然存在许多失败的可能。
此外,在仿真研究中很重要的问题定义和与管理者(包括决策者、管理人员和客户)定期沟通这类关键的项目管理理念,通常在大学课程中并不讲授,只能在工作中学习。
Law 为此给建模仿真人员设计了一套开展成功仿真研究的十步法。

这个十步法中提出的许多思想,源于他过去40多年间参加作者短期课程的7000~8000名仿真从业者和教授的实践经验。
仿真模型代码的编程只占正规仿真研究工作量的 25% 到 50%,而大量组织却把仿真当成复杂的编程练习——这正是仿真项目大量失败的根源。更悲催的是,仿真研究本身(而不是仿真研究项目交付团队)无缘无故就背了口大黑锅,被许多子个人认为没啥子用。
十步法实质上是在用结构化的可操作的流程纠正许多组织的这个认知偏差:真正的功夫花在仿真代码编程之前(问题定义、数据、假设文档)和编程之后(验证、实验设计、输出分析、结果沟通)。
读完本文,熟悉解决方案架构的童鞋会发现这十个步骤中的许多点,其实就是仿真研究项目解决方案交付要考虑的东西,因为里面会有项目目标、项目范围、进度计划、项目资源、假设、利益相关人之类的。
本文适合如下领域的读者:
建模仿真
数字孪生
AI4SE
任务工程
数字工程
试验鉴定
相关阅读
有人-无人编队杀伤链的仿真分析
适应性跨域杀伤网的建模和分析框架
深入理解数字工程中的模型管理,基于Web语义网和MBSE
深入理解数字航空和数字线程中的权威真相源与权威来源
深入理解数字工程中的权威真相源和权威决策
天基杀伤链的任务级试验鉴定:基于空间建模仿真和空间任务指标体系
任务为中心的CCA(协同作战飞机)设计优化:基于任务仿真和多学科
基于工程仿真元模型的系统工程多学科协同设计
体系仿真模型的九大设计原则
JADC2 战斗网络的概念设计、建模仿真和多学科协作
数字斗兽场:无人自主体系的建模仿真平台设计(上)
军用人工智能系统的试验鉴定:基于多保真度仿真模型
如何基于实验设计、遗传算法和作战仿真,生成作战行动方案
告别仿真模型的黑箱集成:如何重塑多学科联合仿真的未来
适应性跨域杀伤网的仿真优化理论介绍
建模仿真之道(一):混合模型的跨学科融合参考架构
建模仿真之道(二):本体在混合建模仿真中的应用
建模仿真之道(三):混合建模的设计模式
任务工程中的敏感性分析
任务工程 | 基于模型的任务架构设计指南
任务工程中的体系集成方法
高超声速飞行器的多保真度的代理模型构建方法
基于任务工程、系统工程、数字工程的体系作战能力的敏捷测试评估
下面我们来看这十个步骤。
第一步:定义问题并规划仿真研究
问题由管理者提出,但管理者最初发起研究时,问题往往没有被完全理解,也没有用量化语言表达。
因此这一步要允许并预期问题的迭代:随着研究推进、理解加深,新认识必须反馈给管理者,由管理者重新表述问题。
这个步骤的关键动作是召开项目启动会议(kick-off meeting)。
这个启动会上,所有利益相关者都必须到场:项目经理、仿真分析师、领域专家(SME)。
项目启动会上,甲乙双方要敲定六件事:
1、研究的总体目标;
2、研究要回答的具体问题——这决定模型细节的适当层次;
3、用于评估不同系统配置优劣的性能度量指标——不同的度量可能要求不同的模型细节程度;
4、模型的范围(scope)——是建模一个工厂还是公司旗下所有工厂;
5、要建模的系统配置——这决定仿真程序需要多大的通用性;
6、时间进度计划与所需资源(人员、计算机等)。
第二步:收集数据并定义模型
这是工作量最重的步骤之一,包含六个要点。
要点一,收集系统结构与运行规程的信息
没有任何个人或单份文档足以描述系统,必须与多位领域专家交谈。要警惕两类风险:有人提供的信息是错的甚至有意夸大(Law 举例:一家汽车工厂的维修部门夸大了某些机器的可靠性);系统运行规程可能根本没有成文。
要点二,收集数据以设定模型参数和输入概率分布
这个步骤会有两大典型错误:一是用主观臆断的均值替代整个概率分布——这会抹掉随机性对系统行为的影响;二是误用不合适的分布——正态分布意味着可能出现负值,均匀分布意味着区间内每个值等可能发生,而大多数仿真应用中这两种假设都不合理。
要点三,数据本身也要验证
一家石油公司提供的 857 个油轮装载时间中有一个明显的离群值,经实际操作人员确认是记录错误——模型逻辑要验证,喂给模型的数据同样要验证。
要点四,从现有系统收集性能数据,为第六步的模型验证做准备
要点五,选择模型细节程度
选择模型细节程度也就是模型的保真度,这是一门艺术。它取决于:项目目标、性能度量、数据可得性、可信性考量、计算机约束、领域专家意见、时间与资金约束。
要点六,坚持简约原则
仿真模型的元素与系统的元素之间不必一一对应。从简单模型起步,按需逐步细化,由领域专家和管理者评审判定每一版的充分性。不必要的细节会导致项目执行时间过长、错过截止日期,或掩盖真正重要的系统因素。
第三步:结构化走查假设文档是否有效
假设文档(assumptions document)把仿真模型假设、算法、输入参数、性能度量和数据摘要写成书面文件,要详细到能充当编写仿真程序的蓝图。
假设文档不同于概念模型(开发者的初步设想),也不同于需求文档(模型应该能做什么)。
假设文档更进一步,详细说明需求将如何被模型满足。
这个文档的内容应包括:项目目标与具体问题概述、流程图或布局图、条目化的子系统描述及交互关系、简化假设及其理由、模型局限性、数据摘要(样本均值、直方图等)、重要或有争议信息的来源。
Law 的经验判断是:大约 75% 仿真模型的假设文档写的不充分。
对假设文档的验证工具是结构化走查。
由于信息提供者往往忙于日常事务、难以全神贯注,模型建模工程师很可能得不到完整准确的系统描述,因此需要制度性的纠错机制:在面对分析师、领域专家和管理者的会议上,用大屏投影逐条展示假设文档——在所有人都认可当前条目正确且详略得当之前,绝不进入下一个步骤。
对假设文档的结构化走查,实践要点包括如下几点:
最好在外地(如酒店会议室)举行,以免被打扰;
必须在编程开始之前进行,避免大规模返工;
假设文档可提前发出征求大伙的意见,但不能替代走查本身——因为大家通常没时间或没动力自行细读,而现场互动本身价值巨大;
所有关键成员必须出席。
第四步:构建计算机仿真程序并验证
建模编程工具选择有两条路:通用语言(C++、Java、Python、Julia、R、Matlab)或专用仿真软件(如AnyLogic、Arena、ExtendSim、FlexSim、Simio、AFSim、STK、SIMUL8)。
通用语言的优势是熟悉、控制力强、成本低甚至免费、执行时间可能更短(可完全针对问题定制);仿真软件的优势是大部分仿真功能已内置,编程时间短、项目成本低。
建模编程语言的选择应至少部分依据第三步产出的假设文档的要求。
随后是验证(verification)——确认假设文档被正确翻译成仿真程序。
验证方法包括:结构化走查仿真程序、使用跟踪或交互式调试器、借助动画观察系统行为。
第五步:做试运行
试运行是为下一步确认服务的过渡步骤——用初步运行产生可供比对的输出统计量。
第六步:验证编写的仿真模型代码是否有效
这是第二个显式判定节点,也是统计与工程判断交汇的地方。
路径一:与现有系统的输出比较。若存在正在运行的系统,比较模型与系统的输出统计量。
路径二:表面有效性(face validity)审查。无论有无现有系统,领域专家都应审查输出的统计量是否合理。
路径三:敏感性分析。确定哪些模型因子对性能度量有显著影响,从而需要仔细建模;不敏感的因素则可以简化。
第七步:仿真实验设计
这一步本质上是把统计实验设计的科学方法引入仿真实验设计。
对每个感兴趣的系统配置,需要明确三件事:
每次仿真的运行长度;
预热期(warmup period)的长度(若关注稳态性能度量指标)——预热期的初始化偏差必须在统计估计中剔除;
独立重复运行(replications)的次数——只有使用不同随机数的多次独立重复,才能用置信区间对性能度量的真值做出统计上精确的估计。
第八步:做正式生产运行
用已验证的仿真模型对目标系统配置执行正式的生产运行,为输出分析提供仿真结果数据。
这一步的前提是模型已经过第六步的三重确认——跳过仿真模型验证直接做正式生产运行,是仿真研究实践中常见的失败原因。
第九步:分析输出数据
这个步骤的两个主要目标:确定某些系统配置的绝对性能;在相对意义上比较备选配置。
通常,一个或多个配置的仿真结果会启发新的配置设想——于是流程又回到第七步甚至更早。
这一步最需要向决策者传达的统计常识是:单次运行得到的数字不是真值。必须借助置信区间等统计方法,才能给出可信的性能度量估计。
第十步:记录、呈现并使用结果
最后一步把仿真成果转化为决策行动:完整的文档、面向管理者的清晰呈现、以及结果在决策中的实际使用。
相关阅读
有人-无人编队杀伤链的仿真分析
适应性跨域杀伤网的建模和分析框架
深入理解数字工程中的模型管理,基于Web语义网和MBSE
深入理解数字航空和数字线程中的权威真相源与权威来源
深入理解数字工程中的权威真相源和权威决策
天基杀伤链的任务级试验鉴定:基于空间建模仿真和空间任务指标体系
任务为中心的CCA(协同作战飞机)设计优化:基于任务仿真和多学科
基于工程仿真元模型的系统工程多学科协同设计
体系仿真模型的九大设计原则
JADC2 战斗网络的概念设计、建模仿真和多学科协作
数字斗兽场:无人自主体系的建模仿真平台设计(上)
军用人工智能系统的试验鉴定:基于多保真度仿真模型
如何基于实验设计、遗传算法和作战仿真,生成作战行动方案
告别仿真模型的黑箱集成:如何重塑多学科联合仿真的未来
适应性跨域杀伤网的仿真优化理论介绍
建模仿真之道(一):混合模型的跨学科融合参考架构
建模仿真之道(二):本体在混合建模仿真中的应用
建模仿真之道(三):混合建模的设计模式
任务工程中的敏感性分析
任务工程 | 基于模型的任务架构设计指南
任务工程中的体系集成方法
高超声速飞行器的多保真度的代理模型构建方法
基于任务工程、系统工程、数字工程的体系作战能力的敏捷测试评估
